Lecture 5
Abstract. 我们用可行前缀与 FIRST/FOLLOW 集合判断移入和规约,通过三道测验理解项目 NFA 与集合传播,再分析两类冲突及优先级、结合性的作用,最后用 Bison、Flex 和 C 数据结构直接构造抽象语法树。
我们先问一个问题:从左到右读一个表达式,读到 ID + ID,后面还有一个 *,现在应该先把加法归成一个整体,还是继续读乘号?这一步看起来很小,却决定了我们最后得到的是 (ID + ID) * ID,还是 ID + (ID * ID)。语法分析器既要判断这个串能否推出来,也要知道每一步应该怎样走。
我们先把国庆前的移入规约分析接起来,再用三个小题检查两个判定方法,最后把这些决策落实到一个能够构造抽象语法树的 C 程序中。
1. 扫描线两侧分别保存什么
我们用竖线 | 表示扫描线。右边是还没有读入的 token,全部都是终结符;左边是已经移入、并且可能经过若干次规约的部分,因此可以同时出现终结符和非终结符。
移入就是把右边紧邻扫描线的一个 token 移到左边。例如:
F | * ID → F * | ID
规约则依据产生式,把右部替换成左部非终结符。它只能发生在扫描线左侧紧贴扫描线的区域。例如由 F → F * G 得到:
F * G | → F |
这里的限制很关键。我们不能越过扫描线左侧的其他符号,随意规约更靠左的一个子串。移入一个乘号之后,前面的 E + E 就暂时离开了能够规约的位置。
继续使用之前消除优先级和结合性歧义的文法:
E 表示加法层面的表达式,F 表示乘法层面的表达式,G 表示一个基本项。对于 ID * (ID + ID),开始几步是:
| ID * ( ID + ID )
ID | * ( ID + ID )
G | * ( ID + ID )
F | * ( ID + ID )
F * | ( ID + ID )
为什么读到第一个 ID 后不能立刻再移入 *?因为 ID * 不是一个可行的扫描线左侧结构。ID 要先规约成 G;G * 也不可行,所以还要把 G 规约成 F。但到了 F | * ...,我们不能继续把 F 规约成 E:乘号不能紧跟在这套文法的 E 后面,于是应当移入乘号。
这正好用到了两个判定:一是左侧的结构能否继续参与合法分析,二是右边的下一个终结符能否跟在某个符号后面。前者由可行结构及其 NFA 判定,后者由 FIRST、FOLLOW 集合提供信息。
移入规约的规约次序,对应的是最右派生的逆过程。课件称它为“最左规约”:规约从左到右推进,反向展开时则每次展开最右边的非终结符。
2. 可行结构为什么能用项目 NFA 判断
2.1 分段不是任意切开
我们考虑扫描线左边的符号串,能否把它分成若干段,每段都是某条产生式右部的前缀,而且相邻段能够连接起来。具体说,假设第 段对应产生式 ,该段已经读入的是 。如果还需要下一段,那么把下一段产生式的左部 接在 后面,必须仍然是第 条产生式右部的前缀。
我们用点号标出这个“已经读到哪里”:
这叫一个项目。点号不是输入中的字符,只是我们的分析记号。空段也允许存在:例如 E → · F 已经读入的前缀是空串,但它说明我们正在等待一个 F。这里的空段不表示文法有空产生式。
这条项目链还必须从文法的起始符号出发:第一条产生式左部是起始符号,各段拼接后恰好覆盖待判定的左侧串。不能拿一组与起始符号无关的项目证明可行。下面示例以 E 为起始符号;若显式使用增广符号 START,就在链前增加空段 START → · E。
例如左边是 F * ( E +,可以依次对应:
E → · F
F → F * · G
G → ( · E )
E → E + · F
它们已读入的段分别是空段、F *、(、E +。F * 后面等一个 G,( 后面等一个 E,E + 后面又等一个 F;这条链能够连接,所以这个结构可行。
给出一条这样的链,就能证明“可行”。要证明“不行”,则需要排除所有分法。我们需要一种能够把所有候选情况都检查完的算法。
2.2 普通边移动点号,ε 边展开待读非终结符
我们把项目作为 NFA 的状态。若点号右边是符号 X,读入 X 就把点号向右移动一格:
若 X 是非终结符,还可以不读入任何符号,转到它的各条产生式的开头:
例如 F → F * · G 可以沿 ε 边到达 G → · ( E ) 和 G → · ID。这相当于新增一个空段,把下一层结构接进来。
初始状态是增广起点 START → · E,还要取它的 ε 闭包,也就是把不消耗输入能够到达的所有项目都加入状态集合。每读入一个符号,我们先沿对应的普通边移动,再取 ε 闭包。这里读取的是扫描线左侧的文法符号串,输入字母表包含非终结符,并不只是原始 token。
这台 NFA 的所有状态都是接受状态,因为我们要判断的是“到这里是否仍是一个可行前缀”,不要求某条产生式已经读完。只要读完整个左侧后还有状态存活,就可行;若状态集合为空,就不可行。
3. 三道 quiz:把判定方法真正算一遍
3.1 第一题:嵌套括号前缀可以怎样分段
第一题仍使用上一节的 E/F/G 文法,判断:
F * ( E + ( E + |
这个前缀是可行的。我们把完整的项目链写出来,特别注意其中的空段:
| 次序 | 项目 | 已读入的段 |
|---|---|---|
| 1 | E → · F |
空 |
| 2 | F → F * · G |
F * |
| 3 | G → ( · E ) |
( |
| 4 | E → E + · F |
E + |
| 5 | F → · G |
空 |
| 6 | G → ( · E ) |
( |
| 7 | E → E + · F |
E + |
把第三列拼起来,正好得到题目左侧。第 4 段等的是 F,而下一层括号表达式是 G,所以必须用第 5 段 F → · G 把它们接起来。直接从 E → E + · F 跳到 G → ( · E ),中间就少了一层。课堂在写这个分段时补上的,正是这个容易漏掉的空段。
题目还要求从定义出发,给右侧补一个终结符串,使整个串可以完成规约。补上:
ID ) )
于是得到:
F * ( E + ( E + | ID ) )
我们可以沿着下面的步骤完成它:
F * ( E + ( E + ID | ) )
F * ( E + ( E + G | ) )
F * ( E + ( E + F | ) )
F * ( E + ( E | ) )
F * ( E + ( E ) | )
F * ( E + G | )
F * ( E + F | )
F * ( E | )
F * ( E ) |
F * G |
F |
E |
这里每次规约都紧贴扫描线。最内层先收拢,外层再收拢,最后乘法和整个表达式依次完成。补终结符不是再造一个任意表达式,而是要满足当前各层正在等待的符号。
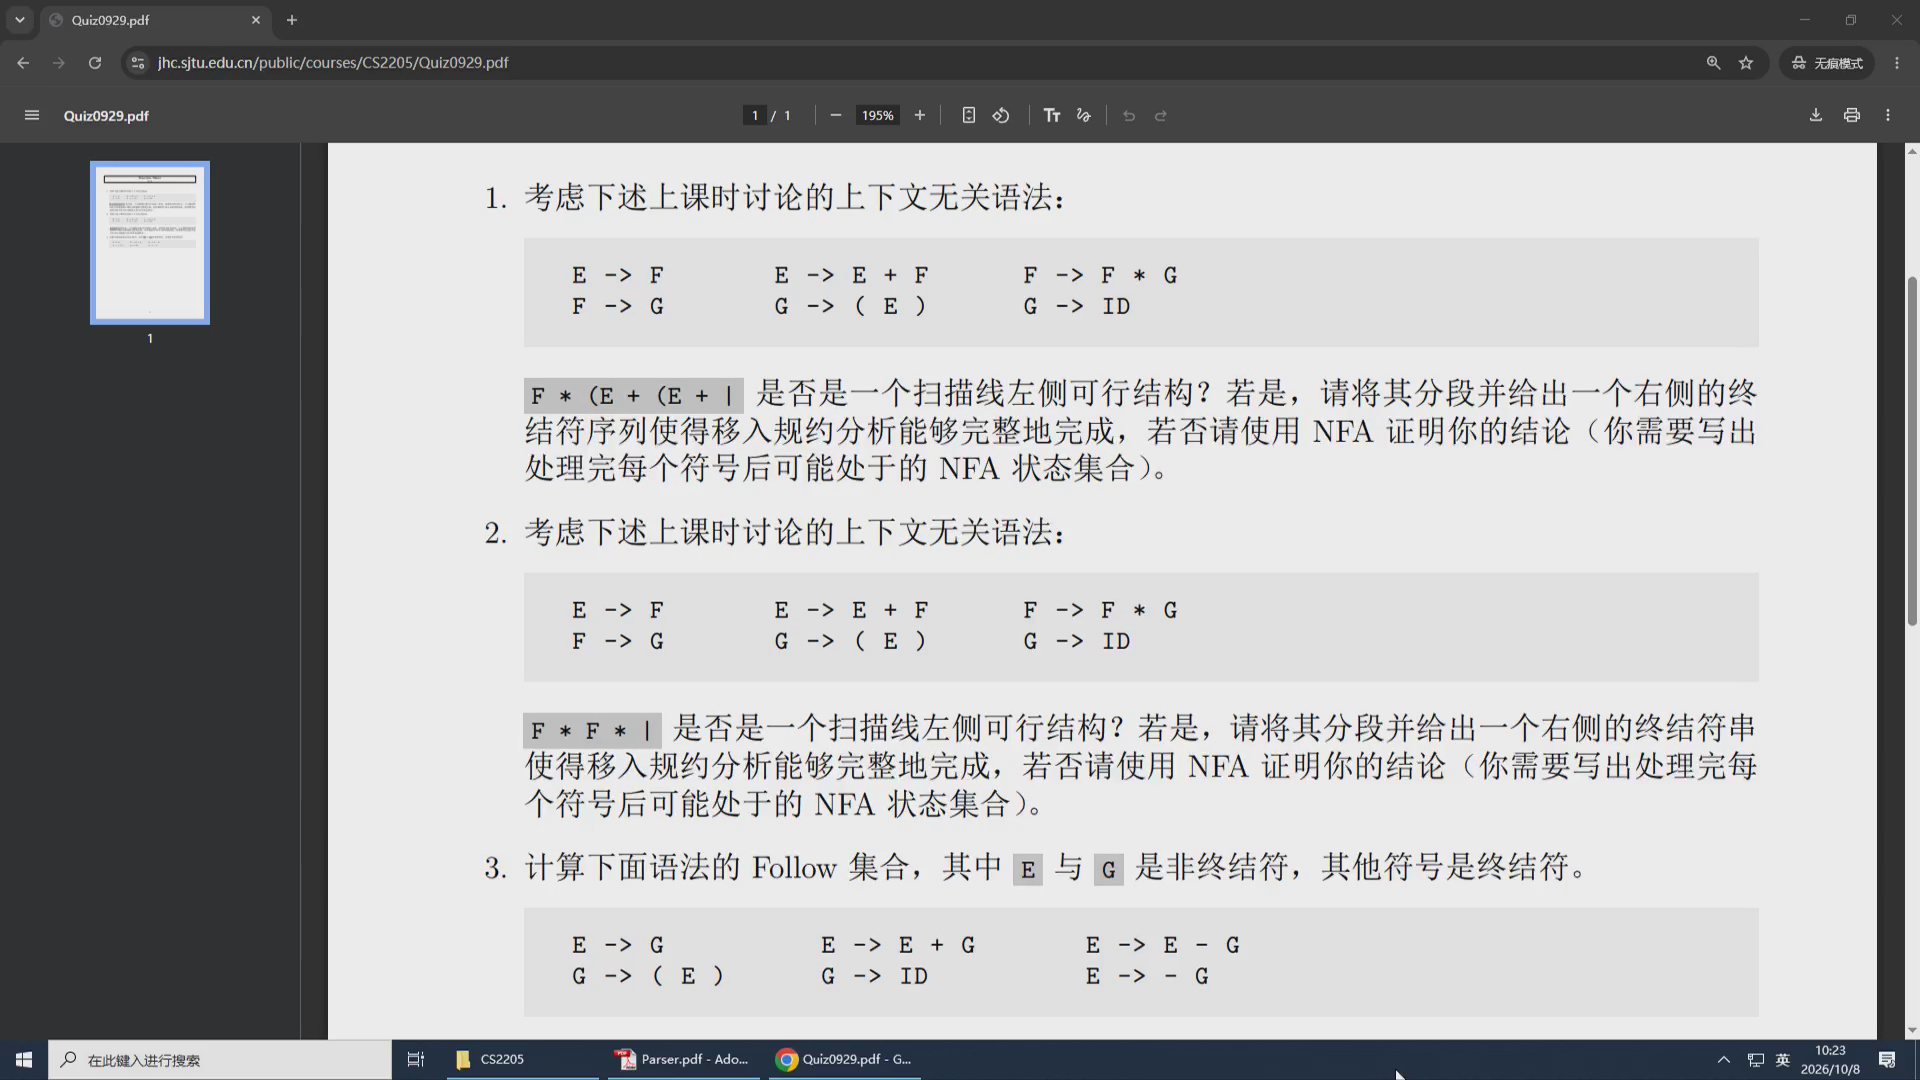
F * F *,第三题单独使用含负号的 E/G 文法。图中没有手写答案,完整分段与计算见正文。3.2 第二题:F * F * 的状态在哪一步消失
第二题判断:
F * F * |
它不可行。我们用 NFA 检查,而不是只凭直觉说乘号之后不能出现 F。
初始 ε 闭包是:
START → · E
E → · F
E → · E + F
F → · G
F → · F * G
G → · ( E )
G → · ID
读入第一个 F,还存活的是:
E → F ·
F → F · * G
再读入 *,第一条没有相应的边,第二条移动点号,并展开待读的 G:
F → F * · G
G → · ( E )
G → · ID
下一符号是第三个位置上的 F。这三个项目点号右边分别是 G、(、ID,没有一个是 F,所以此时状态集合已经变成空集。最后一个 * 不可能把空集“救活”。因此,失败发生在读入**第三个符号 F**时,而不是到第四个符号才失败。
这个题也提醒我们:F 和 G 都能最终代表一些表达式,并不表示在分析器的某个位置上可以把它们互换。当前产生式要求的是 G,我们就必须尊重这层结构。
3.3 第三题:先理解负号,再算 FIRST 与 FOLLOW
第三题给出另一套文法:
这里没有乘法,有加法、减法和一元负号。我们先问:它是否允许在任何一项前加负号?连续的加减运算由 E → E + G、E → E - G 展开,右边新加入的一项只能是 G;而 G 没有 G → - G 这条规则。因此只有当前这一层加减表达式的最开头,能通过 E → - G 带一个负号。
所以 - ID + ID 合法,ID + - ID 不合法,连续的 - - ID 也不合法。如果要在后面的项加负号,可以写 ID + ( - ID );如果要再取一次负,可以写 - ( - ID )。括号里的部分重新成为一个 E,因此又能使用 E → - G。这不是我们对数学符号的习惯,而是这套文法明确规定的语言。
FIRST:从一个符号开始展开,第一项可能是什么
对于一个文法符号 , 收集的是:能由 展开得到的符号串中,可能出现在最开头的终结符。用规约方向说,就是以该终结符开头的一串符号,有可能规约成 。
终结符不用再展开,所以:
例如 FIRST(+) 只有 +,不是“加号后面能跟什么”;后面能跟什么属于 FOLLOW 的问题。
对于产生式 ,把 加入 。我们反复应用这条包含关系,直到所有集合不再增长。当前文法没有 ε 产生式,也没有能展开成空串的符号,因此检查右部第一个符号即可。若文法允许空串,这个简式就需要扩展,要继续检查能够为空的前缀后面的符号。
先看 G:两条规则分别以 ( 和 ID 开头,于是:
再看 E:E → G 带来 FIRST(G),E → - G 带来 -。另外两条规则以 E 自己开头,只形成自包含约束,不会产生额外元素。因此:
FOLLOW:紧接在某个符号右侧的终结符
我们用 表示:在可以继续完成整体规约的上下文中,能够紧跟在 后面的终结符。当前课程的计算不仅给非终结符求 FOLLOW,也给终结符求 FOLLOW,因为相邻约束和末尾传播会用到它们。集合里的元素则始终是终结符,这对应扫描线右侧只看下一个 token 的设定。
在这套无空串文法中,有两条计算规则:
第一条看右部的相邻符号:Y 后面接着 Z,展开 Z 后可能最先出现的终结符,都能跟在 Y 后面。第二条看右部末尾:Y 是最后一个符号,整个右部规约成 Z 之后能跟什么,规约前的这个 Y 后面也能跟什么。第二条不是把左部的 FIRST 传过去,而是传 FOLLOW。
我们先把所有集合置空,再逐条加入约束。相邻位置给出:
E → E + G:把+放进FOLLOW(E),把FIRST(G)放进FOLLOW(+)。E → E - G:把-放进FOLLOW(E),把FIRST(G)放进FOLLOW(-)。G → ( E ):把FIRST(E)放进FOLLOW((),把)放进FOLLOW(E)。E → - G:仍把FIRST(G)放进FOLLOW(-),没有新元素。
这里一元负号和二元减号是同一个终结符 -,所以要合并到同一个集合中。
处理完相邻位置后,FOLLOW(E) 已经是 。接着处理产生式末尾:E 的各条规则都以 G 结尾,所以把 FOLLOW(E) 传给 FOLLOW(G);G → ( E ) 以 ) 结尾,把 FOLLOW(G) 传给 FOLLOW());G → ID 则把 FOLLOW(G) 传给 FOLLOW(ID)。再检查一轮,已经没有新元素。
最终答案如下:
| 符号 | FIRST | FOLLOW |
|---|---|---|
E |
{ (, ID, - } |
{ +, -, ) } |
G |
{ (, ID } |
{ +, -, ) } |
( |
{ ( } |
{ (, ID, - } |
) |
{ ) } |
{ +, -, ) } |
+ |
{ + } |
{ (, ID } |
- |
{ - } |
{ (, ID } |
ID |
{ ID } |
{ +, -, ) } |
我们可以用刚才对负号的解释检查表格:FOLLOW(+) 没有 -,符合加号后不允许直接出现负号;FOLLOW(() 有 -,符合括号里面可以重新以负号开头。把 +、-、) 都写到加号和减号的 FOLLOW 中,就把“完整表达式后面能跟什么”和“操作符后面需要什么”混在一起了。
这张表按课堂约定,不包含 EOF。编写完整解析器时,可以增广起始规则,把输入结束标记加入起始符号的 FOLLOW,再按末尾规则传播。
4. 两种判定仍然排除不了:冲突
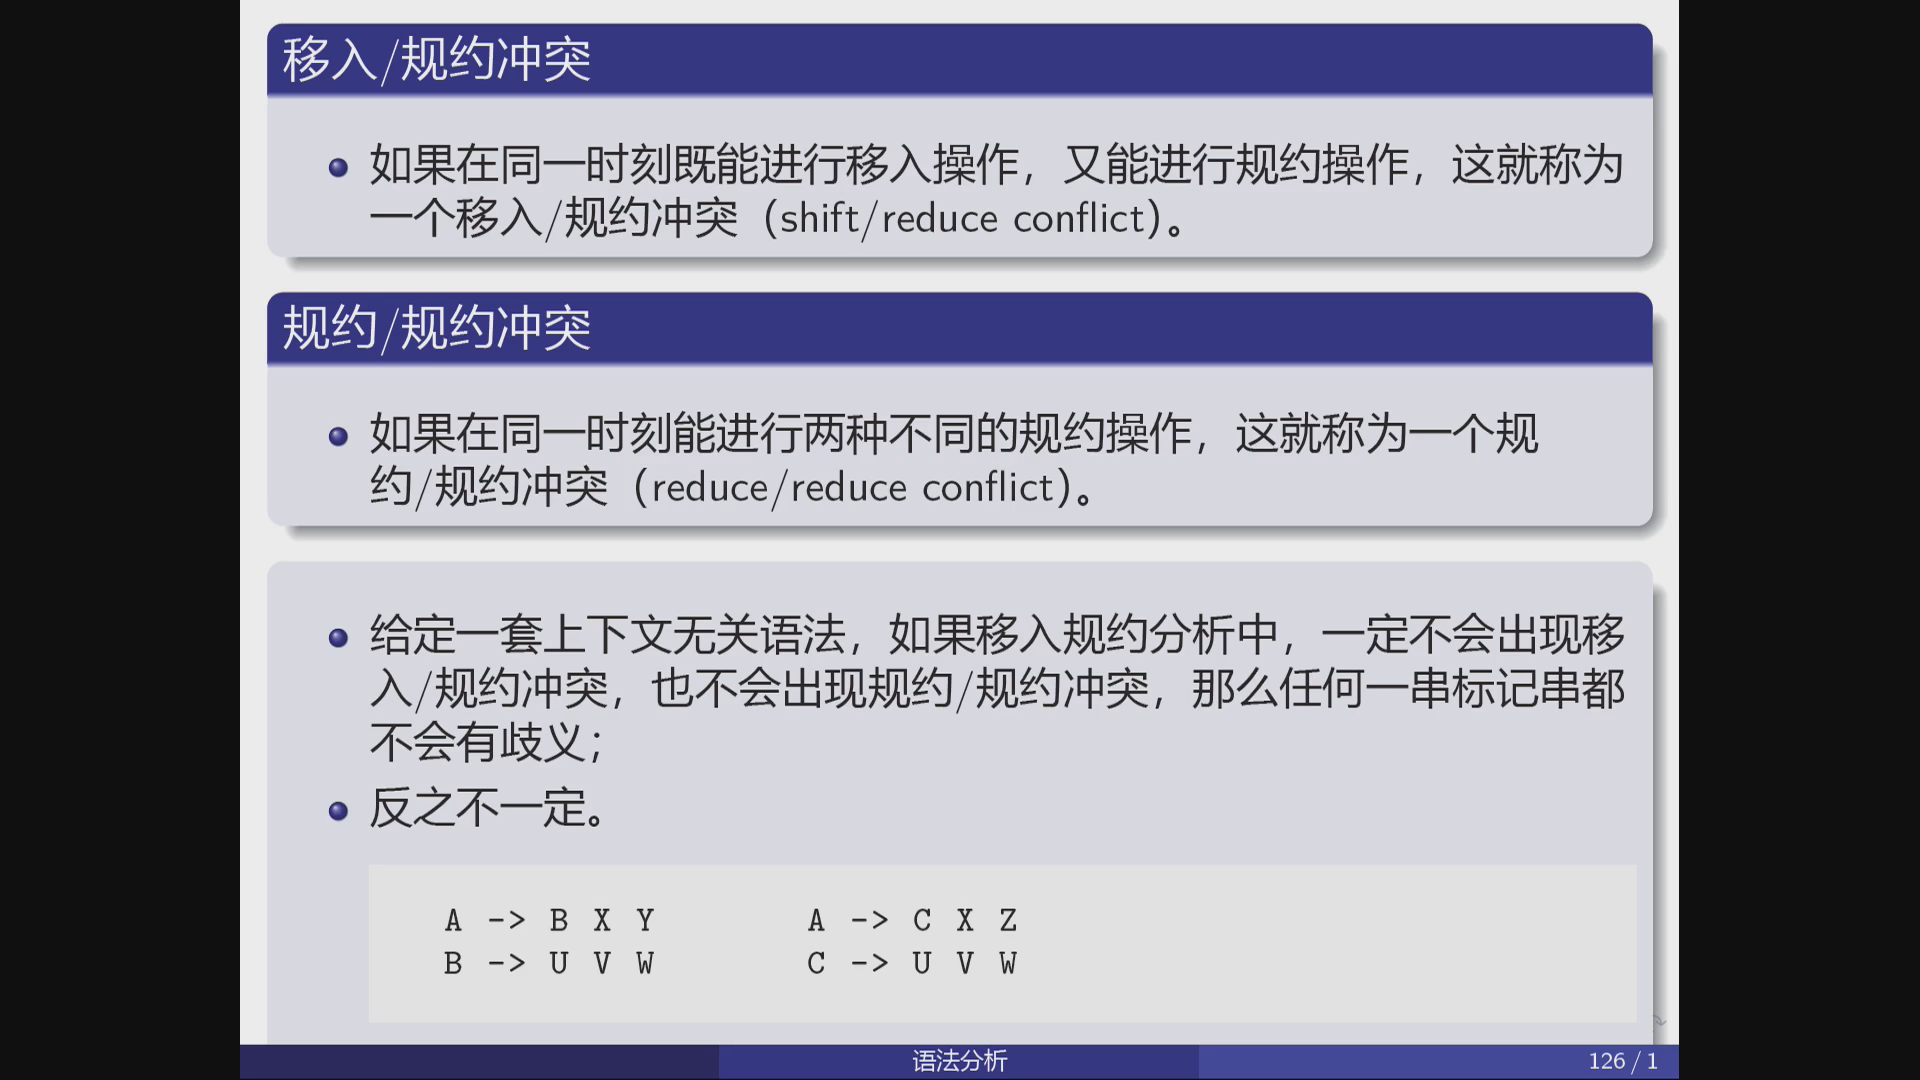
我们希望分析器每一步都有唯一的动作。若一个移入动作和一个规约动作都无法排除,就是移入/规约冲突(shift/reduce conflict);若两个不同的规约动作都无法排除,就是规约/规约冲突(reduce/reduce conflict)。我们先看冲突与歧义的关系。
4.1 有歧义的表达式会让两条分析路径分叉
考虑这套文法:
它没有区分加法和乘法的优先级,也没有规定连续同类运算的结合方向。对于 ID + ID * ID,既能构造加法在下、乘法在上的树,也能构造乘法在下、加法在上的树。
它的 FIRST(E) 是 ,FOLLOW(E) 是 。准备好这些信息之后,移入规约分析走到:
E + E | * ID
前面两处 ID 已各自规约成 E。现在我们有两种选择。
第一条路径先规约加法:
E + E | * ID
E | * ID
E * | ID
E * ID |
E * E |
E |
第一次规约形成加法子树,随后这个子树成为乘法的左孩子,所以结果是 (ID + ID) * ID。这个规约无法用 FOLLOW 排除,因为 * 确实属于 FOLLOW(E)。
第二条路径先移入乘号:
E + E | * ID
E + E * | ID
E + E * ID |
E + E * E |
E + E |
E |
移入后 E + E 不再紧贴扫描线,不能优先规约;后面的 E * E 先收拢成一个乘法子树,结果是 ID + (ID * ID)。这个移入也不能由可行结构排除,因为 E + E * 可以作为合法的分析前缀。
所以两个判定都没有给出唯一选择。这就是一个真实的移入/规约冲突。
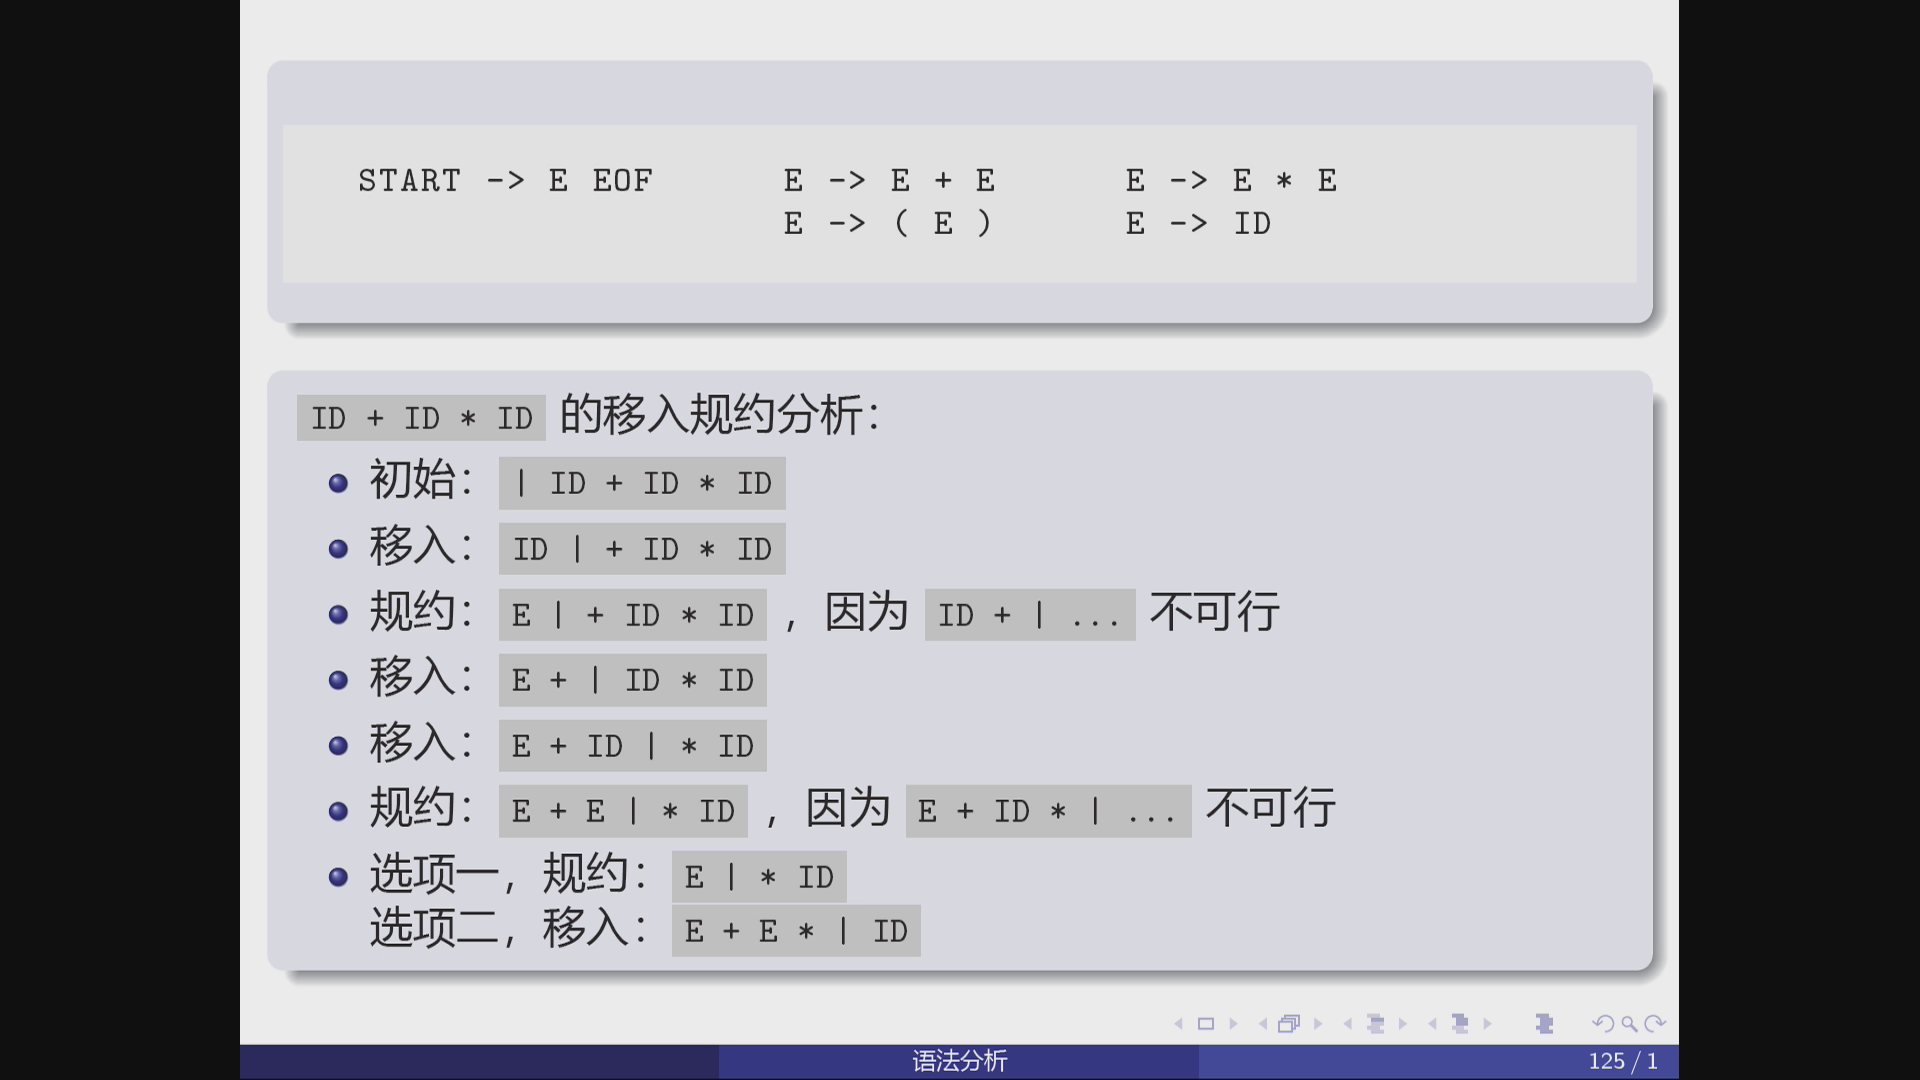
更一般地,同一个 token 串若有两棵不同的解析树,就有两条不同的最右派生,反过来就有两条不同的规约路径。它们从相同的输入出发,总会在某个位置分叉。因此,单靠这套未加消歧规则的文法,不能建立始终唯一的确定性决策。
但这句话不能反过来使用:**有歧义会导致冲突,有冲突不一定说明文法有歧义。**冲突还可能来自当前分析方法掌握的信息不够多。
4.2 无歧义的文法为什么也会规约/规约冲突
来看下面这个反例,起始符号为 A:
A/B/C 是非终结符,U/V/W/X/Y/Z 全部是终结符。这个文法只生成两个串:
对于第一个串,唯一的树是把 UVW 解释为 B,再把 BXY 解释为 A;对于第二个串,唯一的树是把 UVW 解释为 C,再把 CXZ 解释为 A。末尾 Y 与 Z 已经区分了两种情况,所以文法没有歧义。
然而我们分析第一个串,移入 U/V/W 后走到:
U V W | X Y
先排除继续移入。UVW X 不是可行结构:UVW 已经是 B 或 C 的完整右部,而上层规则需要的是 B X 或 C X,不是尚未规约的 UVW X。
于是必须规约,但规约成谁?UVW → B 和 UVW → C 都有产生式支持,规约后的 B 与 C 都是可行结构,而且:
只看右侧下一个 token X,就排除不了任何一个候选。这产生了规约/规约冲突。我们作为读者能看到后面的 Y,自然知道该选 B;但当前决策只使用左侧结构和一个向前看符号,尚未看到能够真正区分它们的信息。
我们目前用项目 NFA 判断左侧结构,用全局 FOLLOW 集合判断下一个 token。完整的 LR(1) 构造还会在项目中记录向前看信息。对于这个反例,两种规约后面都能跟 X,真正的分界在第二个待读符号 Y 或 Z 上。
4.3 把共同部分先收拢,延后区分
这个文法其实没有必要把完全相同的 UVW 过早分别命名为 B 和 C。我们引入一个公共的非终结符 D:
到 UVW | X ... 时,唯一的规约就是 UVW → D。之后继续读入 X,再看到 Y 或 Z,就可以完成对应的上层规则:
UVW | X Y  →  D | X Y  →  D X | Y  →  D X Y |  →  A |
UVW | X Z  →  D | X Z  →  D X | Z  →  D X Z |  →  A |
语言没有改变,但决定“共同前缀属于哪种上层结构”的时机变晚了。很多冲突可以通过这样的文法设计避免,不能见到冲突就断言语言本身有歧义,更不能只依赖分析器替我们随便选一条规则。
5. 优先级和结合性怎样决定移入还是规约
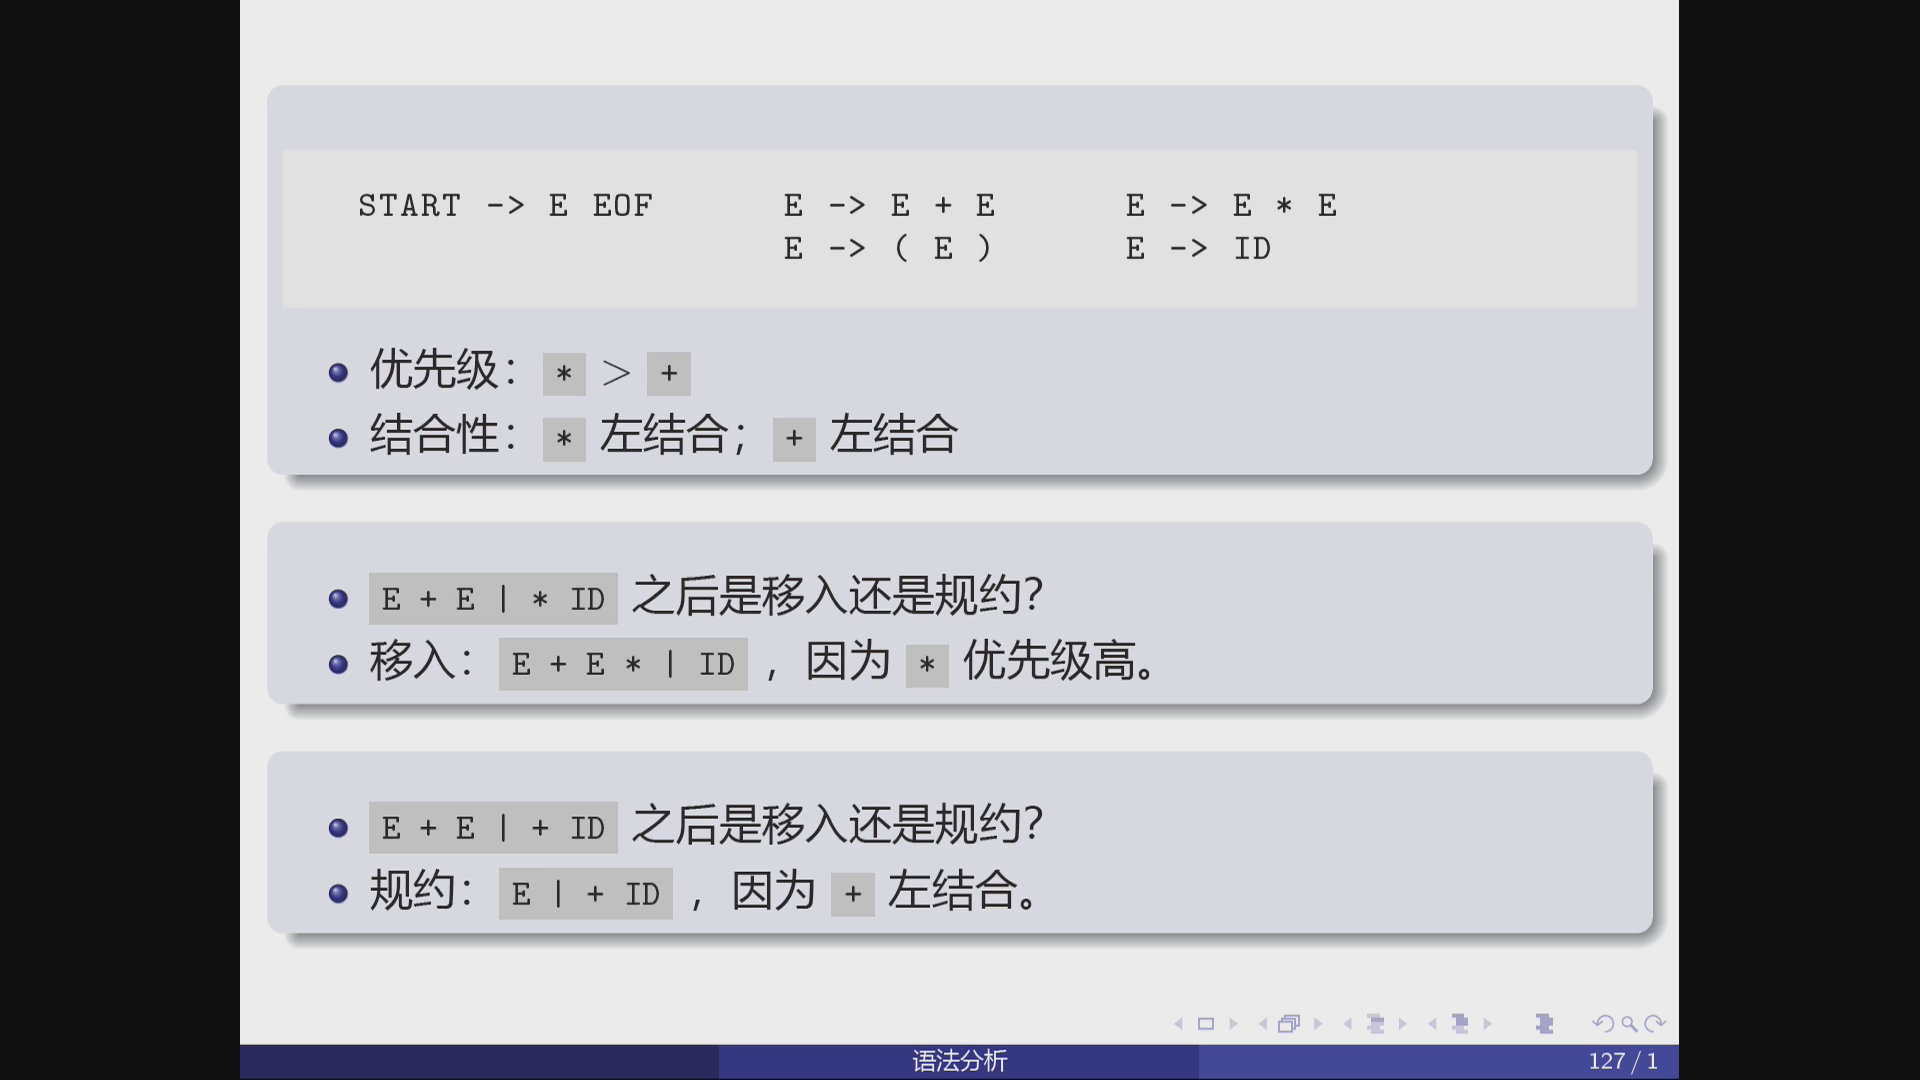
对于表达式,还有一种常用做法:继续保留简洁的 E → E + E | E * E | ...,但在上下文无关文法之外增加优先级和结合性。
设乘号优先级高于加号,加法和乘法都左结合。到:
E + E | * ID
候选规约的规则是加法,待移入的 token 是乘号。乘号优先级更高,所以选择移入,让右边的乘法先组成子树。
反过来,到:
E * E | + ID
候选规约属于乘法,待移入的是加号,这次乘法优先级更高,所以选择规约。
若两边运算符优先级相同,就由结合性判断。例如:
E + E | + ID
左结合要求先形成左边的加法子树,于是规约;右结合则要求把右边运算接进来,于是移入。对于非结合的操作,同等级的这种连续使用可以判为错误。
注意,增加声明并不会把原来的 CFG 本身变成一套无歧义 CFG;我们给解析器增加了选择规则,使它在原本的候选树中按约定选择。也可以像以前一样引入 E/F/G 分层,把优先级和结合方向直接写进文法。两种方式都值得掌握,选择取决于规则是否清楚、后续维护是否方便。
6. Bison 的输出目标:直接构造 AST
现在我们把算法变成程序。Bison 的输入是 .y 文件,里面写上下文无关文法、优先级、结合性以及语义动作;它输出 .c 文件,也就是用 C 实现的语法分析器。与 Flex 从 .l 生成词法分析器相似,.y 不是可以直接交给 C 编译器编译的源文件,必须先经过 Bison。
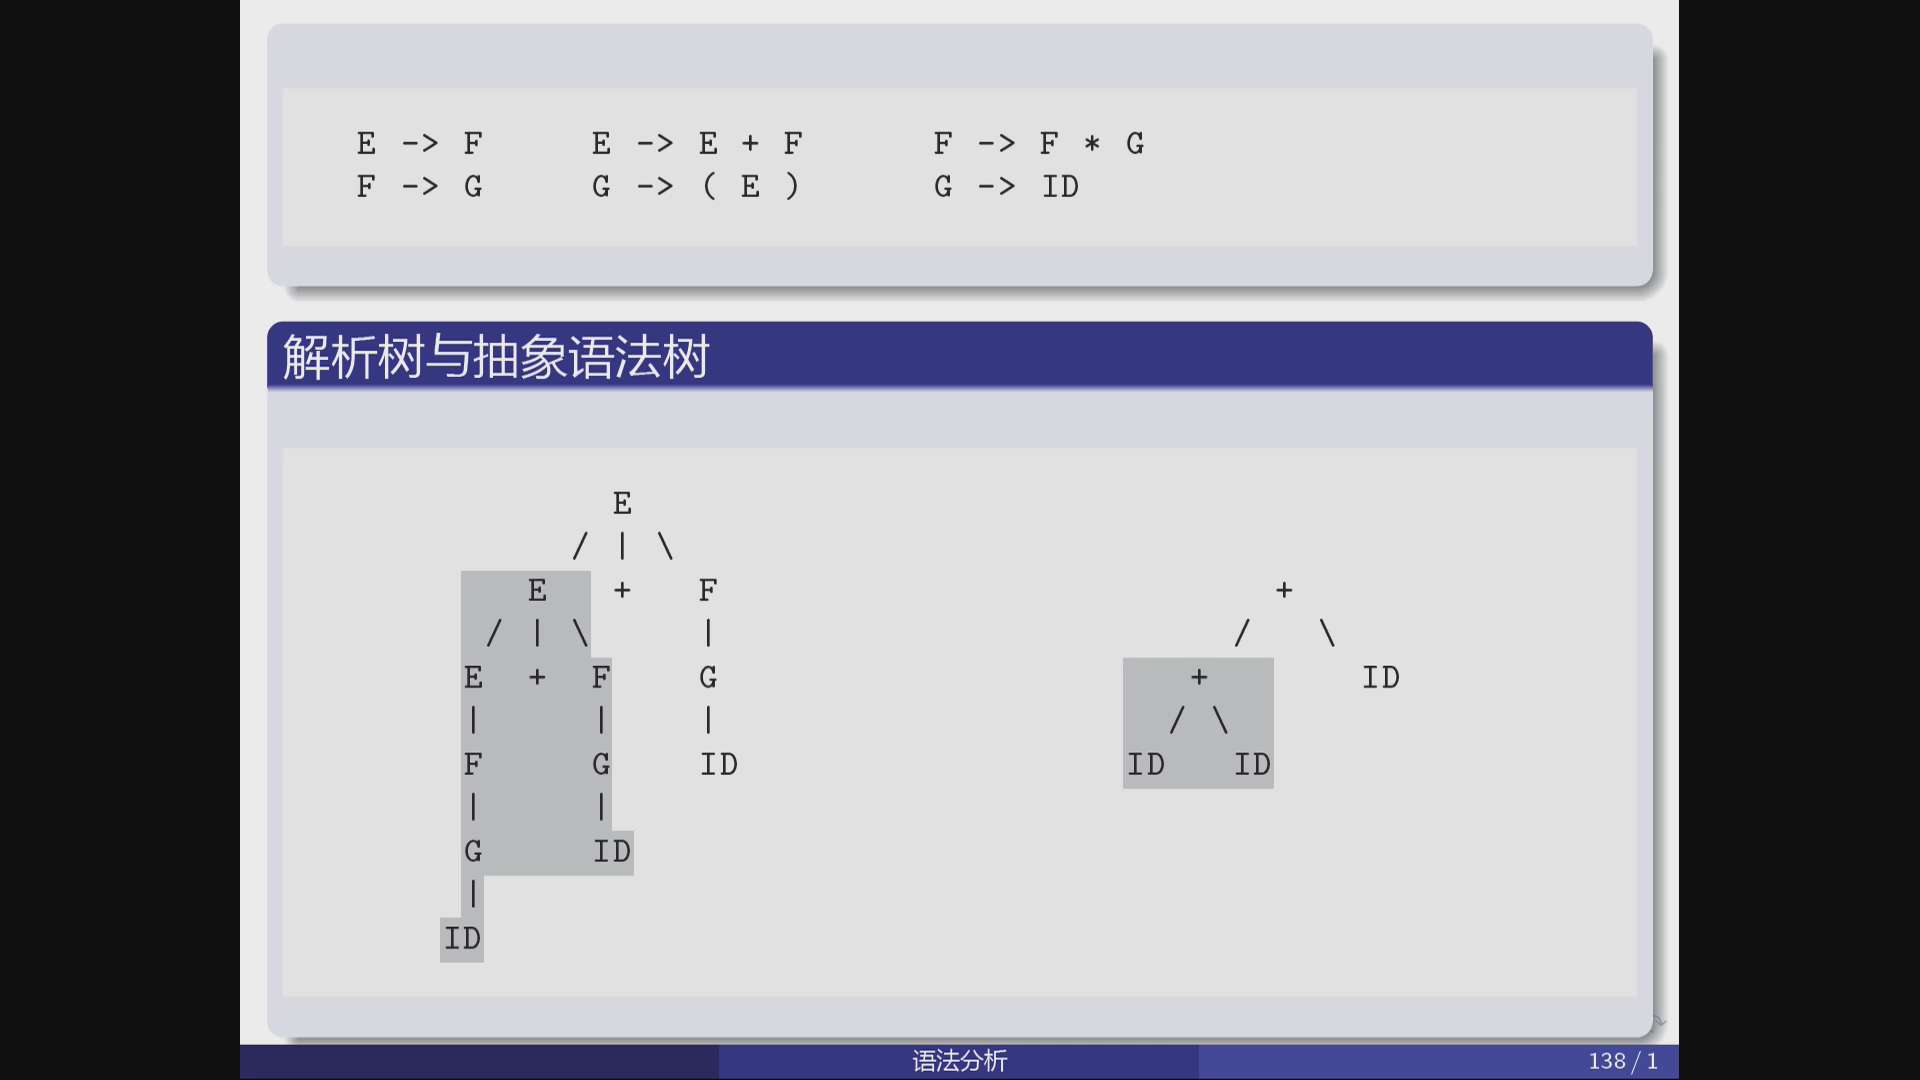
还有一个更重要的区别:我们用解析树来说明推导和规约,但程序最后真正需要的是抽象语法树(AST)。
例如把一个变量从 ID 规约成 G,再到 F,再到 E,解析树中会有好几层节点;AST 中可以始终是同一个变量节点。( E ) 中的括号决定树的分组,却不需要成为 AST 中一个单独的括号节点。相反,E + E 必须产生一个表示加法的节点,连接左右两棵表达式子树。
所以我们可以给每个已经分析出的非终结符保存一棵 AST 的指针,在规约时把子树组装成更大的树。解析树对应分析过程,我们无须先把它完整存进内存,再遍历一遍转换成 AST。语义动作也不只允许机械拼接;如果后续任务需要,可以在组装时做适当转换。
7. 用 C 的 tagged union 表示 While 语言
我们用之前的 While 语言做例子。它的表达式包括常数、变量、算术与比较运算、逻辑运算、一元负号与逻辑非,还加入了解引用、内存分配、读整数和读字符。命令包括变量声明、赋值、顺序执行、条件分支、循环、写整数和写字符。
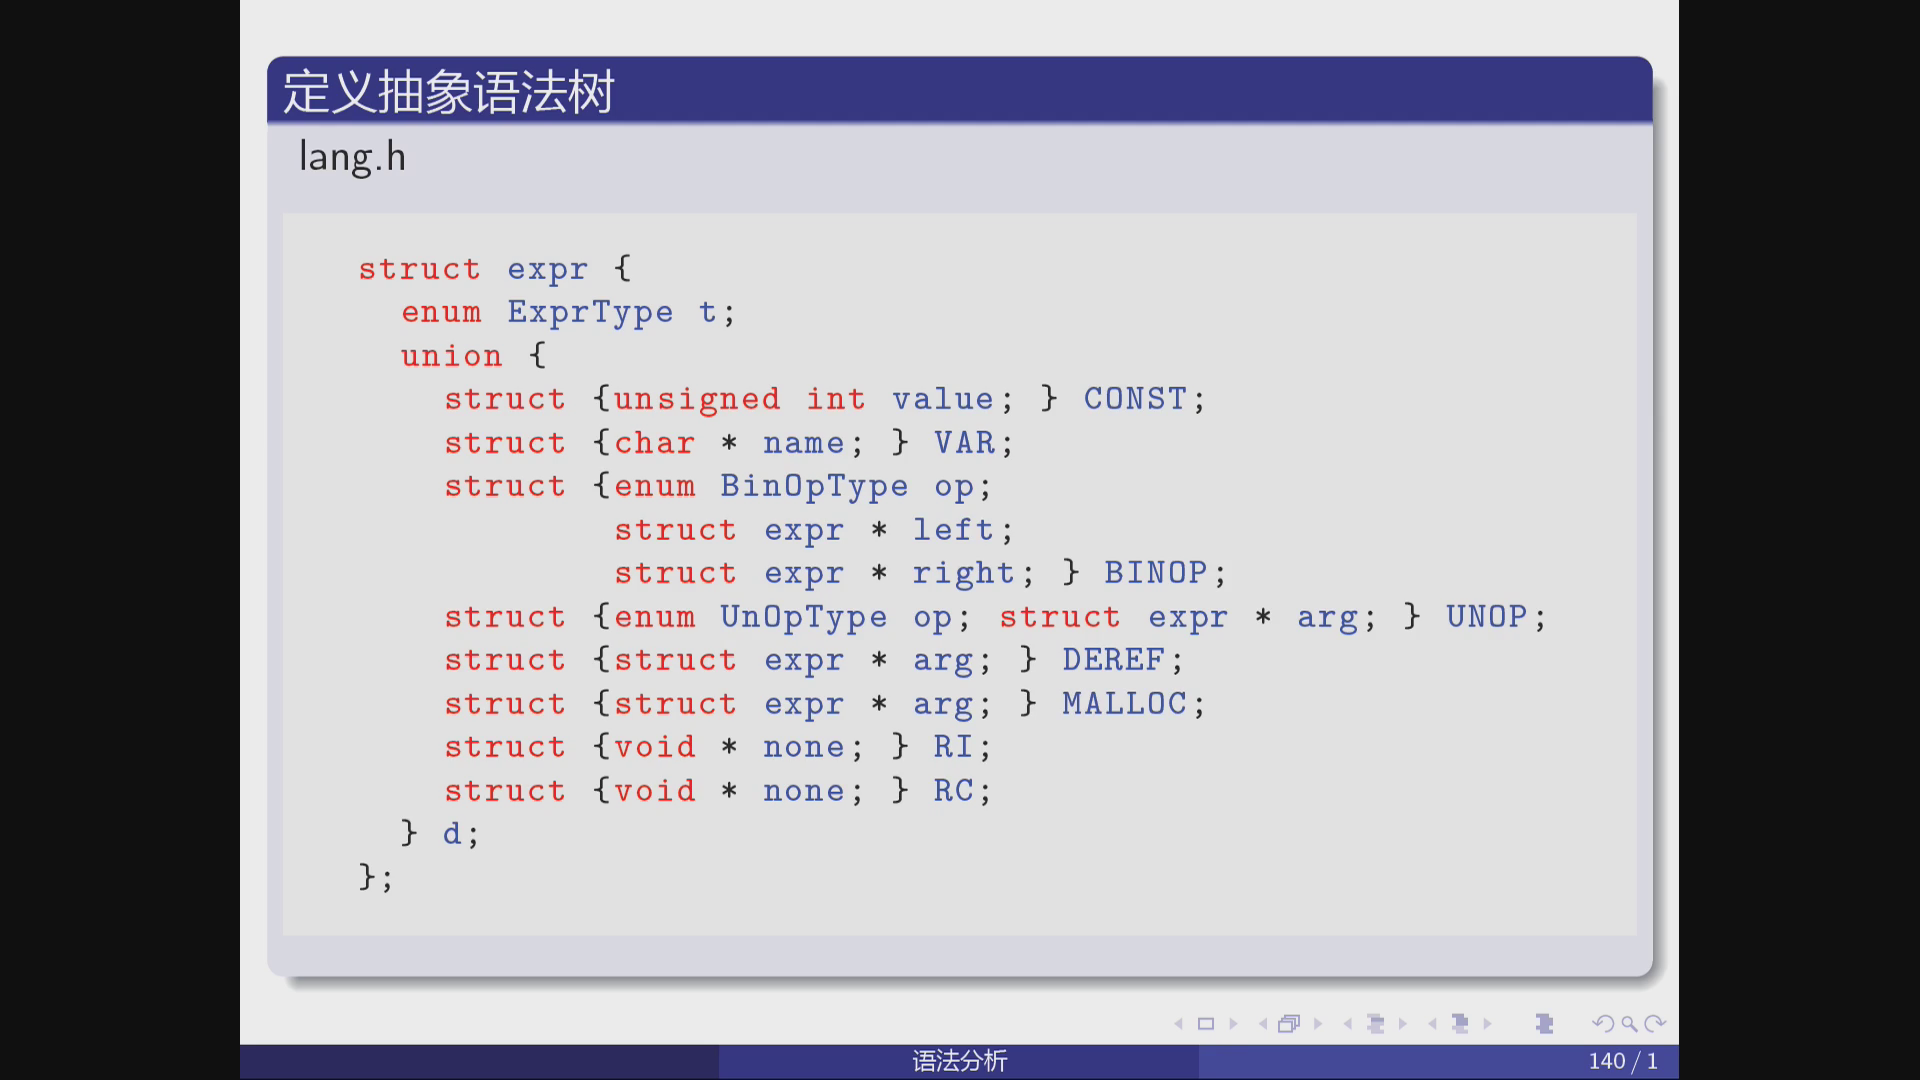
7.1 表达式节点:一个类型标记加一组可能的数据
lang.h 中先列出各种运算及表达式的种类:
enum BinOpType {
    T_PLUS, T_MINUS, T_MUL, T_DIV, T_MOD,
    T_LT, T_GT, T_LE, T_GE, T_EQ, T_NE,
    T_AND, T_OR
};

enum UnOpType { T_UMINUS, T_NOT };

enum ExprType {
    T_CONST, T_VAR, T_BINOP, T_UNOP,
    T_DEREF, T_MALLOC, T_RI, T_RC
};

struct expr {
    enum ExprType t;
    union {
        struct { unsigned int value; } CONST;
        struct { char *name; } VAR;
        struct {
            enum BinOpType op;
            struct expr *left;
            struct expr *right;
        } BINOP;
        struct { enum UnOpType op; struct expr *arg; } UNOP;
        struct { struct expr *arg; } DEREF;
        struct { struct expr *arg; } MALLOC;
        struct { void *none; } RI;
        struct { void *none; } RC;
    } d;
};
t 告诉我们当前节点是什么种类,d 则只按这个种类解释其中的一份数据。这种“标记加联合体”的表示就是 tagged union。联合体的各成员共享存储空间,不能因为写了很多成员,就以为一个节点同时拥有所有成员的有效数据。
常数节点保存一个无符号整数,变量节点保存名字。二元运算节点保存运算符和左右子树指针;一元运算节点只需要运算符和一个子树指针。指针使我们能递归连接节点,而不是把整棵子树直接塞进一个固定大小的结构体。
DEREF 的参数表达式给出地址,解引用读取该地址处的值。这里必须区分:*e 是解引用,不能把它理解成“取地址”。MALLOC 保存申请空间大小的表达式;读整数、读字符没有子表达式,课件为了表示统一放了 none 占位域。
7.2 命令节点:子节点可能是表达式,也可能是命令
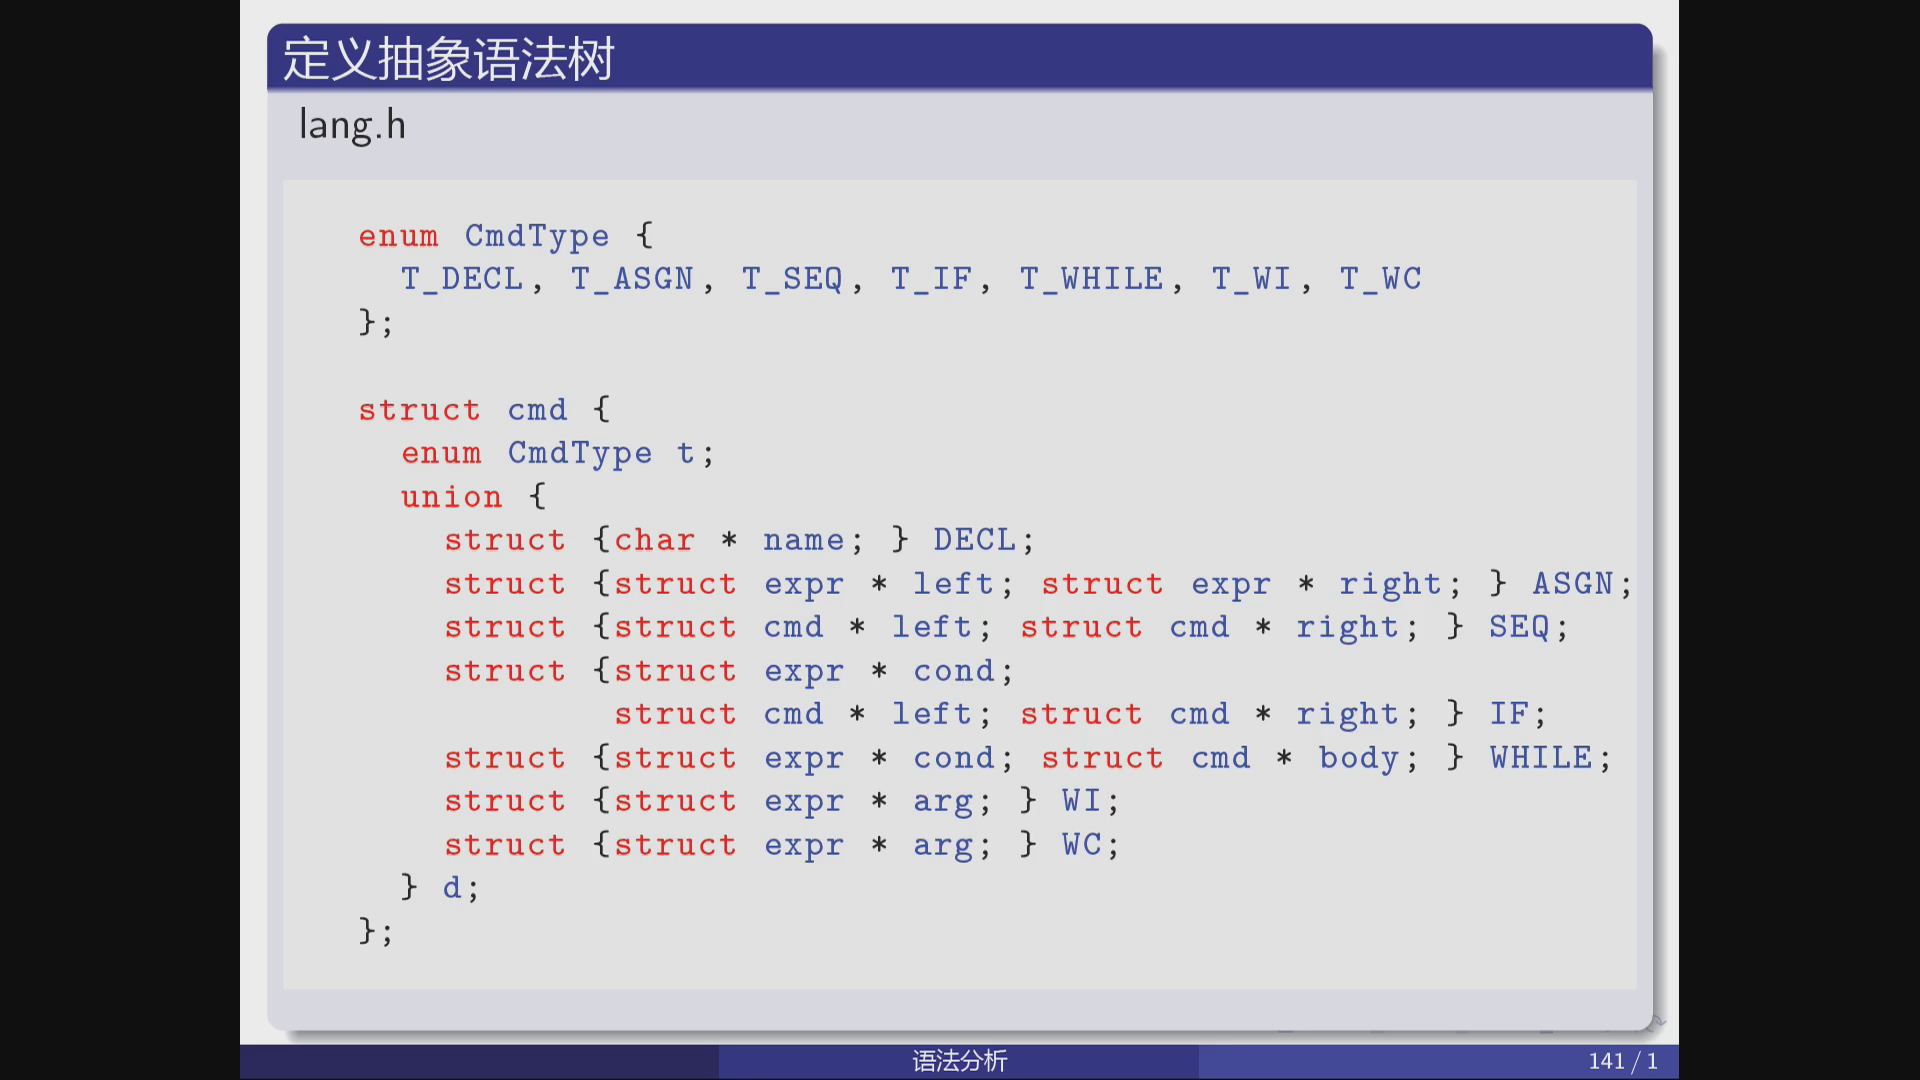
enum CmdType { T_DECL, T_ASGN, T_SEQ, T_IF, T_WHILE, T_WI, T_WC };

struct cmd {
    enum CmdType t;
    union {
        struct { char *name; } DECL;
        struct { struct expr *left, *right; } ASGN;
        struct { struct cmd *left, *right; } SEQ;
        struct {
            struct expr *cond;
            struct cmd *left, *right;
        } IF;
        struct { struct expr *cond; struct cmd *body; } WHILE;
        struct { struct expr *arg; } WI;
        struct { struct expr *arg; } WC;
    } d;
};
看清 ASGN 和 SEQ 的区别。赋值的两个孩子都是表达式:左边表示赋值目标,右边表示待写入的值;左边通常是变量或解引用表达式。顺序执行的两个孩子则都是命令,表示先执行左边,再执行右边。
IF 的条件是表达式,两个分支是命令;WHILE 的条件是表达式,循环体是命令;输出命令以一个表达式为参数。这些类型关系,就是 AST 必须保存的程序结构。
赋值规则若暂时允许一般表达式出现在左侧,不代表每个这样的 AST 都有合法含义。是否可赋值、变量是否已声明等,还可以在 AST 生成后进一步检查。
7.3 构造函数把分配和填域封装起来
为了让每条语义动作直接表达树的组装,我们先把内存分配、类型标记和指针赋值封装成辅助构造函数:
struct expr *TConst(unsigned int value);
struct expr *TVar(char *name);
struct expr *TBinOp(enum BinOpType op,
                    struct expr *left, struct expr *right);
struct expr *TUnOp(enum UnOpType op, struct expr *arg);
struct expr *TDeref(struct expr *arg);
struct expr *TMalloc(struct expr *arg);
struct expr *TReadInt(void);
struct expr *TReadChar(void);

struct cmd *TDecl(char *name);
struct cmd *TAsgn(struct expr *left, struct expr *right);
struct cmd *TSeq(struct cmd *left, struct cmd *right);
struct cmd *TIf(struct expr *cond, struct cmd *left, struct cmd *right);
struct cmd *TWhile(struct expr *cond, struct cmd *body);
struct cmd *TWriteInt(struct expr *arg);
struct cmd *TWriteChar(struct expr *arg);
例如 TUnOp 收到一个一元运算符和已有子树的地址,返回新树根的地址。其核心实现可以这样写;下面是按课堂说明补全的示例:
struct expr *TUnOp(enum UnOpType op, struct expr *arg) {
    struct expr *node = malloc(sizeof *node);
    if (node == NULL) {
        fprintf(stderr, "out of memory\n");
        exit(EXIT_FAILURE);
    }
    node->t = T_UNOP;
    node->d.UNOP.op = op;
    node->d.UNOP.arg = arg;
    return node;
}
这段实现所在的 C 文件需要包含 <stdlib.h> 和 <stdio.h>。它分配一个节点,而不是复制整棵子树,然后设置标记和当前联合体成员。二元构造函数同理,只是多保存一个子树指针。print_expr、print_cmd 等辅助函数则能递归打印结果,供我们调试树结构。
8. .y 文件的声明部分
8.1 文件头:把分析器需要的 C 声明带进去
%{
#include <stdio.h>
#include "lang.h"
#include "lexer.h"

int yyerror(char *str);
int yylex(void);
struct cmd *root;
%}
%{ ... %} 中的 C 内容会进入生成的分析器源文件。yylex 由 Flex 提供:语法分析器需要下一个 token 时,就调用它。yyerror 用于处理语法错误,仍要在工程中提供相应实现。root 最后保存整棵程序 AST 的根。
8.2 %union:分析栈上的语义值如何存储
%union {
    unsigned int n;
    char *i;
    struct expr *e;
    struct cmd *c;
    void *none;
}
自然数 token 附带整数值,标识符 token 附带字符串;表达式非终结符附带 struct expr *,命令非终结符附带 struct cmd *。这几种结果放进一个语义值联合体中。Bison 管理这个联合体的类型以及分析栈,我们提供各个成员的声明。
这个 %union 与 AST 节点中的 union 是两回事:前者是分析过程传递各种语义值的载体,后者是最终树节点的内存表示。
8.3 %token 与 %type 把符号绑定到成员
%token <n> TM_NAT
%token <i> TM_IDENT
%token <none> TM_LEFT_BRACE TM_RIGHT_BRACE
%token <none> TM_LEFT_PAREN TM_RIGHT_PAREN
%token <none> TM_MALLOC TM_RI TM_RC TM_WI TM_WC
%token <none> TM_VAR TM_IF TM_THEN TM_ELSE TM_WHILE TM_DO
%token <none> TM_SEMICOL TM_ASGNOP TM_OR TM_AND TM_NOT
%token <none> TM_LT TM_LE TM_GT TM_GE TM_EQ TM_NE
%token <none> TM_PLUS TM_MINUS TM_MUL TM_DIV TM_MOD

%type <c> NT_WHOLE NT_CMD
%type <e> NT_EXPR
TM_ 开头的是终结符,NT_ 开头的是非终结符,只是这个示例采用的命名约定。%token 声明 token,%type 声明非终结符的语义值类型。尖括号里的 n/i/e/c/none 都是刚才 %union 的成员名,不能把它们当成独立定义的 C 类型。
例如 <e> NT_EXPR 表示规约得到一个表达式时,该符号保存的是 e 成员,也就是 AST 指针。圆括号、操作符、保留字等已经由 token 种类表达了自己的语法意义,通常没有额外的值需要保存。
8.4 声明优先级和结合性
课件的简版声明是:
%nonassoc TM_ASGNOP
%left TM_OR
%left TM_AND
%left TM_LT TM_LE TM_GT TM_GE TM_EQ TM_NE
%left TM_PLUS TM_MINUS
%left TM_MUL TM_DIV TM_MOD
%left TM_NOT
%left TM_LEFT_PAREN TM_RIGHT_PAREN
%right TM_SEMICOL
越先出现,优先级越低;同一行的 token 优先级相同。%left 表示左结合,%right 表示右结合,%nonassoc 表示不允许相同优先级发生这种结合。算术运算中乘除取余高于加减;逻辑与高于逻辑或。分号在这里声明为右结合,连续命令由此组装成向右嵌套的顺序执行树。
简版中 T_UMINUS 表示 AST 的运算种类。一元负号规则尚未使用 %prec,默认采用规则中终结符 TM_MINUS 的优先级。
若希望一元负号高于乘法,编者补充的一种改法是在乘除那一行之后另设高优先级,并覆盖该规则的优先级:
/* 补充改法:放在乘除优先级声明之后 */
%precedence UMINUS

/* 在规则部分 */
NT_EXPR: TM_MINUS NT_EXPR %prec UMINUS
         { $$ = TUnOp(T_UMINUS, $2); }
;
这样遇到 - a * b 时,就能先规约一元负号,得到 (-a) * b 的分组。规则优先级的覆盖方式可参阅 GNU Bison:Context-Dependent Precedence。
9. 产生式右边的 C 代码:规约时组装语义值
规则区放在两条 %% 之间,第一条规则默认决定起始符号。整个程序的入口规则是:
%%
NT_WHOLE:
    NT_CMD {
        $$ = $1;
        root = $$;
    }
;
冒号相当于产生式箭头,竖线分隔不同的候选右部,分号结束该非终结符的一组规则。花括号内是规约发生时执行的 C 语义动作。
这里最需要记住两个记号:$$ 是产生式左侧符号的语义值,$1、$2、$3 等是右侧第 1、2、3 个符号的语义值。**位置按照全部右侧符号编号,包括不携带有用数据的操作符和括号。**它不是只给子树编号。
9.1 表达式:叶子、透明括号和运算节点
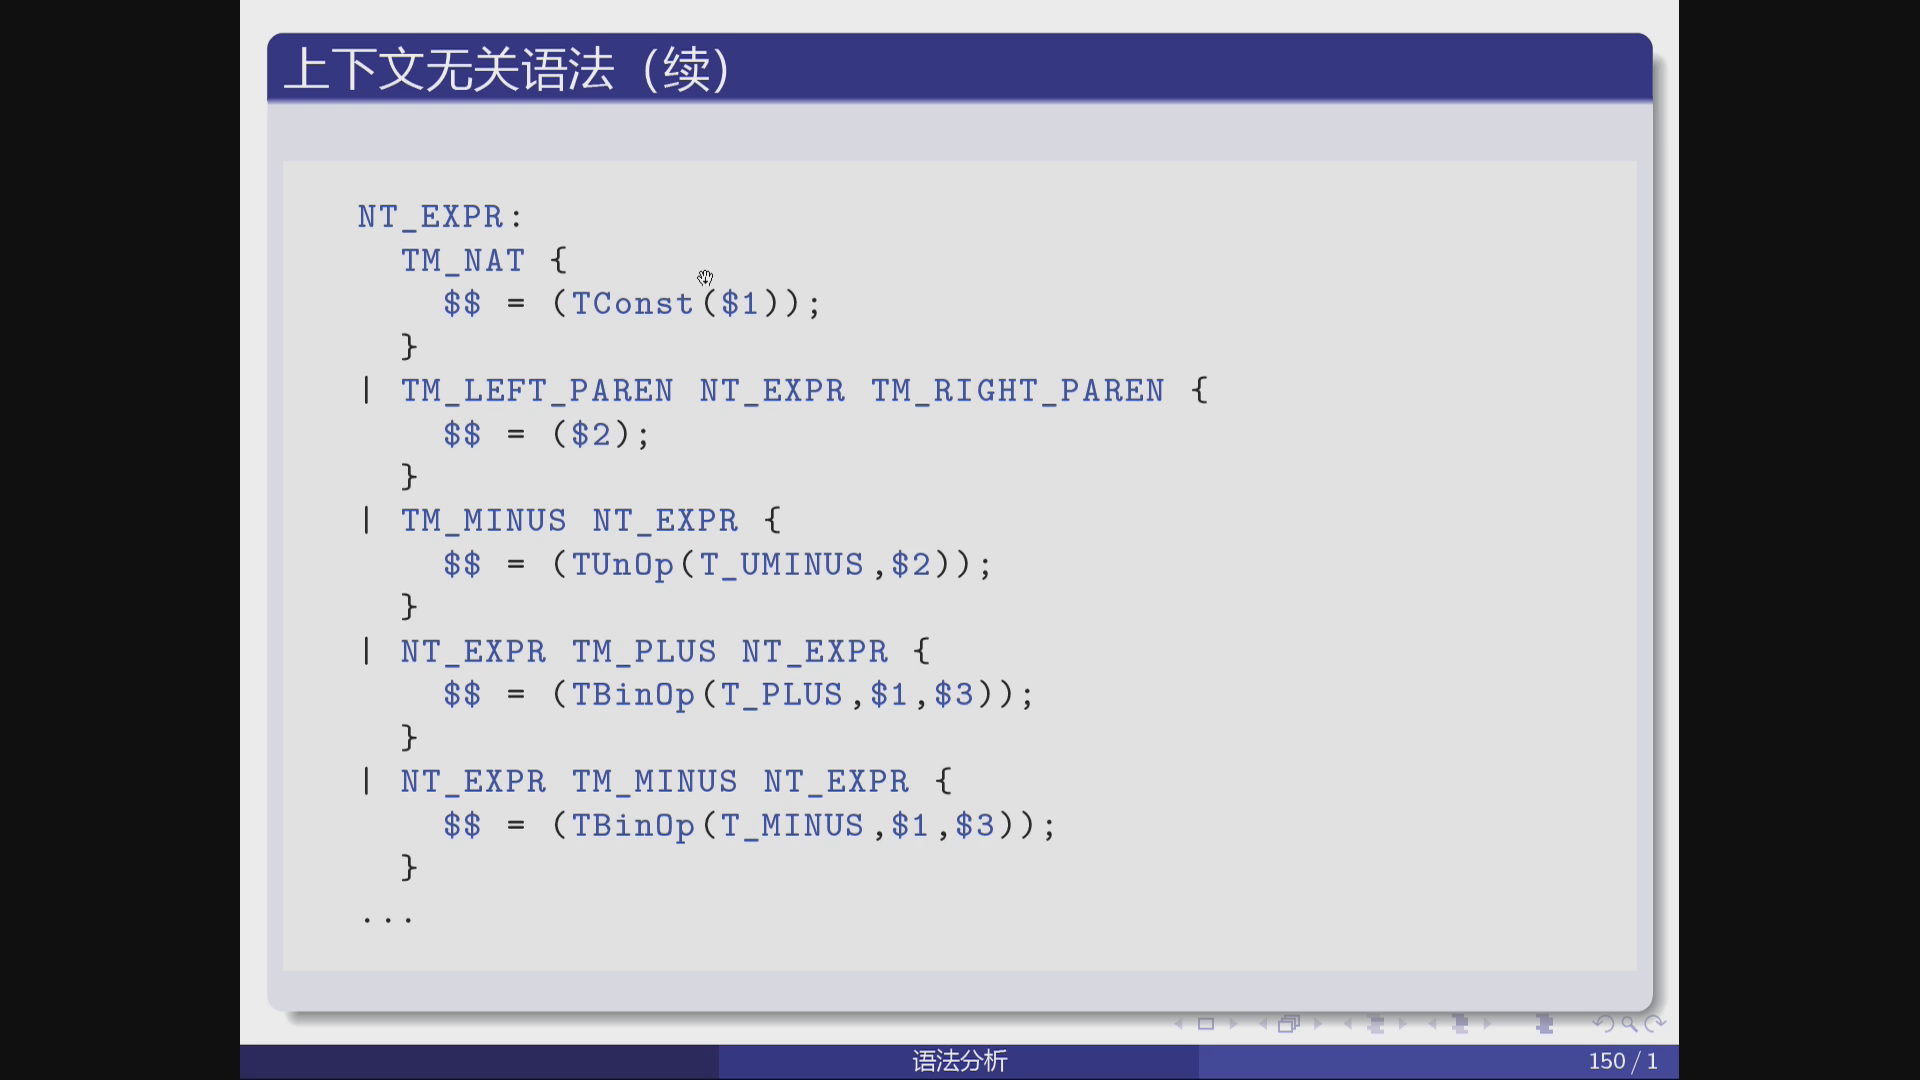
把课件展示的五条规则整理成可读的片段:
NT_EXPR:
    TM_NAT
        { $$ = TConst($1); }
  | TM_LEFT_PAREN NT_EXPR TM_RIGHT_PAREN
        { $$ = $2; }
  | TM_MINUS NT_EXPR
        { $$ = TUnOp(T_UMINUS, $2); }
  | NT_EXPR TM_PLUS NT_EXPR
        { $$ = TBinOp(T_PLUS, $1, $3); }
  | NT_EXPR TM_MINUS NT_EXPR
        { $$ = TBinOp(T_MINUS, $1, $3); }
;
第一条中 $1 是词法分析器给出的无符号整数,TConst 把它包装为常数 AST 节点。第二条右部有三个符号,中间的表达式在第 2 个位置,所以直接返回 $2;括号已经完成了控制分组的工作,无须再创建节点。
一元负号右部有两个符号,参数子树是 $2。加法右部有三个符号,左右表达式是 $1 和 $3,$2 只是加号 token;TBinOp 接收两棵已经构造好的树,把它们接到新加法节点下。
其他表达式按相同方式接入。例如标识符通过 TVar 构造,乘法通过 TBinOp(T_MUL, ...) 构造,逻辑非通过 TUnOp(T_NOT, ...) 构造。下面是按 AST 构造接口补全的几条示例,便于看清对应关系,具体优先级仍要与最终文法一起核对:
/* 接入 NT_EXPR 的其他候选右部 */
  | TM_IDENT
        { $$ = TVar($1); }
  | NT_EXPR TM_MUL NT_EXPR
        { $$ = TBinOp(T_MUL, $1, $3); }
  | TM_NOT NT_EXPR
        { $$ = TUnOp(T_NOT, $2); }
这些代码构造的是树,不是在语法分析时计算加法或乘法的数值。之后解释执行、检查程序或生成代码时,才按照各节点的含义处理它们。
$2,加减规则用 $1 与 $3 构造二元节点;一元负号原简版没有 %prec,优先级补全另见正文。9.2 命令:三个 if 子树分别在哪个位置
命令的处理方法完全一样。课堂进一步展示了变量声明、赋值、顺序执行和条件分支;配套 PDF 的规则节没有列出这部分,下面按课堂展示与讲解恢复:
NT_CMD:
    TM_VAR TM_IDENT
        { $$ = TDecl($2); }
  | NT_EXPR TM_ASGNOP NT_EXPR
        { $$ = TAsgn($1, $3); }
  | NT_CMD TM_SEMICOL NT_CMD
        { $$ = TSeq($1, $3); }
  | TM_IF NT_EXPR TM_THEN TM_LEFT_BRACE NT_CMD TM_RIGHT_BRACE
    TM_ELSE TM_LEFT_BRACE NT_CMD TM_RIGHT_BRACE
        { $$ = TIf($2, $5, $9); }
;
声明只需要保存标识符名字,因此取 $2。赋值把左目标表达式和右值表达式交给 TAsgn。顺序执行把两棵命令树交给 TSeq。
if 的位置要逐个数:
1 IF   2 EXPR   3 THEN   4 {   5 CMD   6 }
7 ELSE   8 {   9 CMD   10 }
于是条件表达式是 $2,then 分支是 $5,else 分支是 $9,这三个参数的类型分别是表达式指针、命令指针、命令指针。TIf($2, $5, $9) 正好对应 AST 中 cond/left/right 三个域。
循环和输出命令也可以按同样的方法写出。以下是依照 token 声明和构造函数补全的示例,与上面课堂逐项讲解的四条规则区分开:
  | TM_WHILE NT_EXPR TM_DO TM_LEFT_BRACE NT_CMD TM_RIGHT_BRACE
        { $$ = TWhile($2, $5); }
  | TM_WI TM_LEFT_PAREN NT_EXPR TM_RIGHT_PAREN
        { $$ = TWriteInt($3); }
  | TM_WC TM_LEFT_PAREN NT_EXPR TM_RIGHT_PAREN
        { $$ = TWriteChar($3); }
写规则时最好先检查每个符号的位置,再检查构造函数参数的类型,最后检查冲突信息。规则能生成 C 文件,并不等于每个参数都已经指向我们真正想要的子树。
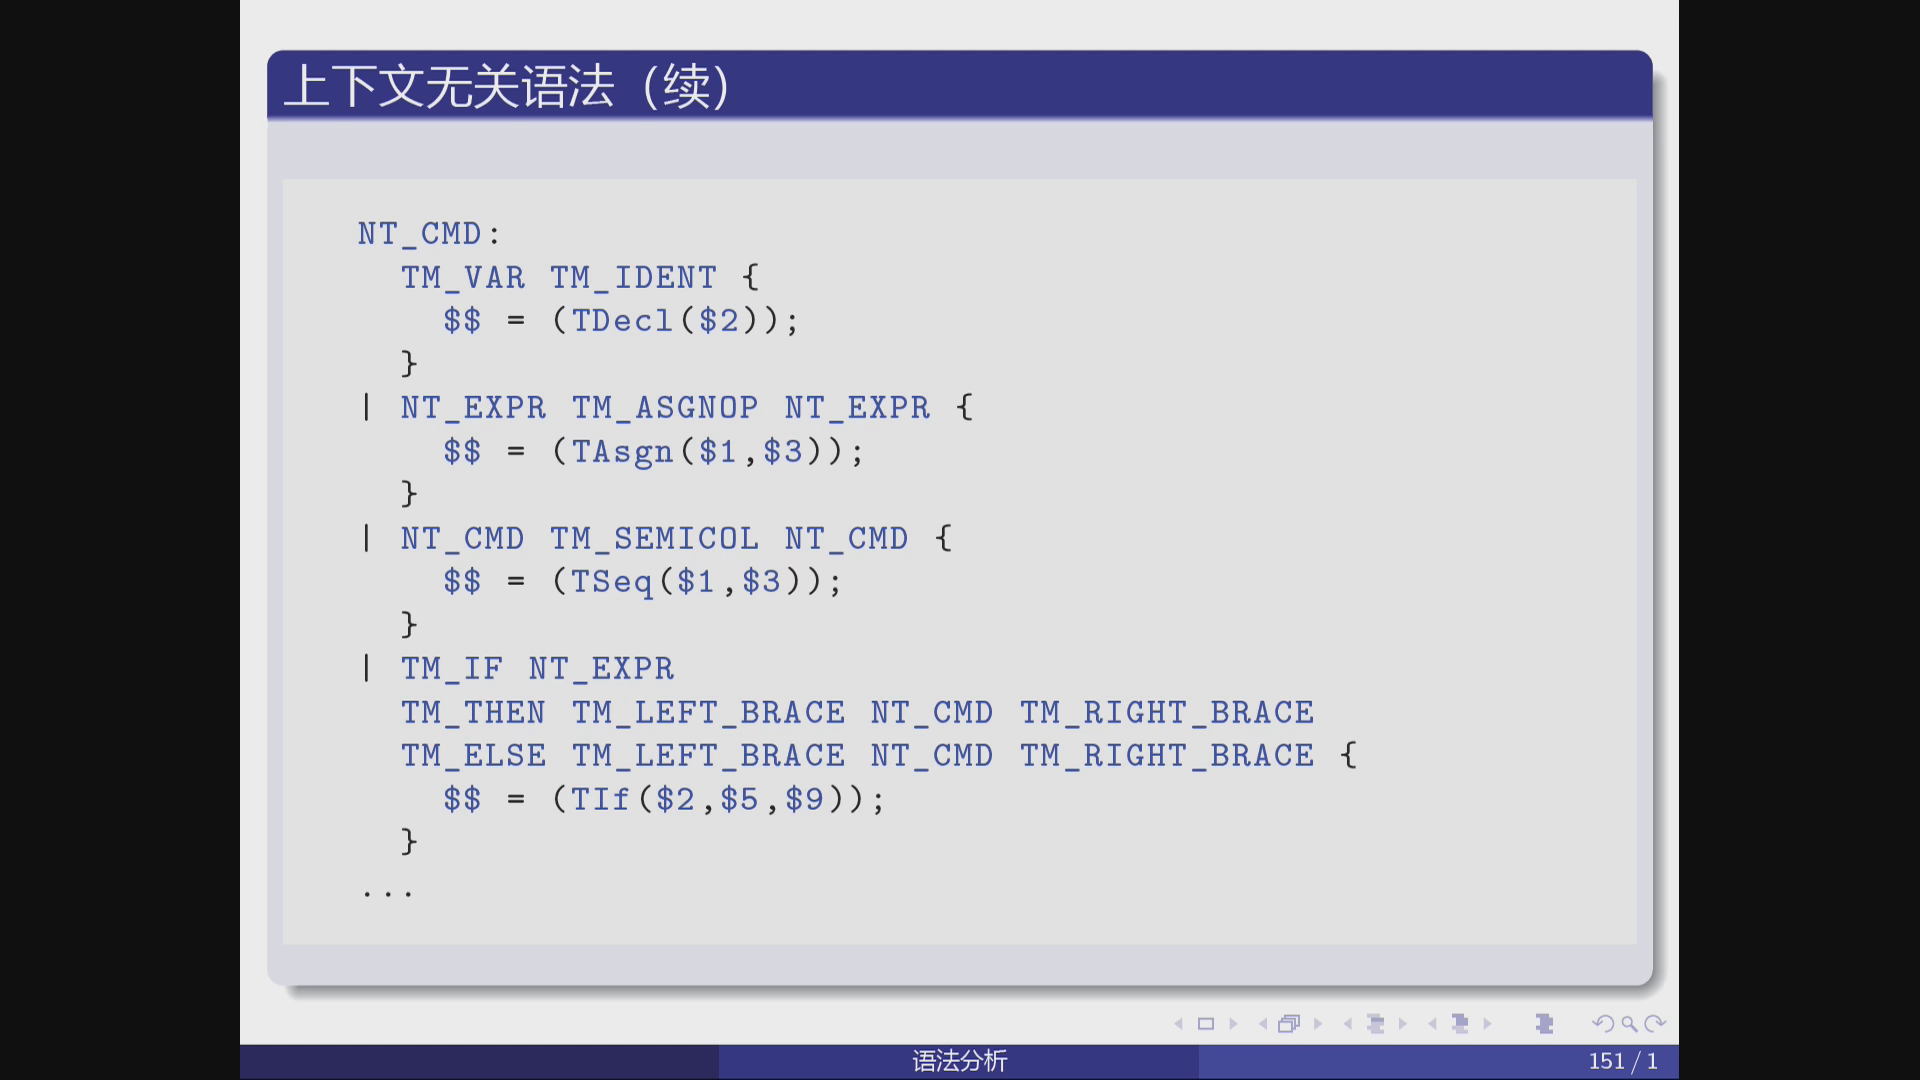
TIf($2, $5, $9)。10. Flex 怎样把 token 和语义值一起交给 Bison
语法分析器要的不是只有一个 token 名字。例如自然数 123,种类是 TM_NAT,具体的值是 123;标识符的种类是 TM_IDENT,具体的值是它的名字。和 Bison 协作时,我们把附带的语义值写到 yylval,再从 yylex 返回 token 种类。
lang.l 的相关片段是:
%option noyywrap yylineno
%option outfile="lexer.c" header-file="lexer.h"
%{
#include "lang.h"
#include "parser.h"
%}
%%
0|[1-9][0-9]* {
    yylval.n = build_nat(yytext, yyleng);
    return TM_NAT;
}
"var" {
    return TM_VAR;
}
yytext 是匹配到的文本,yyleng 是长度;build_nat 把这段数字文本转换为自然数。TM_NAT 声明使用 <n>,所以这里必须写 yylval.n。标识符相应使用 yylval.i,同时必须保证保存的字符串在后续分析和 AST 使用期间仍然有效,不能把会被词法分析器覆盖的临时文本直接当作长期变量名。
parser.h 由 Bison 生成,提供 token 的定义和语义值接口。先包含 lang.h,也使头文件涉及的 AST 结构声明可见。原来独立词法分析时自己维护的 token class、token value,在这里要与 Bison 的 token 和 yylval 对接,不能各自定义一套相互不一致的编号。
调用关系可以记成:yyparse() 需要输入时调用 yylex();yylex() 返回 token 种类,同时把值放进 yylval;yyparse() 把 token 移入,满足某条产生式时执行语义动作,得到新的 AST 指针。
11. 从 yyparse 到编译和调试
11.1 主程序只需启动分析并使用根节点
课堂主程序展示的是把输入流交给分析器,然后打印 AST。下面保留这个流程,并把课件中手写的 void yyparse() 改为采用生成头文件的声明,同时补上错误返回判断:
#include <stdio.h>
#include "lang.h"
#include "lexer.h"
#include "parser.h"

extern struct cmd *root;

int main(void) {
    yyin = stdin;
    if (yyparse() != 0) {
        return 1;
    }
    print_cmd(root);
    return 0;
}
yyin 是 Flex 使用的输入流,yyparse 是 Bison 生成的解析入口。成功规约到 NT_WHOLE 时,入口规则把最终命令树写入 root。打印只是调试手段;真正的编译器可以把 root 交给语义检查和后续翻译阶段。
得到 AST 之后,我们已经能够围绕程序结构继续检查,例如变量是否重名、使用的变量是否已经声明。语法正确只说明 token 组成了允许的结构,不会自动保证这些进一步的合法性条件。
11.2 .l/.y 先生成 C,再编译并链接
整个过程是:
lang.l --Flex--> lexer.c、lexer.h
lang.y --Bison--> parser.c、parser.h、parser.output
lang.c、parser.c、lexer.c、main.c --C编译器--> 各自的.o
各.o --链接--> main
课件用 Makefile 把这些步骤连接起来。为让初学者先看清生成顺序,我们把它整理成下面的串行构建示例;这是对课堂依赖关系的补清,命令行前必须是 tab 缩进:
.PHONY: all
all: main

main: lang.c lang.h lang.l lang.y main.c
	bison -o parser.c -d -v lang.y
	flex lang.l
	gcc -c lang.c
	gcc -c parser.c
	gcc -c lexer.c
	gcc -c main.c
	gcc lang.o parser.o lexer.o main.o -o main
-o parser.c 指定 C 文件名,-d 同时生成供词法分析器使用的头文件,-v 输出状态及决策信息到 parser.output。遇到冲突时,我们可以看哪个状态包含了哪些项目、在某个 token 上同时出现了哪些动作,再回到文法判断应当改结构还是补优先级。
这个 Makefile 先生成两组 C 文件和头文件,再编译、链接。它把构建步骤集中到一个规则中,便于读懂流程;正式工程可以进一步为多输出生成步骤建立准确的依赖关系,减少重复生成。完成构建还需要 lang.c、完整词法规则和错误处理实现。
我们后面会继续练习典型语法规则的设计,并安排与词法分析器协作的编程作业。现在先把三层关系分清:文法决定允许的程序结构,移入规约决策决定怎样读出结构,语义动作决定把它保存成怎样的 AST。
编者注
来源:2026 年 10 月 8 日回放 A169075、B169365 的完整转写,Parser.pdf 第 5—13 页与课堂使用的 Quiz0929.pdf。项目链、规约和集合传播步骤已补齐;构造函数实现、额外表达式及循环/输出规则、yyparse 返回处理、%prec 改法和串行 Makefile 属编者补全。命令规则按回放恢复。课堂未运行演示程序,本稿代码片段未作为完整工程执行。
原件:[语法分析课件](../../../参考资料/2026-2027 Fall/files/Parser-cadef8c67a4d264d.pdf) · [课堂测验](../../../参考资料/2026-2027 Fall/files/Quiz0929-a6f5a25698f57668.pdf) · [前课词法分析与 While 语言说明](../../../参考资料/2026-2027 Fall/files/Lexer-c46cdab227b82d67.pdf)。回放入口为课程主页,配套资料来自课程网站。