Lecture 6
Abstract
我们完成交通灯有限状态机的电路设计,随后建立 ISA 与程序可见机器状态的联系,学习 x86-64 寄存器、AT&T 语法、数据搬运、指针交换和有效地址计算。
我们先把上次的交通灯例子接着做完。前面我们从 R-S latch、D latch、D flip-flop 一直做到寄存器,已经知道怎样让电路记住信息。现在的问题是:给定一段自然语言描述,我们怎样把它变成一个真正可以工作的时序电路?交通灯正好可以把这个过程连起来。
把交通规则变成有限状态机
我们考虑两条相交的道路 A 和 B。每条路上都有传感器,分别给出输入 、:有交通流时为 1,没有时为 0。输出是两盏交通灯 、,每盏灯都有绿、黄、红三种颜色。A 路允许通行时,B 路必须保持红灯;切换通行方向时,先经过黄灯状态。
这个系统可以分为四个状态:
| 状态 | A 路交通灯 | B 路交通灯 | 下一状态 |
|---|---|---|---|
| 绿 | 红 | 时保持; 时到 | |
| 黄 | 红 | 无条件到 | |
| 红 | 绿 | 时保持; 时到 | |
| 红 | 黄 | 无条件到 |
复位时进入 。“无条件转换”在下一次状态更新时不再检查传感器,状态由时钟控制的寄存器保存。
我们先画状态转移图,再把每条箭头写成表。表里的 表示该输入对这一行没有影响,0 和 1 都满足:
| 当前状态 | 下一状态 | ||
|---|---|---|---|
| 0 | |||
| 1 | |||
| 0 | |||
| 1 | |||
传感器本身已经是二进制输入,不需要再编码。四个状态则要用两个 bit 表示。我们取 ,把保存状态的两个位写成 ,下一状态写成 ,避免和四个状态的名称混淆。
对于下一状态的高位,当前状态为 01 时一定输出 1,为 10 时也一定输出 1,而 00、11 时输出 0。因此
对于下一状态的低位,只在两种情况下为 1:当前为 00 且 A 路没有交通,或者当前为 10 且 B 路没有交通。因此
这里用的仍然是前面组合逻辑中的积之和方法:找出结果为 1 的各行,分别写出条件,再用 OR 合在一起。课件这一式第一项的 漏写了取反;按转移表必须是 。 若照着错误式子画电路,00 状态下 A 路没有交通时就不能正确转到 01。我们应以状态规则和真值表相互核对,而不是机械抄公式。
输出同样需要编码。每盏灯有三种颜色,两个 bit 足够。取绿灯 00、黄灯 01、红灯 10,就得到:
| 00 | 00 | 10 |
| 01 | 01 | 10 |
| 10 | 10 | 00 |
| 11 | 10 | 01 |
从表中直接读出
有了这些表达式,我们就能把整个电路分成三部分。状态寄存器保存 ;下一状态组合逻辑读取当前状态和输入 ,算出 ;输出组合逻辑读取当前状态,生成两盏灯的编码。时钟到来时,寄存器把下一状态变成当前状态,电路就继续运行。这是一个 Moore 型状态机:灯的输出由当前状态决定,外部输入先影响状态转换。
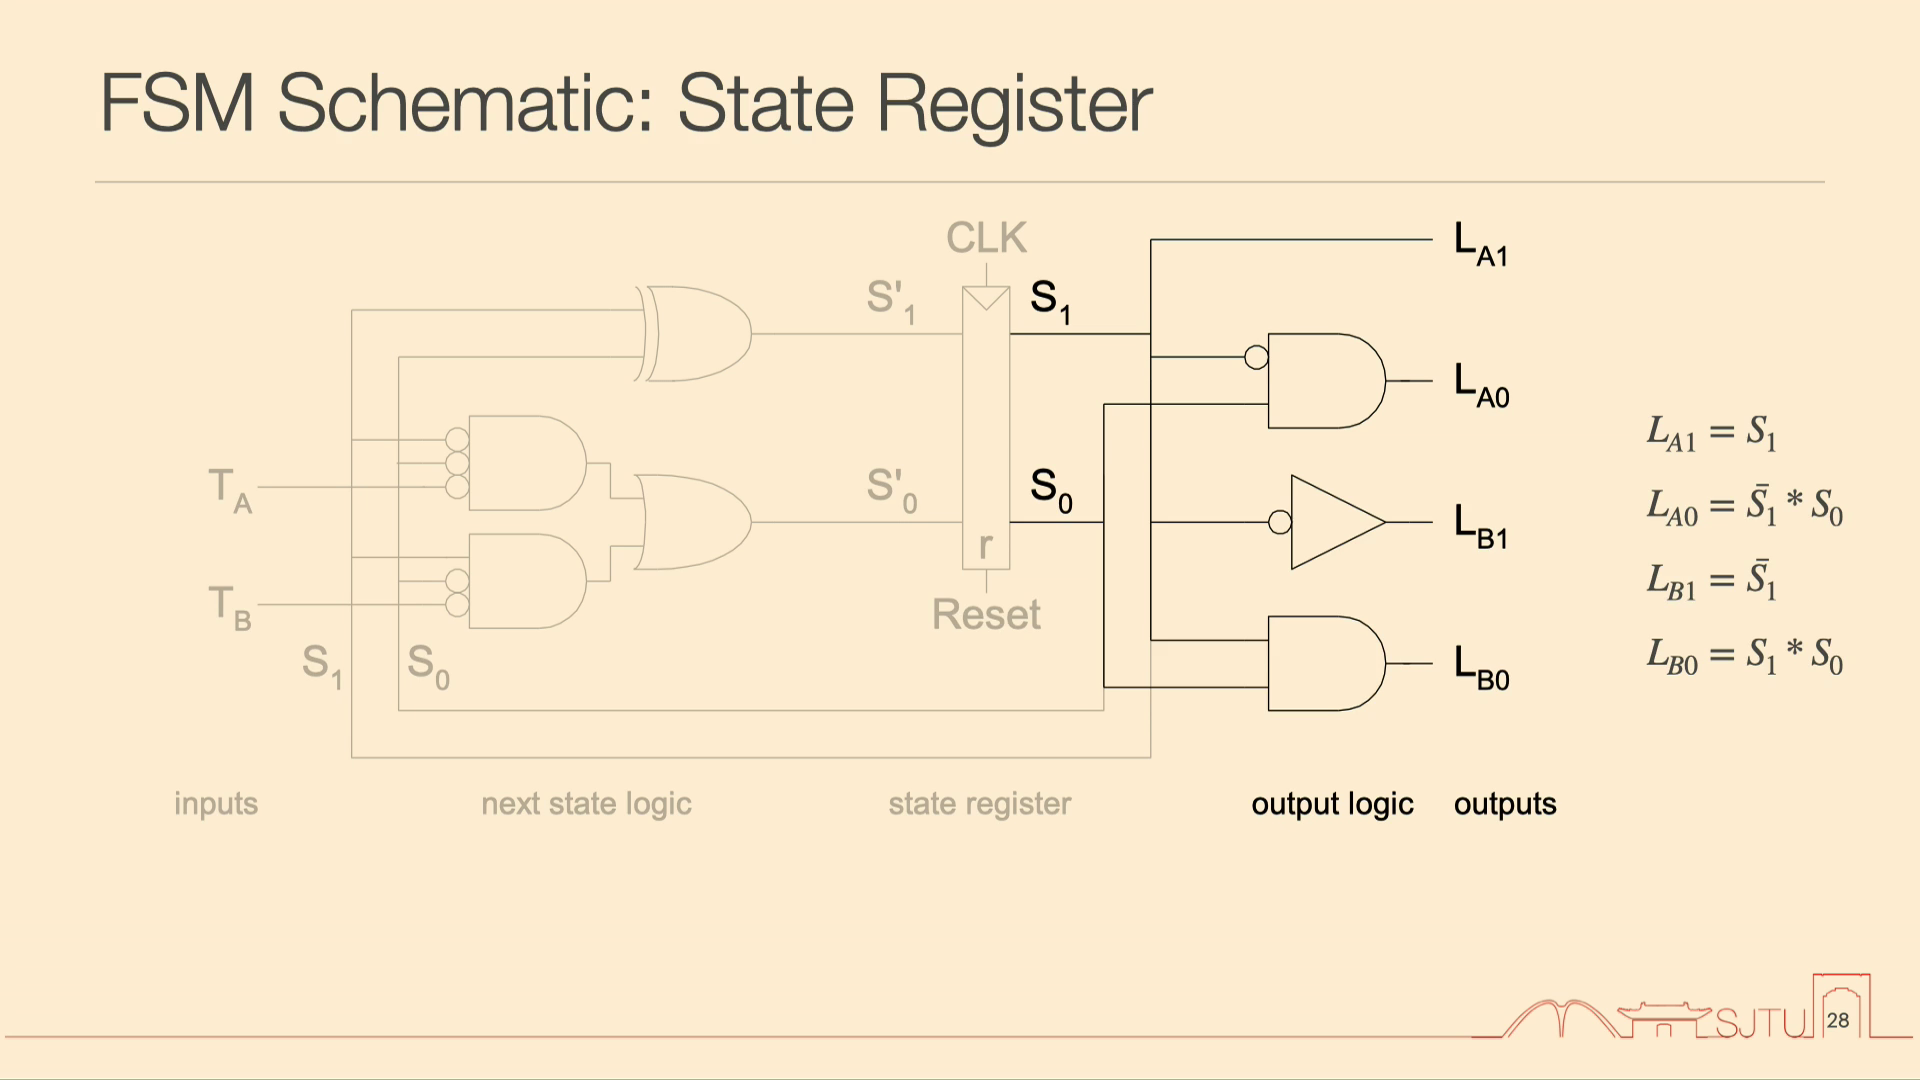
我们现在走通了一条很重要的路线:自然语言问题 → 状态转移图 → 状态转移表 → 输入、状态和输出编码 → 布尔表达式 → 门级电路与状态寄存器。以后看到更复杂的控制器,也可以先按这个过程拆开。
ISA 是软件与硬件之间的约定
接下来我们往上走一层,讨论 Instruction Set Architecture,简称 ISA,也就是指令集体系结构。底层电路怎样和上层程序合作?程序员不可能每写一段程序,都先了解 CPU 中每个门和每条连线。我们需要一个稳定的接口,规定程序可以要求机器做什么,以及执行以后能观察到什么结果。
我们从一个问题出发,先设计算法,再用某种编程语言写程序。编译器把程序翻译成机器相关的指令,汇编语言是这些机器指令的一种可读表示。指令最终以二进制机器码存入内存,由底层微架构和电路执行。ISA 就位于程序与微架构之间:不同的硬件实现,只要遵守同一套约定,就应正确执行这套 ISA 所定义的程序行为。
这个约定要包含哪些东西?首先是内存的组织。我们需要知道地址能区分多少个位置,也要知道每一个地址究竟对应多大的存储单元。后一个概念叫 addressability。例如字节寻址表示每个地址对应一个 byte,即 8 bit;按字寻址则一个地址对应一个 word。不要把“地址有多少位”和“每个地址里有多少位数据”混在一起:前者决定能编号多少个位置,后者决定一个位置的单位。
课堂拿 LC-3、MIPS 和 x86-64 作比较。LC-3 的教学模型有 个地址,每个位置为 16 bit;x86-64 在我们接下来使用的模型里按字节寻址。课件还列出了 MIPS 的 和 x86-64 的 等数字,用来说明不同体系结构会有不同的内存约定。
纠错:课件把 MIPS 的 32 bit word 宽度写成了寻址粒度;通常 MIPS 按字节寻址。x86-64 的 指所示物理地址位宽对应的空间,须与程序使用的虚拟地址区分。
其次是寄存器集合。我们会用到 x86-64 的 16 个通用整数寄存器,MIPS 的例子则有 32 个。这个数说的是 ISA 暴露给程序的寄存器,不等于 CPU 内部只允许有这么多物理存储位置。微架构可以有自己的实现办法,但软件只能按 ISA 的规定命名和操作这些可见寄存器。
最后是指令本身:opcode 告诉机器要做什么,操作数的数据类型和宽度告诉机器处理多少位、按什么规则处理,addressing mode 告诉机器到哪里找到数据。后面我们会逐条看这些约定如何体现在汇编语法里。
为什么有 CISC 和 RISC
历史上有两种常见的设计思路。CISC 是 Complex Instruction Set Computer,复杂指令集;RISC 是 Reduced Instruction Set Computer,精简指令集。
我们先用教学中的典型特征来区分。RISC 倾向于规则、相对简单的指令,经典设计常采用统一的指令长度,便于取指、译码和流水线组织。CISC 则倾向于提供较丰富的指令,指令可以具有不同长度、不同复杂程度,一条指令可能包含较多工作。我们以 ARM 和 x86 分别作为两类思路的例子。
为什么要设计复杂而且不等长的指令?把时间往前推,内存和存储都很昂贵。如果一个简单操作能用很短的编码表达,就不必为它固定预留和复杂操作一样长的空间;如果一条专用指令能表达原本要写好几条指令的工作,也可能缩小程序。这样,在资源受限的机器中就能容纳更多程序。x86 指令以字节编码,简单指令可以使用较短编码。
但不等长和复杂操作也有代价。处理器必须识别指令边界,判断本条指令到哪里结束;不同指令完成工作所需的过程可能差别很大。这些问题会在后面的微架构和流水线中变得具体。现在先记住,紧凑的编码和规则的硬件处理之间存在取舍。
摩尔定律描述了晶体管数量随年代增长的趋势。随着可以使用的晶体管增加,处理器能够实现更多功能,指令集也不断扩展。但扩展并不是把旧设计全部推倒:过去已经有大量程序依赖原有指令和编码,新的机器仍然需要兼容它们。我们可以把这种演化想成一座不断加建的房子;早期接口一旦形成,后面的设计就受到原有结构约束。
x86 因而很难简单地对外换成完全不同的一套 ISA。一个实际办法是在内部把外部复杂指令翻译成更简单的微操作,再交给内部执行机构。于是,软件看到的仍然是 CISC 风格的 x86 接口,内部实现可以采用较规则的处理方式。我们要区分对程序作出的承诺与兑现承诺的内部结构。兼容性会长期约束 ISA 的演化。
从字节内存理解指针
现在回到程序员实际能看到的机器。我们可以把内存想成一个很长的 byte 数组。每个 byte 都有地址,地址就像数组下标。指针变量也占存储空间,但它存放的内容是地址。
看一个简单的 C 例子:
char a = 4;
char b = 3;
char *c;
c = &a;
b += *c;
假定 a 位于地址 0x10,b 位于 0x11,指针变量 c 自己位于 0x24。这些地址只是为了画图,不是语言规定的实际布局。声明 c 以后,不能把其中未初始化的内容当成合法地址使用;执行 c = &a 后,c 保存的是 0x10。
&a 是取地址,*c 是解引用。最后一句并不是把指针的数值 0x10 与 3 相加,而是先到 c 保存的地址 0x10 去取数据,取到 4,再计算 ,写回 b。执行以后,a 仍然是 4,c 仍然保存 0x10,改变的是 b。
我们因此要时时分清三件事:变量自己的存放位置、变量中存的内容,以及把该内容解释为地址后访问到的数据。指针变量的那一行表格不能理解成整个指针只占一个 byte;在接下来使用的 64 位环境里,指针占 8 byte。
汇编程序员看到的机器状态
内存里既有程序的机器码,也有程序处理的数据,还有支持运行时函数调用的栈。课件把它们画成 code、data、stack 三个区域,是为了看清它们各自的用途。CPU 从 code 中取到的是二进制指令,并不是屏幕上显示的 mov、add 这些字符串。
CPU 内部还有寄存器文件,register file。它同样存储数据,但更小、更快。课件用寄存器约 0.5 ns、内存约 15 ns 的访问延迟,以及 128 B 与 16 GB 的容量,来说明数量级差异。16 个通用寄存器,每个 8 byte,合计正好是 byte。我们写汇编或编译器分配数据时,都希望把经常用的数据尽量放进寄存器,减少较慢的内存访问。
16 个通用整数寄存器可以写为:
%rax  %rbx  %rcx  %rdx  %rsi  %rdi  %rbp  %rsp
%r8   %r9   %r10  %r11  %r12  %r13  %r14  %r15
前面一些名称来自历史用途,后来新增的寄存器则直接编号。我们不能仅凭名字把一个寄存器的用途完全固定死,但有些寄存器在调用约定中确实承担特定职责,例如 %rsp 用作栈指针。
每个寄存器有 64 bit。我们还可以通过不同名称访问同一个寄存器的低位部分:
| 名称 | 访问范围 | 大小 |
|---|---|---|
%rax |
全部 64 位 | 8 byte |
%eax |
低 32 位 | 4 byte |
%ax |
低 16 位 | 2 byte |
%al |
低 8 位 | 1 byte |
它们是同一个寄存器的不同视图,不是四个互不相关的存储单元。在课件使用的数据模型里,char、short、int、long、指针分别占 1、2、4、8、8 byte。浮点数另有相应的寄存器集合,我们这部分主要看整数操作。
我们还需要知道程序执行到了哪里,这就需要 program counter,程序计数器。在 x86-64 中对应 instruction pointer %rip。它保存指令地址,处理器据此取下一条要执行的指令。它不是一个可以像 %rax 那样随意作为普通 mov 目的操作数的通用寄存器;控制流指令会按各自规则改变它。
计算发生在 ALU,即 arithmetic logic unit 中。加减、移位、逻辑运算都属于它所服务的工作。计算还会产生状态信息,例如结果是否为零、是否发生溢出,这些信息保存在 condition codes,也叫 flags 中。后面的条件跳转会读取它们。
我们可以把指令分成几类:计算指令负责算术和逻辑运算;数据搬运指令负责把数据放到合适的存储位置;控制指令改变执行顺序,用来实现条件分支、循环与函数调用。机器执行时,大体要做取指、译码、读取操作数、执行、写回,然后调整 PC,继续处理下一条。适用的计算指令还会更新条件码。
AT&T 语法:先源、后目的
下面我们采用 AT&T 汇编语法。先把最容易混淆的一条规则固定下来:源操作数在前,目的操作数在后。 寄存器名前加 %,立即数前加 $。我们先看
movq %rdx, (%rdi)
它把 %rdx 中的 8 byte 数据复制到内存中,目标地址是 %rdi 保存的数值。这里 mov 名字虽然叫“移动”,源位置的数据不会因此被清除。括号 (%rdi) 表示按地址访问内存;没有括号的 %rdi 才表示寄存器本身。若把 %rdx 的值看成 a,把 %rdi 的值看成指针 p,这一句对应的是 *p = a。
我们不能把它读成 p = a,也不能读成先去 %rdx 所指的位置取值。是否解引用由操作数的写法决定,不是看到一个数值可能是地址,就自动跟着它访问内存。
先算地址,再读取或写入
最简单的内存寻址形式是 (R),有效地址等于寄存器 R 的内容。例如
movq (%rcx), %rax
是到 %rcx 所指内存读取 8 byte,然后写入 %rax。如果在括号前加常数位移,就得到 D(R):
movq 8(%rbp), %rdx
先计算 ,再从这个地址读取 8 byte 到 %rdx。它不是先读 (%rbp),然后给读出的数据加 8。这里的 8 是地址偏移,单位为 byte。
为了精确表达,记 为寄存器内容, 为从内存地址 开始的 8 byte 数据,上两条分别是
三类操作数与五种常见搬运
操作数主要有立即数、寄存器和内存三类。立即数是直接写在指令里的常数,例如 $0x400、$-533。常数没有可供写入的存储位置,所以只能作为源。寄存器和内存则都可以成为目的。
对这里的一般 movq,我们使用下面五种组合:
| 源 → 目的 | 示例 | 含义 |
|---|---|---|
| 立即数 → 寄存器 | movq $0x4, %rax |
把 4 放入 %rax |
| 立即数 → 内存 | movq $-147, (%rax) |
把 -147 写到 %rax 所指位置 |
| 寄存器 → 寄存器 | movq %rax, %rdx |
复制寄存器值 |
| 寄存器 → 内存 | movq %rax, (%rdx) |
写入 %rdx 所指位置 |
| 内存 → 寄存器 | movq (%rax), %rdx |
读取 %rax 所指位置 |
一般 mov 不允许两个显式操作数同时为内存。如果要把一个内存位置的数据复制到另一个位置,我们先读入临时寄存器,再从临时寄存器写回。
用四次搬运交换两个 long
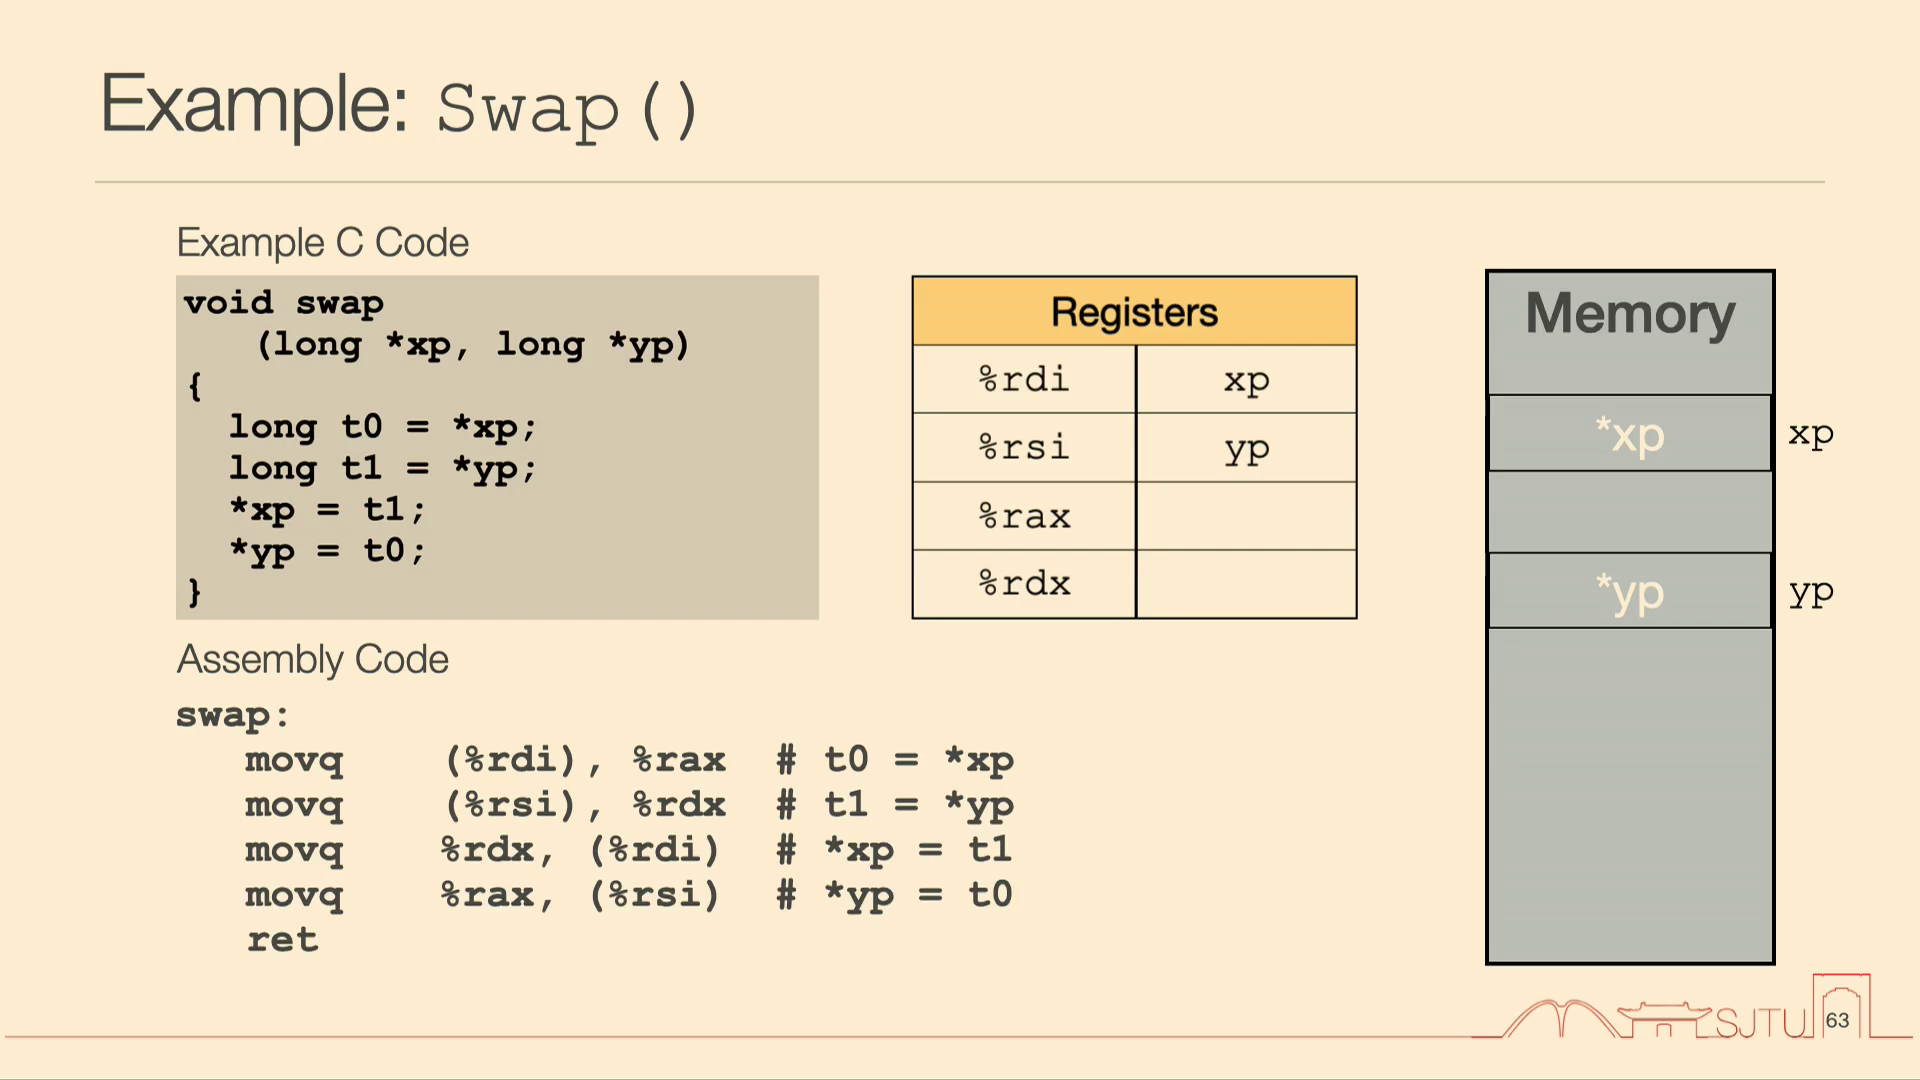
我们把这些规则放到一个完整例子中。C 程序要交换两个指针指向的数据:
void swap(long *xp, long *yp)
{
    long t0 = *xp;
    long t1 = *yp;
    *xp = t1;
    *yp = t0;
}
在本课使用的调用约定中,第一个参数位于 %rdi,第二个位于 %rsi。所以 %rdi 存的是 xp,%rsi 存的是 yp,并不是两个 long 数据本身。对应代码为:
swap:
    movq (%rdi), %rax    # t0 = *xp
    movq (%rsi), %rdx    # t1 = *yp
    movq %rdx, (%rdi)    # *xp = t1
    movq %rax, (%rsi)    # *yp = t0
    ret
第一句把 xp 所指的原值保存到 %rax,第二句把 yp 所指的原值保存到 %rdx。接着我们用 %rdx 覆盖 *xp,用 %rax 覆盖 *yp。为什么要先保存原值?因为直接写回会覆盖内存,若还没有把原值保存到别处,就会丢掉之后所需要的数据。
执行过程中两个指针的数值没有交换;交换的是它们指向的内存内容。ret 结束这个函数,返回到调用方。返回控制究竟怎样实现,我们后面再看。
LEA:计算有效地址而不访问内存
我们最后看一条很有用的指令 leaq,全称 load effective address。它的名字容易让人误以为是在加载内存中的数据,但它实际做的是计算地址表达式,把计算结果写入寄存器,不访问那个地址处的内存。
leaq 4(%rsi, %rdi, 2), %rax
这一句的作用是
我们没有在右侧再套一层 。同样的括号表达式出现在 movq 中时,是用来定位内存操作数;出现在 leaq 中,则只计算它表示的数值。括号的最终含义必须连同指令一起看。
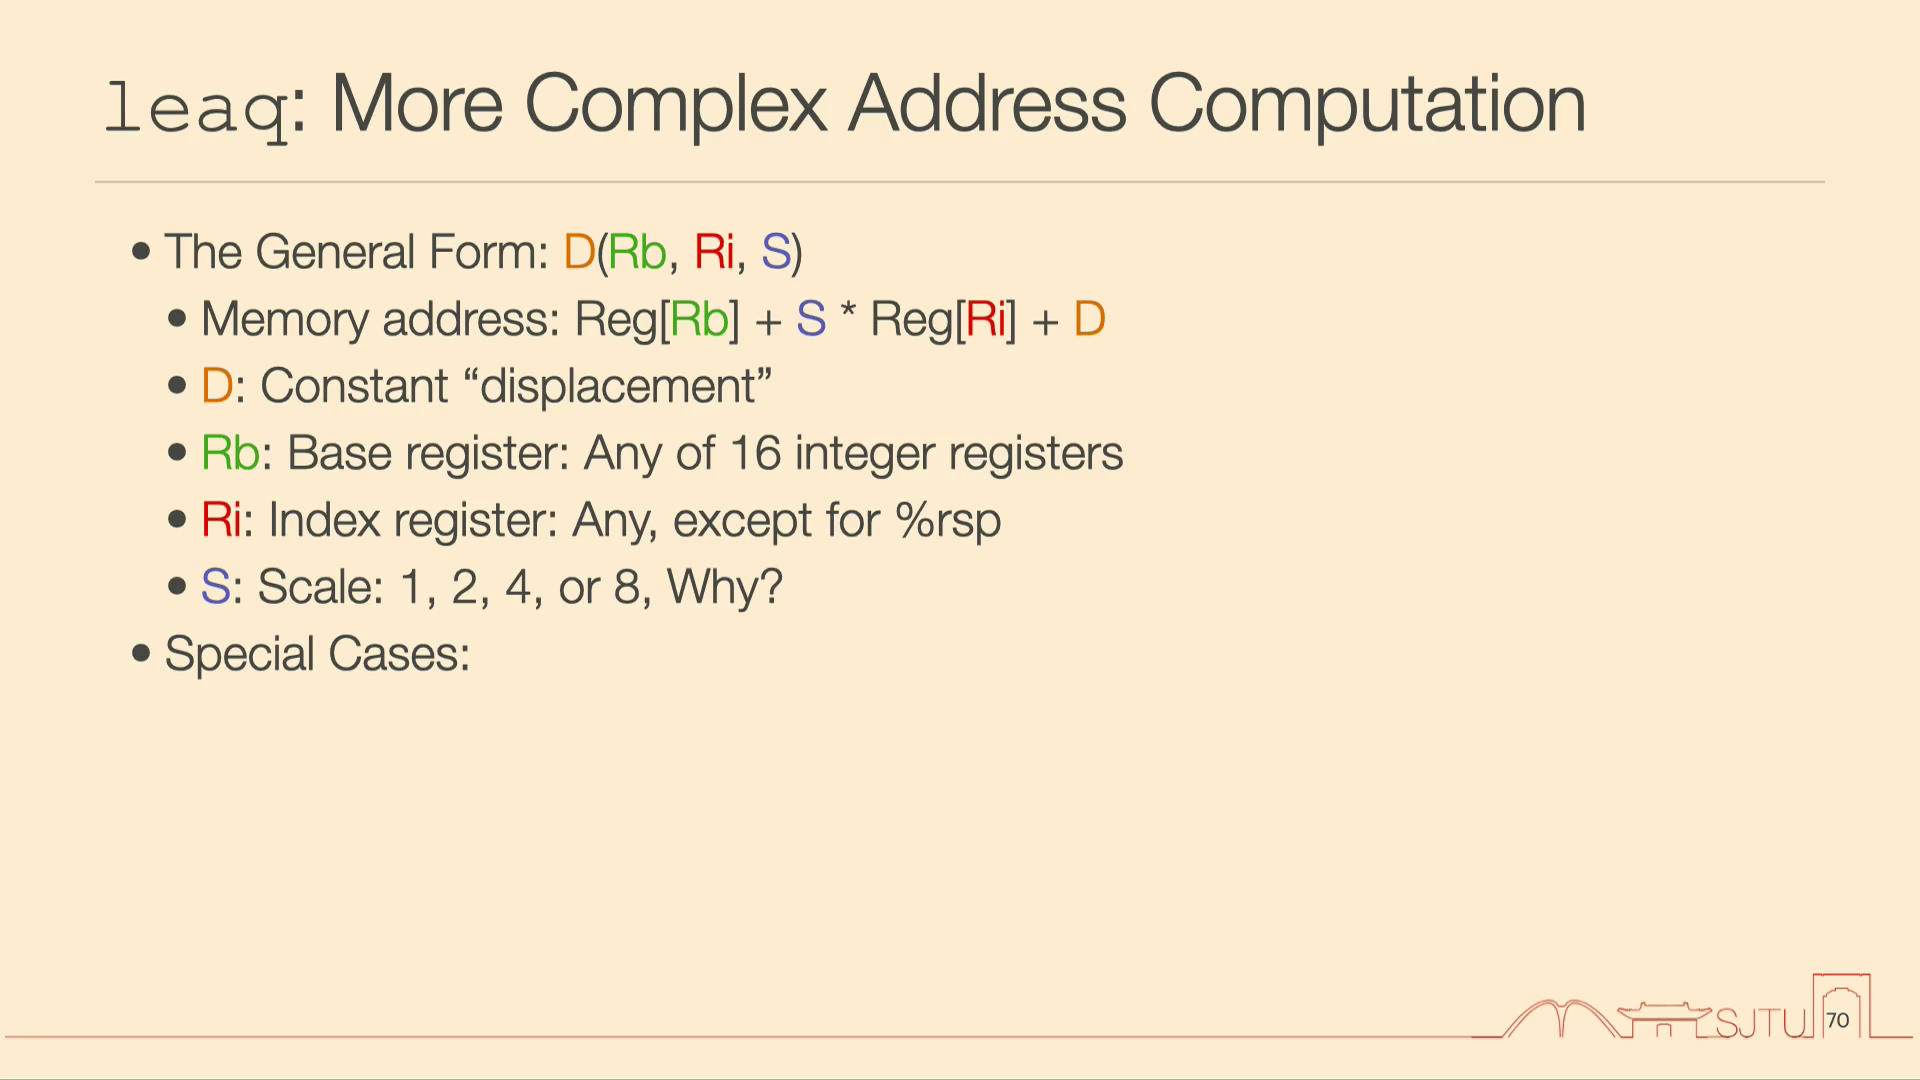
通用形式为
D(Rb, Ri, S)
其有效地址表达式为
这里 是 base register, 是 index register, 是常数 displacement, 是 scale,可取 1、2、4、8。常见数据大小正好包括 1、2、4、8 byte,所以数组下标乘以元素大小,就能转成 byte 偏移。一般索引寄存器不能使用 %rsp。
比如基地址指向一个结构,结构内某个数组在偏移 8 byte 的地方,数组元素为 4 byte,那么 8(%rax,%rbx,4) 形式的表达式就能计算第 %rbx 个元素的地址:先从基地址跨过 8 byte 的字段,再移动 byte。我们若需要 p = &x[i],只要计算地址;真正读取 x[i] 的数据则还需要相应的内存访问指令。
组成部分也可以省略。没有 displacement 时按 0 处理,没有显式 scale 时按 1 处理:
| 形式 | 计算结果 |
|---|---|
(Rb,Ri) |
|
D(Rb,Ri) |
|
(Rb,Ri,S) |
leaq 还可以用来做普通整数运算。寄存器中究竟存的是“地址”还是“整数”,并不会改变这条指令对这些 bit 做的加法和倍乘。因此,当计算正好符合这个表达式时,编译器可以利用 lea 完成算术工作。我们今天先把数据从哪里来、怎样搬运、怎样计算地址这几件事弄清楚;算术、逻辑和条件控制接着往下讲。
来源与补全:据 2026-10-08 A(170336)、B(168158)完整转写,核对 Lecture 6 PDF 215—260 页、Lecture 7 PDF 2—218 页。布尔推导、指针状态及搬运符号补齐中间步骤;汇编按课程的 64 位数据模型及 System V AMD64 约定整理。截图沿用已核实的回放帧。