Lecture 7
Abstract
我们学习 x86-64 算术与条件码,逐步推导有符号和无符号跳转,读懂循环与跳转表,再通过栈和一个函数调用例子连接参数、返回值与寄存器保存。
我们先把上次的两条主要指令接起来:mov 负责复制数据,lea 负责计算有效地址。普通 mov 的源可以是立即数、寄存器或内存,目的可以是寄存器或内存,但这里的一般形式不允许两个显式操作数同时为内存。lea 则只计算地址表达式,不读取该地址处的数据。
例如 leaq 4(%rsi,%rdi,2),%rax 得到的是 。通用地址形式 D(Rb,Ri,S) 有基址、索引、比例和位移四个组成部分,比例可以是 1、2、4、8;省略比例时按 1,省略位移时按 0。这些大小适合把数组下标换算成字节偏移。把数据放到合适位置以后,我们就要看怎样运算,以及怎样根据运算结果改变程序的执行方向。
算术和逻辑指令怎样改写目的操作数
我们继续采用 AT&T 语法:源在前,目的在后。两个操作数的常见运算把目的同时作为输入和输出。以 addq src,dest 为例,计算的是 dest + src,结果写回 dest。减法尤其要注意顺序:subq src,dest 做的是 dest - src。
| 指令 | 对目的操作数的操作 |
|---|---|
addq src,dest |
dest = dest + src |
subq src,dest |
dest = dest - src |
imulq src,dest |
dest = dest * src,此形式保存低 64 位 |
salq count,dest 或 shlq count,dest |
左移,低位补 0 |
sarq count,dest |
算术右移,高位补原符号位 |
shrq count,dest |
逻辑右移,高位补 0 |
xorq src,dest |
按位异或 |
andq src,dest |
按位与 |
orq src,dest |
按位或 |
这里 q 表示 quad word,即 8 byte、64 bit。x86 汇编的 word 是 2 byte,因此 quad word 是四个 word。其他常见后缀是 b 表示 1 byte,w 表示 2 byte,l 表示 4 byte。后缀要与寄存器名称的宽度相配,不能写 movl $0,%rax 而把一个 32 位操作配上 64 位寄存器名。
为什么右移分成算术和逻辑两种?因为同一串 bit 可以被理解成无符号数,也可以被理解成补码有符号数。若希望右移负数时继续保持有符号含义,就要从左边补原来的符号位;若只把它当作无符号位串处理,就从左边补 0。两种左移的位级效果则相同,sal 与 shl 是同义名称。
移位经常可以表达乘以或除以 2 的幂,但要留意有限位宽和舍入。左移可能把高位移出去,不能保证有符号数的数学结果仍然可表示;算术右移负数时相当于向负无穷方向取整,与 C 中有符号整数除法向零截断并不总相同。这里把“位操作”和“数学上不受限制的乘除法”分开,后面看程序才不会产生误解。
我们先问一个问题:既然我们分有符号和无符号整数,为什么这里没有两种不同的 addq?原因是固定宽度的加法对 bit 的处理相同。若宽度为 ,保存在目的位置的低 位结果都是
差别在于我们怎样解释结果,以及怎样判断溢出。有符号与无符号运算可以共用同一个加法电路,而用不同标志说明超出各自范围的情况。减法也有类似性质。
还有只有一个显式操作数的指令:
| 指令 | 操作 |
|---|---|
incq dest |
dest = dest + 1 |
decq dest |
dest = dest - 1 |
negq dest |
取补码意义下的负值 |
notq dest |
每个 bit 取反 |
加一、减一的另一个操作数 1 已经隐含在指令里,不必再写出来。取负和按位取反本来也只需要一个输入。不要把 neg 和 not 混同:对固定宽度补码,取负的位级关系是 ~x + 1,单独取反还差最后的加一。
控制流需要回答两个问题
一个程序通常不只是按固定顺序做完所有计算。if/else 要在两个分支中选择,循环要回到前面继续执行,函数调用要转到另一段代码再返回。它们都要改变 control flow,也就是指令执行顺序。
实现条件控制时,我们要回答两件事:怎样测试条件、保存测试结果;怎样根据这个结果,把执行位置改到正确的指令地址。每条机器指令都有地址,汇编里的 label 则是指令地址的符号名称。标签不做计算,它只是让我们可以用名字指代一个位置。
我们看求两个有符号 long 的差的绝对值的例子:
long absdiff(long x, long y)
{
    long result;
    if (x > y)
        result = x - y;
    else
        result = y - x;
    return result;
}
在本课的调用约定中,x 位于 %rdi,y 位于 %rsi,整数返回值位于 %rax。课件用下面的命令展示一种保留分支的汇编输出:
gcc -Og -S -fno-if-conversion control.c
-S 要求生成汇编;-Og 采用适于调试的优化设置;-fno-if-conversion 关闭相应的 if 转换,便于观察这里的条件跳转。
absdiff:
    cmpq %rsi, %rdi
    jle .L4
    movq %rdi, %rax
    subq %rsi, %rax
    ret
.L4:                         # x <= y
    movq %rsi, %rax
    subq %rdi, %rax
    ret
如果 x > y,我们顺着往下走:先让 %rax=x,再做 %rax -= y,得到 x-y。如果 x <= y,则跳到 .L4:先让 %rax=y,再减去 x,得到 y-x。我们今天先把 ret 理解为把控制交还给调用方,返回值已经按约定放在 %rax 中;返回控制的底层实现还需要栈的支持。
CMP 不保存差值,而是设置条件码
我们再往下追问:cmpq 比较两个数,得到的结果放在哪里?会写回 %rdi 吗?不会。后面的两个分支还要使用原来的 x 和 y。如果比较把其中一个覆盖掉,后面的计算就错了。
cmpq src,dest 在内部按 dest - src 进行计算,用结果设置条件码,却不把差值写回目的操作数。所以
cmpq %rsi, %rdi
比较的基础是 。随后 jle .L4 读取条件码,如果有符号“小于或等于”的条件成立,就改变指令指针,去执行 .L4 开头的代码;否则继续执行紧接着的一条。
条件码属于程序可见状态的一部分,常用的四个是:
| 标志 | 名称 | 设为 1 的条件 |
|---|---|---|
| ZF | Zero Flag | 截断到操作宽度的结果为 0 |
| SF | Sign Flag | 结果最高位为 1,即按补码解释为负数 |
| CF | Carry Flag | 加法产生无符号进位;减法发生无符号借位 |
| OF | Overflow Flag | 按有符号数解释时,数学结果超出可表示范围 |
“set a flag” 指把它置成 1;不满足对应条件时为 0。CF 和 OF 不是同一种“溢出”的两个名字。无符号范围是 ,有符号范围是 ,同一个运算可能只超出其中一个范围,也可能都超出或都不超出。
为什么有符号比较不能只看符号位
假设我们想判断 x <= y。如果 ,显然相等,ZF 为 1。若不相等,我们想判断 x < y,直觉上可以看差是否为负。但这是有限位宽运算:真实数学差超出范围以后,保留下来的 bit 可能给出相反的符号。
我们因此分两种情况。若没有有符号溢出,OF=0,结果符号可信,SF=1 表示小于。若有有符号溢出,OF=1,保存的结果符号发生翻转,此时 SF=0 才对应真实数学差为负。合起来就是
进而
这就是 jle 检查的条件。
例如一个很大的正数减去 -1,真实结果更大,但可能超过最大正数而回绕成负数。此时 SF=1、OF=1;它看起来为负,却不表示原来的正数小于 -1。反过来,一个极小的负数减去很大的正数,可能回绕成正数;此时 SF=0、OF=1,异或仍然能反映真正的小于关系。
四道课堂判断题
下面每一行都执行 cmpq %rsi,%rdi,再执行 jle .L4。一定先确定 q 是 64 位,再解释十六进制数。
第一行最容易因为只看两位十六进制而误判。0xFF 在这里表示 64 位值 0x00000000000000FF,是 255;0x80 是 128。它们都不是按 8 位补码解释的负数。差为 127,没有溢出,所以不跳。
第二行差为 0,ZF=1,满足“小于或等于”中的等于。零的最高位为 0,SF=0,减去自身也不产生有符号溢出,OF=0。
第三行左边是最小的 64 位有符号数 ,右边是 -1。减去 -1 相当于加 1,得到 ,仍是负数,并没有溢出。SF=1、OF=0,所以跳转。最小负数并不是“负数中最大的数”;这里一定按补码的数值顺序判断。
第四行左边是最大正数 ,减去 -1 的数学结果是 ,超出正数上界,保留下来的 bit 恰好是最小负数的编码。因此 SF=1、OF=1,异或为 0,不跳。这一行正好说明,单独看到结果最高位为 1,不能断定比较时左边更小。
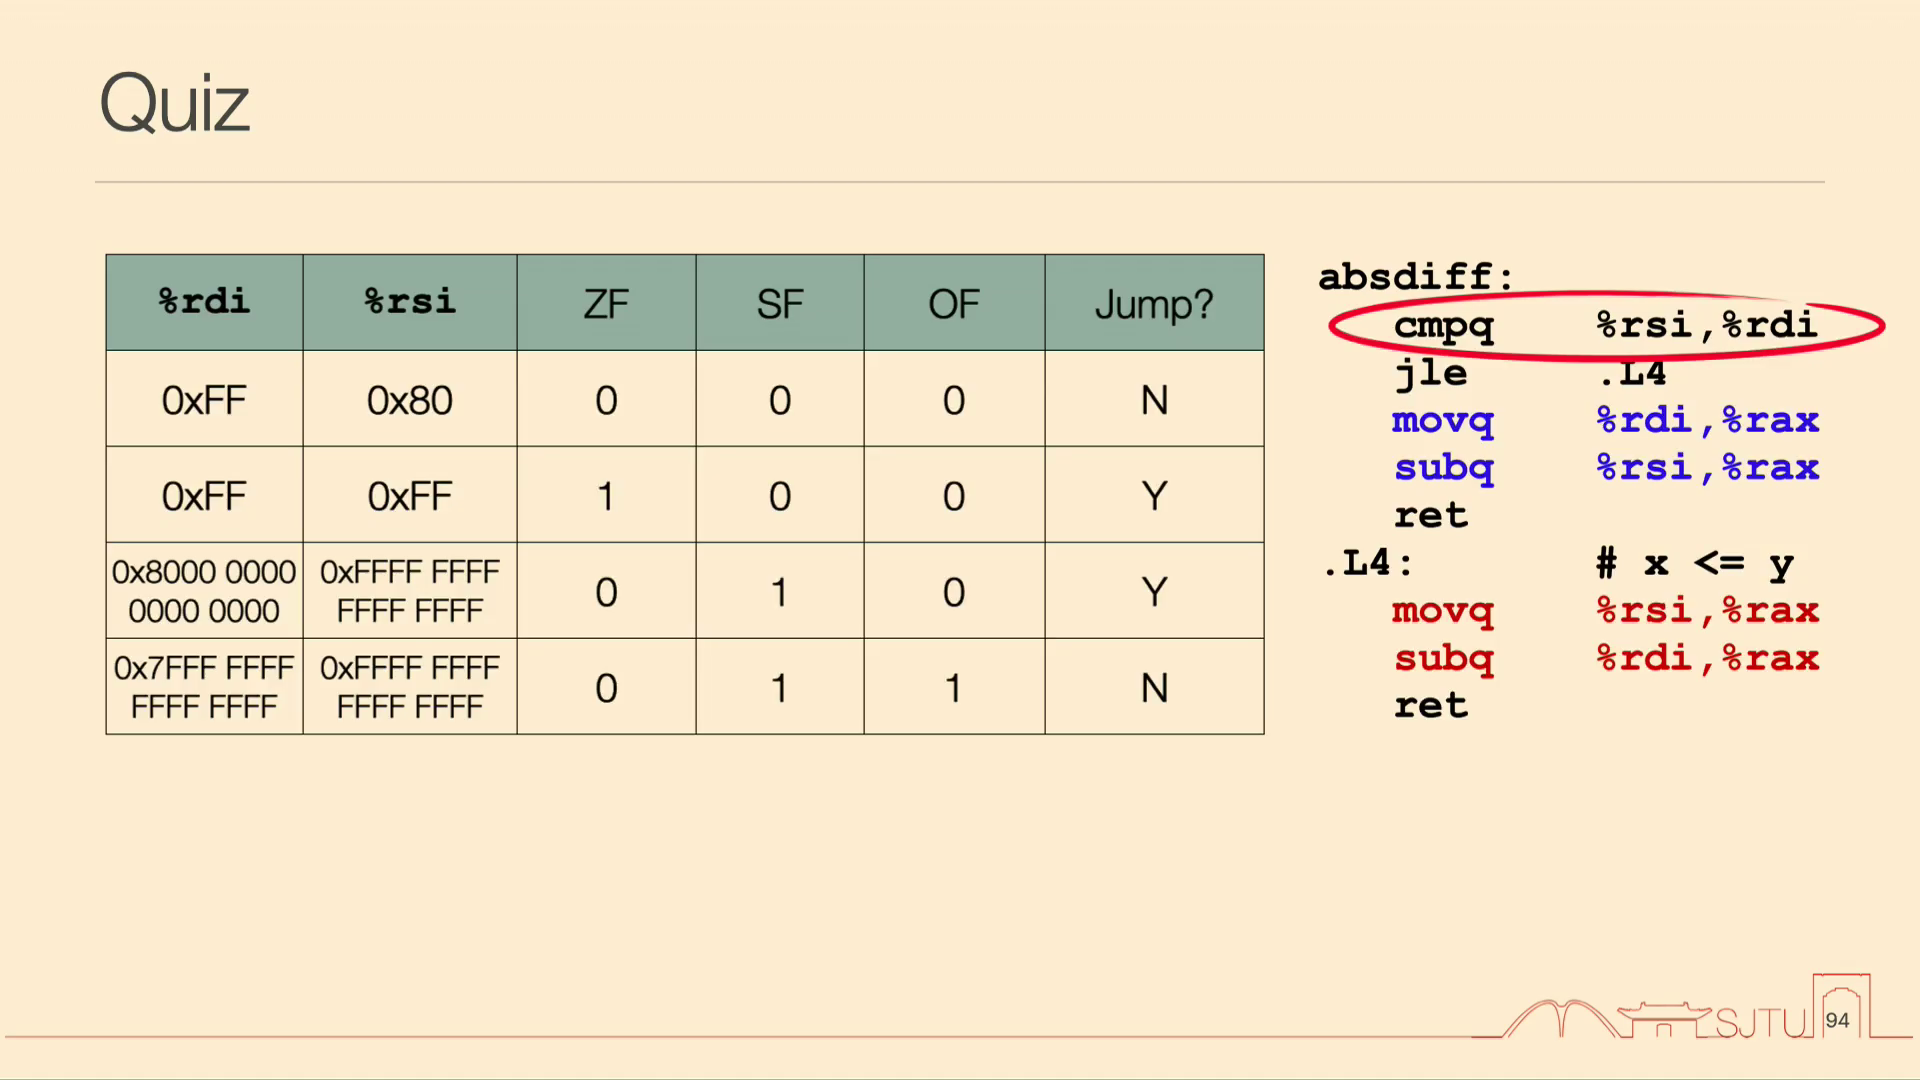
有符号与无符号跳转使用不同的标志组合
对 cmpq %rsi,%rdi,令 、。有符号比较采用 less/greater 这组名字:
| 指令 | 含义 | 跳转条件 |
|---|---|---|
jg |
signed | |
jl |
signed | |
jge |
signed | |
jle |
signed |
jg 为什么要求 SF=OF?如果两者都为 0,差是非负且未溢出;如果两者都为 1,真实的非负结果由于溢出变成负数。再排除 ZF=1 的相等情况,就得到严格大于。
无符号比较用 above/below 来区分。无符号减法若 ,需要借位,CF=1;若 ,CF=0。因此
| 指令 | 含义 | 跳转条件 |
|---|---|---|
ja |
unsigned | |
jb |
unsigned | |
jae |
unsigned | |
jbe |
unsigned |
我们没有换一套 cmpq;同一条比较产生相同的 flags,后面的跳转指令选择不同的解释。0xFFFFFFFFFFFFFFFF 若按有符号是 -1,若按无符号则是 ,所以更换 signed/unsigned 条件时,大小关系可以完全改变。字母 e 表示 equal,l/g 对应 less/greater,b/a 对应 below/above。
此外,jmp 是无条件跳转,不读条件决定是否执行;je 和 jne 分别在 ZF=1、ZF=0 时跳转。后者名字虽然是“不相等”,在前一条设置标志的运算直接产生零/非零结果时,也可以用来判断这个结果。
运算自己也能设置条件码
我们不一定要在每次跳转前都插入 cmp。例如
addq %rax, %rbx
除了把和写回 %rbx,还设置相应的条件码:保存的和为 0 时 ZF=1,最高位为 1 时 SF=1,无符号进位时 CF=1,有符号溢出时 OF=1。如果下一步就是判断这次结果的某种性质,可以直接利用它产生的 flags,省掉额外比较。
这些状态信息还可以支持超过单个寄存器宽度的大整数运算:我们可以把一个大整数拆成若干块,低位块产生的进位作为高位块的输入。课堂这里只说明进位信息的用途,并没有展开多精度运算的完整指令序列。
各指令更新条件码的规则不同。例如 mov、lea 不修改这里的条件码;inc/dec 不改 CF;not 不改 flags;乘法的各个标志也不能一概当成加法的规则使用。我们分析具体程序时,必须追踪离跳转最近、实际定义了所用标志的那条指令。
从 do-while 到汇编:逐位数 1
我们用 popcount 例子看循环。输入为 unsigned long x,我们要数它的 64 位表示中有多少个 1:
long pcount_do(unsigned long x)
{
    long result = 0;
    do {
        result += x & 0x1;
        x >>= 1;
    } while (x);
    return result;
}
x & 1 只留下最低位,结果为 0 或 1;把它累加到 result,再让 x 逻辑右移一位。这样,原来的第二低位变成最低位,下一次继续处理。每处理一位就向右移动,直到 x=0,说明剩下已经没有 1。
这里使用无符号类型非常关键。若把负的有符号数用算术右移来处理,高位不断补 1,最后可能停在 -1 而永远不会变成 0;这里的逻辑右移会逐渐把所有位移出去。
我们可以先把循环写成显式的标签与跳转,这样更接近汇编:
long pcount_goto(unsigned long x)
{
    long result = 0;
loop:
    result += x & 0x1;
    x >>= 1;
    if (x)
        goto loop;
    return result;
}
这两个版本的语义相同。loop 只是标签名,换成其他合法名称也不影响计算。相应汇编可以写为:
pcount_do:
    movl $0, %eax         # result=0,32位写也清零%rax高32位
.L2:
    movq %rdi, %rdx       # x的临时副本
    andl $1, %edx         # 只留最低位,写%edx也清零%rdx高32位
    addq %rdx, %rax       # result += x & 1
    shrq $1, %rdi         # unsigned x >>= 1,并设置ZF
    jne .L2              # 右移结果非零,则继续
    ret
课件原页写成了 movl $0,%rax、andl $1,%rdx,这是后缀与寄存器宽度不匹配。这里按同一计算意图修正为 %eax、%edx。l 是 4 byte,不能解释成“只操作最后一个 byte”;真正的 1 byte 名称是 %al 等,后缀是 b。
还要补上一条 x86-64 的规则,才能看懂这个程序:写入 32 位通用寄存器会把对应 64 位寄存器的高 32 位清零。 所以 movl $0,%eax 确实将整个 %rax 清零;andl $1,%edx 的结果只能是 0 或 1,高 32 位同样清零,后面的 addq 可以正确把整个 %rdx 当作这个小整数使用。写 8 位或 16 位子寄存器没有同样的自动清零规则。
我们现在回答另一个问题:这里根本没有 cmp,jne 根据什么跳?根据前面的 shrq。右移一位后,如果 %rdi 仍非零,ZF=0,于是 jne 回到 .L2;若右移结果为零,ZF=1,便顺序执行 ret。jne 只读取标志,不负责把它设置成某个值。前面的 addq、andl 也会影响 flags,但已经被后来的 shrq 更新,不能拿它们的结果解释当前跳转。
循环究竟运行多少次
我们再问:这个循环会执行固定 64 次吗?不一定。它的次数在 1 到 64 之间。因为是 do-while,即使输入一开始就是 0,也先执行一次循环体,然后检查,因而最少为 1。
若输入非零,次数由最高的那个 1 所在的位置决定。比如 ,处理一次后右移成 0;,二进制为 1000,要经过四次右移才变成 0。若最高位即第 63 位为 1,就要运行 64 次。用公式写,原输入 时,次数是
这和结果中 1 的个数不是同一个量:1000 只有一个 1,但这里仍循环四次。我们分析代码运行次数时,要看它每次删去一位,还是每次删去一个 1。
一般循环如何转成标签与跳转
我们可以把刚才的过程推广。一个 do-while 总是先执行循环体,再计算测试条件:
/* 初始化 */
loop:
    /* 循环体 */
    if (test)
        goto loop;
/* 后续代码 */
汇编中就用一个循环入口标签,接循环体、计算测试条件的指令,再接一条满足条件就回到入口的条件跳转。它的关键性质是循环体至少执行一次。
while 则先检查条件,第一次检查就可能失败,循环体因而可以一次也不执行。一个直接的转换方式是:
/* 初始化 */
    goto test_label;
loop:
    /* 循环体 */
test_label:
    if (test)
        goto loop;
/* 后续代码 */
我们先无条件跳到测试位置,只有测试通过才进入循环体。之后每次循环体结束,都再次来到测试位置。对应的汇编骨架也是“入口 jmp 到测试 + 循环体标签 + 测试标签 + 条件回跳”。具体布局可以变化,但不能丢掉 while 在第一次执行循环体前就要判断的语义。
因此,我们可以先把高级语言循环翻译成语义相同的 goto 形式,再把标签、运算和条件跳转一一对应到汇编。这个中间步骤能帮我们避免只凭代码长相猜控制流。
Switch:把 case 映射到代码地址
最后一种控制结构是 switch。看这个例子:
long switch_eg(long x, long y, long z)
{
    long w = 1;
    switch (x) {
    case 1:
        w = y * z;
        break;
    case 2:
        w = y / z;
        /* 有意继续执行case 3 */
    case 3:
        w += z;
        break;
    case 5:
    case 6:
        w -= z;
        break;
    default:
        w = 2;
    }
    return w;
}
case 2 后面没有 break,所以先计算 y/z,再继续执行 case 3 的 w += z,最终得到 y/z + z。如果直接从 case 3 进入,w 还保持初始的 1,得到的是 1+z。这叫 fall-through,不能把 case 2 和 case 3 当成两个完全隔离的函数。
case 5 和 case 6 则共用同一段代码,都得到 1-z。其余未列出的输入进入 default,结果为 2。
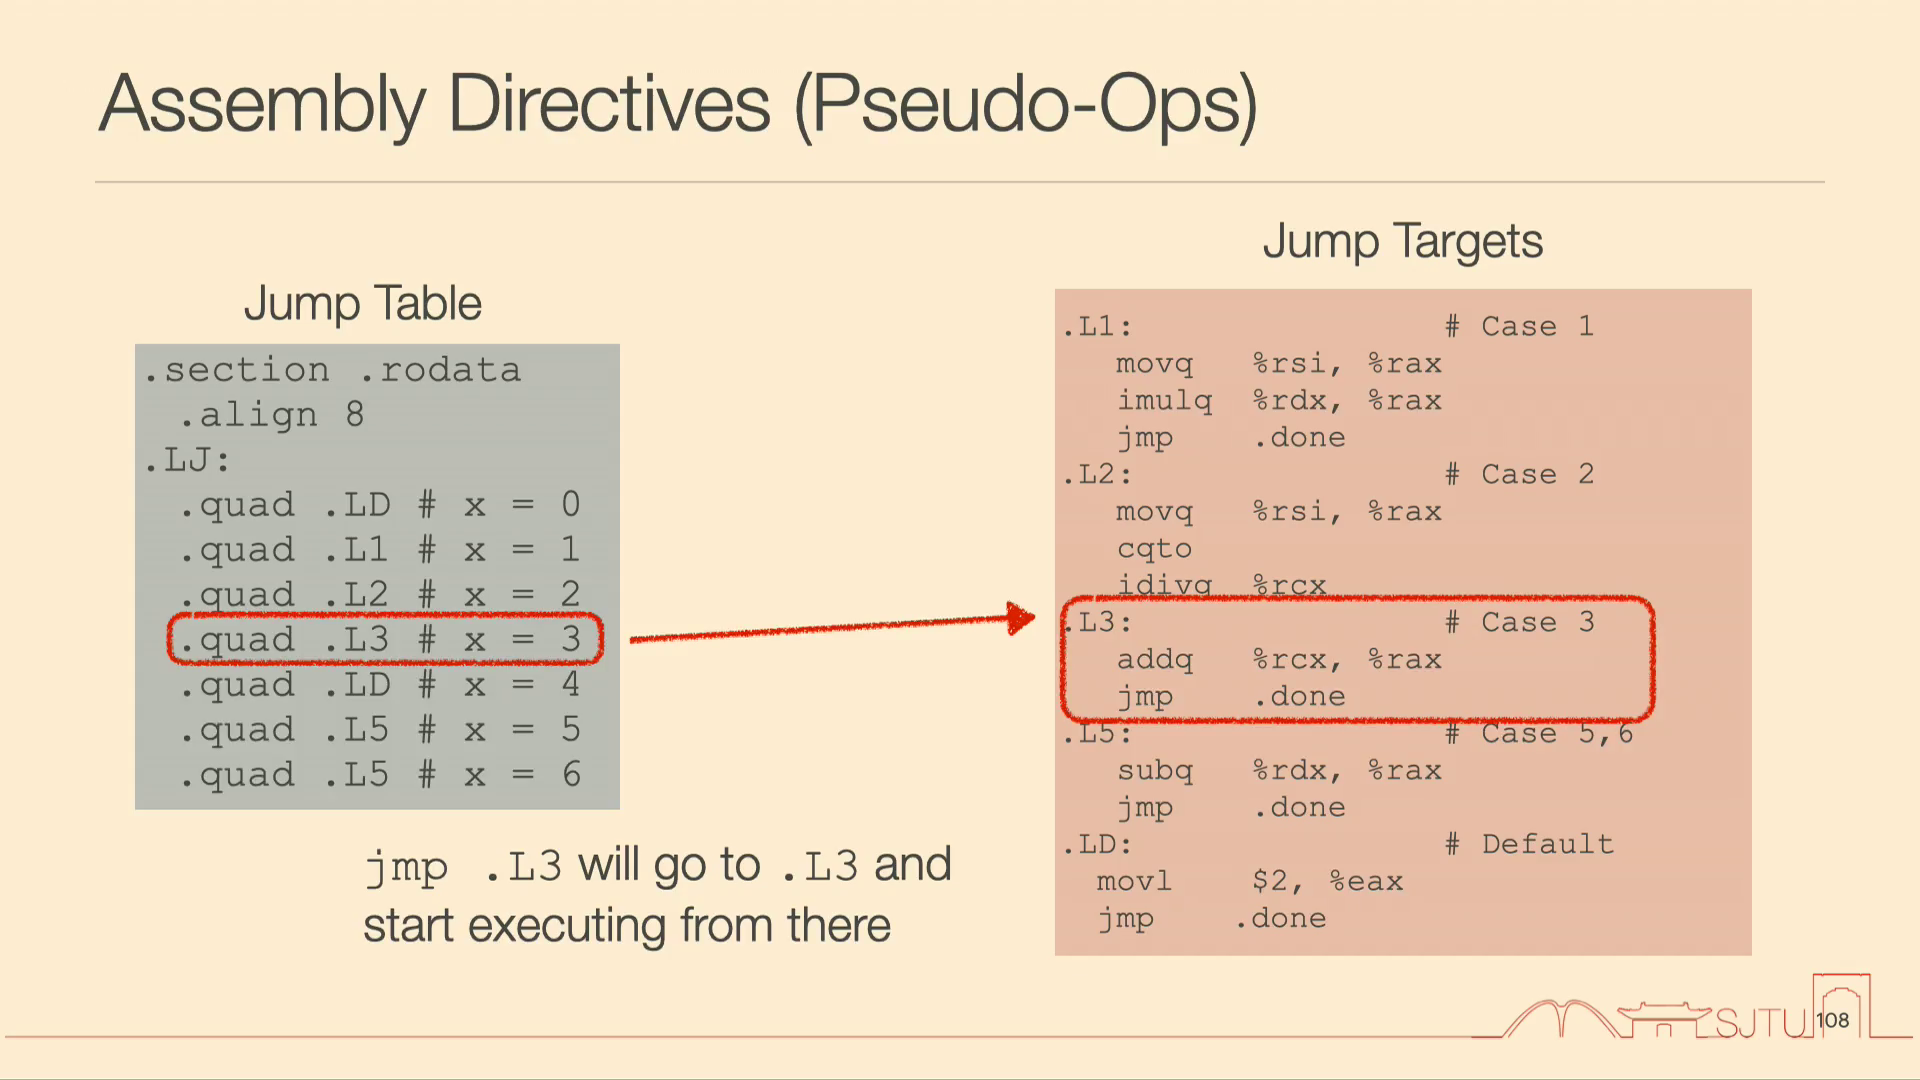
一种实现方法是 jump table,跳转表。我们把各段代码的入口地址放到一张表里,根据 x 查到目标地址,再跳到那里执行。例如索引 0—6 可以这样对应:
    .section .rodata
    .align 8
.LJ:
    .quad .LD            # x=0 -> default
    .quad .L1            # x=1
    .quad .L2            # x=2
    .quad .L3            # x=3
    .quad .LD            # x=4 -> default
    .quad .L5            # x=5
    .quad .L5            # x=6,与5共用入口
.L1、.L2 等是代码入口的标签,表项存放的是它们表示的地址。两个表项可以保存同一个地址,因此 case 5 与 case 6 不必复制两份代码。case 2 入口执行完自己的计算后,可以顺序落到 .L3;break 则对应转去统一的结束位置,例如 jmp .done。
这些带点的指示并不是交给 CPU 执行的运算指令,而是汇编器指示。.section .rodata 指定只读数据段,.align 8 要求适当对齐,.quad 为表项安排 8 byte 并用给出的地址初始化。课堂把这些语法细节留作课后了解,当前最重要的是理解“表中保存跳转目标地址,case 值用来索引”这个结构。
查表前必须确保输入落在表所覆盖的范围里,范围外的输入应走 default。表项为 8 byte 时,索引 x 对应的表项位置是 ;从那里取出代码地址,才得到真正的跳转目标。这和前面数组寻址表达式联系起来了。课堂本次重点讲跳转表的映射与共享入口,没有逐条展开完整的范围检查、除法准备和间接跳转指令序列。
课件代码纠错:图中除法会改写
%rdx,后续还要用z,须在除法前把z保存到%rcx等位置;图中省略了这项入口准备。
函数调用不仅是跳到另一个地方
我们开始进入下一部分:functions。写程序时,我们把相同或独立的工作封装成函数。假设 main 调用 func(x),调用以前正在执行 main,调用时控制转到 func 的开头,完成以后又要回到 main 的调用点之后继续。main 是 caller,调用者;func 是 callee,被调用者。这些称呼是相对于一次调用关系而言,一个函数可以在某次关系中是 callee,又在自己调用别的函数时成为 caller。
一次函数调用至少要协调三件事。第一是 passing control,把控制交给被调用函数,并知道它结束后回哪里。第二是 passing data,把实参传过去,把返回值传回来。第三是 local memory management,为被调用函数的局部数据分配空间,在返回时释放。
例如课件用一个带 int v[10] 的函数作示意。十个 int 在这个模型里需要 40 byte,如果这些局部对象要存入内存,就要为本次调用安排位置。函数执行结束以后,这些临时空间不应继续当作仍然活着的局部变量使用。释放空间也不等于把每个 byte 都写成 0;核心是结束其使用并回收对应区域。
我们把一次正在进行的函数调用所需的记录叫 frame,栈帧,也叫 activation record。它可以包含局部数据、保存的寄存器值、参数或其他调用相关信息。寄存器也参与保存数据。现在先用栈帧这个抽象理解调用之间的组织。
为什么用后进先出的栈
看一条调用链:yoo 调 who,who 先调 am,待 am 返回后再调 I,最后 who 返回到 yoo。执行中仍然活着的栈帧依次变化为:
[yoo]
[yoo, who]
[yoo, who, am]
[yoo, who]
[yoo, who, I]
[yoo, who]
[yoo]
最后进入、尚未返回的那次调用,必须先完成,外层调用才能继续。这正是后进先出。我们不需要把已经完成的 am 永久排在 I 前面保存,也不能按队列先进先出地先清理 yoo。因此,用 stack 来组织仍然活跃的函数调用非常自然。
为了把这个模型落实成指令,我们还要逐个解决:跳到哪个函数入口、返回哪里、参数如何交接、局部变量在哪里,以及调用前后哪些状态需要保存。这些问题相互关联,我们先从最基本的栈操作看起。
x86-64 的栈向低地址增长
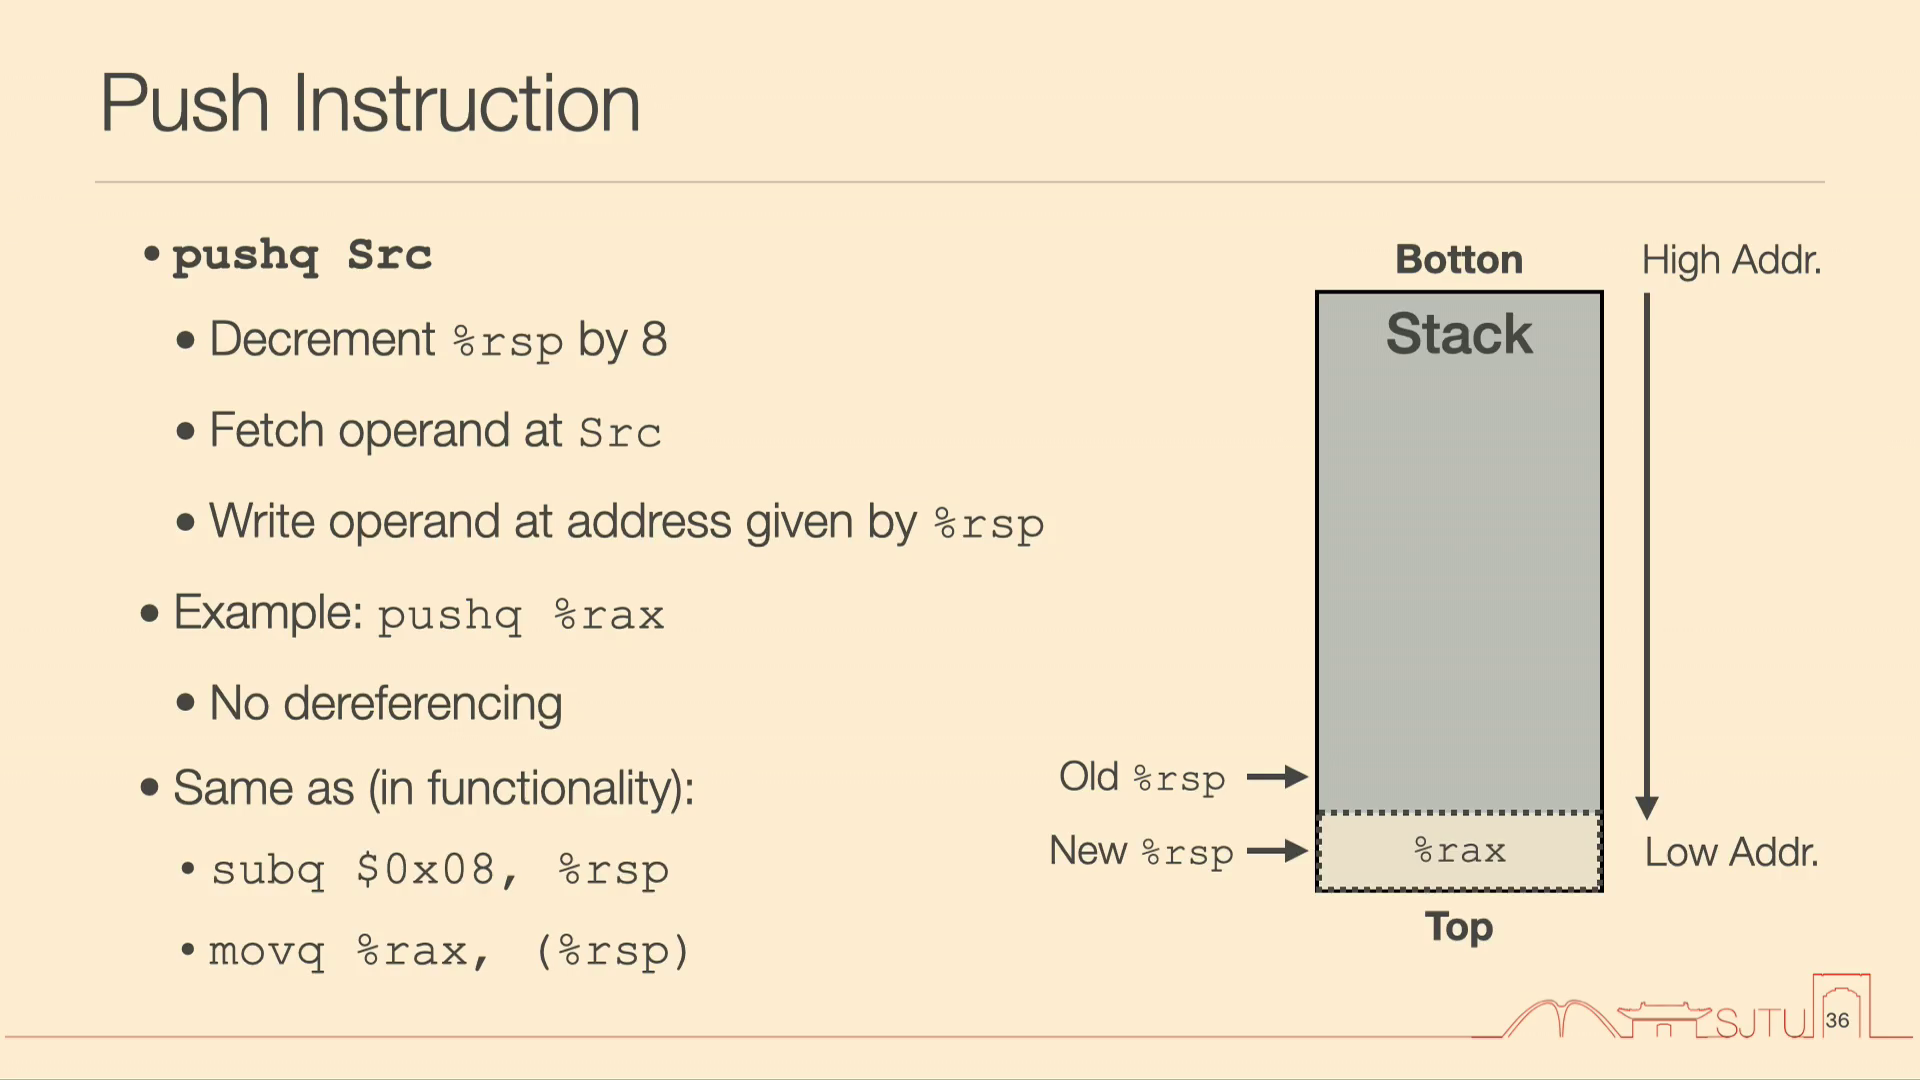
栈是内存的一块区域。我们约定栈向较低地址增长,%rsp 是 stack pointer,保存当前栈顶的地址。图里常把高地址画在上方、低地址画在下方,因此新压入的数据会出现在图的更下方;“栈顶”说的是最近使用的一端,并不等于纸面的最上面。
栈顶是当前较低地址的一端,%rsp 指向栈顶,不是栈底。 这是课堂口述中容易颠倒的一处,我们统一按指令的地址变化来判断。
Push:先为新元素留出位置,再写入
pushq src 把一个 8 byte 值压栈。在当前讨论的普通寄存器源例子中,其功能是:
因为增长方向是低地址,增加一个元素要把 %rsp 减 8。我们看
pushq %rax
被压入的是 %rax 中的数值本身,不是把 %rax 当地址再去解引用得到的数据。课堂在这一点上先口头说成了去地址取数,随后立即纠正:没有括号的寄存器操作数就取寄存器值。若写的是内存源操作数,才按相应寻址形式读取内存。
只看这次普通压栈对寄存器和内存的作用,可以用两条指令表达:
subq $8, %rsp
movq %rax, (%rsp)
但它们对完整程序状态的影响是否完全相同?不完全相同。pushq 不修改这些条件码,subq 会设置条件码,后面的 movq 又不会把它们恢复。因此两种写法可以得到相同的栈指针和栈内容,却不保证所有 flags 也相同。程序状态除了数据之外还包括 flags,分析“等价”时不能遗漏它。
一次分配多个栈位置
要存多个值,也可以先一次性安排空间,再逐个写入:
subq $0x18, %rsp           # 0x18=24 byte,三个8-byte位置
movq %rax, (%rsp)
movq %rbx, 8(%rsp)
movq %rcx, 16(%rsp)
假定旧 %rsp 为 ,执行以后新 %rsp=P-24\)。%rax 的值写到 \(P-24\),%rbx 写到 \(P-16\),%rcx写到 \(P-8\)。偏移 +8、+16 是走向更高地址;不要按图中“下面/上面”的视觉位置误解加减方向。课件的第一句漏了立即数前的$`,这里补齐。
如果要用逐个 push 得到相同的最终布局,顺序应当是:
pushq %rcx
pushq %rbx
pushq %rax
最先压入的 %rcx 停在旧栈顶附近的高地址,最后压入的 %rax 位于新栈顶。顺序必须反过来,不能把前面三条 movq 的书写顺序照搬成 push 顺序。这里比较的是普通情况下最终保存值和布局,仍要留意 subq 与 push 的条件码区别。
Pop:先读取旧栈顶,再移动栈指针
popq dest 把旧栈顶的 8 byte 值取出,写入目的位置,再把 %rsp 加 8。以普通目的寄存器 %rsi 为例:
popq %rsi
数据与指针变化可理解为
movq (%rsp), %rsi
addq $8, %rsp
顺序不能颠倒:先加 8 再读取,会取到前一个栈元素。这个两条指令的展开也只说明数据与栈指针的功能对应;addq 改 flags,popq 不改,所以不能把它们说成对完整状态严格等价。
如果我们只想丢弃顶部一个 8 byte 位置,并不需要把旧值保存在某个寄存器中,就可以把 %rsp 加 8,表示这个位置不再属于当前栈内容。这也说明出栈通常不需要把内存清零。
为什么要讲 push、pop?因为函数调用有参数、临时值和需要保存的状态,栈可以为这些数据提供位置。在一些情况下,参数也会通过栈交给下一层函数。课件当前用到的前几个整数参数通过寄存器传递。
multstore 与 mult2:一次真实的调用过程
最后我们看两个小函数,把控制、参数、返回值和保存寄存器放在一起:
long mult2(long a, long b)
{
    long s = a * b;
    return s;
}

void multstore(long x, long y, long *dest)
{
    long t = mult2(x, y);
    *dest = t;
}
它们本来不必写得这么绕,这样拆开是为了观察函数调用。课件给出的机器代码位置与汇编为:
0x400540 <multstore>:
0x400540: pushq %rbx
0x400541: movq  %rdx, %rbx
0x400544: callq 0x400550 <mult2>
0x400549: movq  %rax, (%rbx)
0x40054c: popq  %rbx
0x40054d: retq

0x400550 <mult2>:
0x400550: movq  %rdi, %rax
0x400553: imulq %rsi, %rax
0x400557: retq
地址之间的距离并不统一。0x400541 到 0x400544 相差 3 byte,0x400553 到 0x400557 相差 4 byte,call 后面下一条在 0x400549。这再次体现 x86 指令编码是不等长的;不能看到一行汇编就统一给 PC 加一个固定的“指令大小”。寄存器宽度 64 bit 也不等于每条指令编码长 64 bit。
按我们这里使用的调用约定,进入 multstore 时 %rdi=x、%rsi=y、%rdx=dest。我们先把原来的 %rbx 压栈保存,再把目的指针从 %rdx 复制到 %rbx。现在 %rbx 用来在函数调用期间保留 dest。
执行 callq 后,控制转到 mult2。参数 x,y 仍分别位于 %rdi,%rsi,在 mult2 中就作为 a,b 使用。movq %rdi,%rax 先把 a 放进返回值寄存器,接着 imulq %rsi,%rax 做乘法,把低 64 位结果留在 %rax,最后返回到 multstore 的调用后位置。
回到 0x400549 时,%rax 是乘积,%rbx 保存目的地址。于是 movq %rax,(%rbx) 把乘积写进 *dest。写回的数据来自 %rax,不是 %rdx;%rdx 最初存的是指针,不能把两者说反。接着 popq %rbx 恢复原值,retq 结束 multstore。
为什么我们使用 %rbx 前先保存它,结束前又恢复?因为它是 callee-saved register。当前函数若要使用这种寄存器,就有责任在返回以前恢复调用方原来看到的值。multstore 虽然是 mult2 的 caller,同时也是外层函数的 callee,因此对外层调用方承担保存 %rbx 的责任。保存旧值与借用它保存 dest 是两件不同的事,缺一不可。
我们到这里已经看出 call 与普通 jmp 的要求不同:不仅要跳进被调函数,还必须让 ret 知道该回到调用后哪条指令。本例应回到 0x400549。今天先把调用的代码读通;返回地址怎样借助栈保存,以及更完整的参数和局部变量管理,我们接下来继续展开。
来源与补全:据 2026-10-10 A(174207)、B(174503)完整转写,核对 Lecture 7 PDF 220—321 页与 Lecture 9 PDF 33—72 页。补齐标志推导、四题差值、循环次数及栈地址计算;课件代码错误就地纠正。截图沿用已核实的回放帧。