Lecture 8
Abstract
我们跟踪函数调用中的返回地址、参数、局部变量与寄存器保存,再从数组和结构体的布局走向对齐、内存区域及缓冲区越界,理解程序状态怎样被保存或破坏。
我们已经能用汇编表达计算和分支。现在我们把问题再推进一步:当程序从一个函数进入另一个函数时,机器究竟要记住什么?不能只把程序计数器改成被调用函数的入口,因为执行完以后还要回来;也不能只传几个参数,因为调用者原先保存在寄存器中的数据可能还要继续使用。我们要把这些要求组织成一套彼此配合的规则。
我们把发起调用的函数叫作调用者(caller),把被调用的函数叫作被调用者(callee)。同一个函数可以同时具有两种身份:它相对于上层函数是 callee,相对于自己调用的下一层函数又是 caller。理解这一点,就能理解嵌套调用和递归。
一、从栈的两个操作重新出发
回放 A 07:32
栈是内存中的一个区域,运行时用 %rsp 保存栈顶地址。在这里讨论的 x86-64 程序中,栈向低地址增长。图画在纸上时“上、下”可以任意安排,所以我们最好始终说清楚地址增减:分配新的栈空间,通常使 %rsp 减小;释放空间,使 %rsp 增大。
假设原来的栈顶地址为 ,源寄存器中有一个 8 字节的值 。普通的 pushq 可以用下面的状态变化理解:
这里 表示从地址 开始的 8 字节内存。顺序很重要:先形成新的栈顶,再把数据放到那里。相反,向普通目的寄存器弹出一个值时,popq 先取旧栈顶的数据,再把 %rsp 增加 8。
pushq %rax
# 对普通源寄存器,可以用下面两步帮助理解:
# subq $8, %rsp
# movq %rax, (%rsp)

popq %rax
# 对普通目的寄存器,可以用下面两步帮助理解:
# movq (%rsp), %rax
# addq $8, %rsp
这里比较两种写法的条件码:subq、addq 会修改条件码,pushq、popq 不修改条件码。因此,内存和普通寄存器的结果看起来相同,整个机器状态未必完全相同。若后面紧接条件跳转,就不能随意替换。
如果只是丢弃栈顶的一段数据,可以直接增大 %rsp,并不一定要把每个值 pop 到某个寄存器。这里的“丢弃”指程序不再把这段空间视作有效栈内容,内存里的旧字节并没有因此自动被清零。
二、call 与 ret 怎样配对
回放 A 13:02
我们用两个函数观察控制权的传递:
long mult2(long a, long b) {
    long s = a * b;
    return s;
}

void multstore(long x, long y, long *dest) {
    long t = mult2(x, y);
    *dest = t;
}
multstore 必须先调用 mult2,等乘法完成,再把结果存入 dest 指向的内存。如果我们只是跳到 mult2,怎么知道它结束后该回到哪儿?答案是:调用发生时,把调用指令后面那一条指令的地址保存到栈上。
课件的反汇编示例为:
0000000000400540 <multstore>:
  400540: pushq %rbx
  400541: movq  %rdx, %rbx
  400544: callq 400550 <mult2>
  400549: movq  %rax, (%rbx)
  40054c: popq  %rbx
  40054d: retq

0000000000400550 <mult2>:
  400550: movq  %rdi, %rax
  400553: imulq %rsi, %rax
  400557: retq
执行地址 0x400544 处的调用时,返回地址是 0x400549,并不是 0x400544,也不是 0x400550。在这个具体例子中,callq 指令占 5 字节,所以后一条指令位于 0x400549;不能由此推断所有指令长度都是 5。
设调用前栈顶为 ,下一条指令地址为 ,被调用函数入口为 。我们可以把普通近调用的主要效果写成:
%rip 是指令指针。函数返回时,retq 从当前栈顶读出返回地址,恢复控制流:
这也说明 retq 为什么没有在指令里写一个固定的返回目标:同一个函数可能被许多地方调用,每次调用的返回地址都可能不同。返回目标由这一次调用保存在栈上的数据决定。
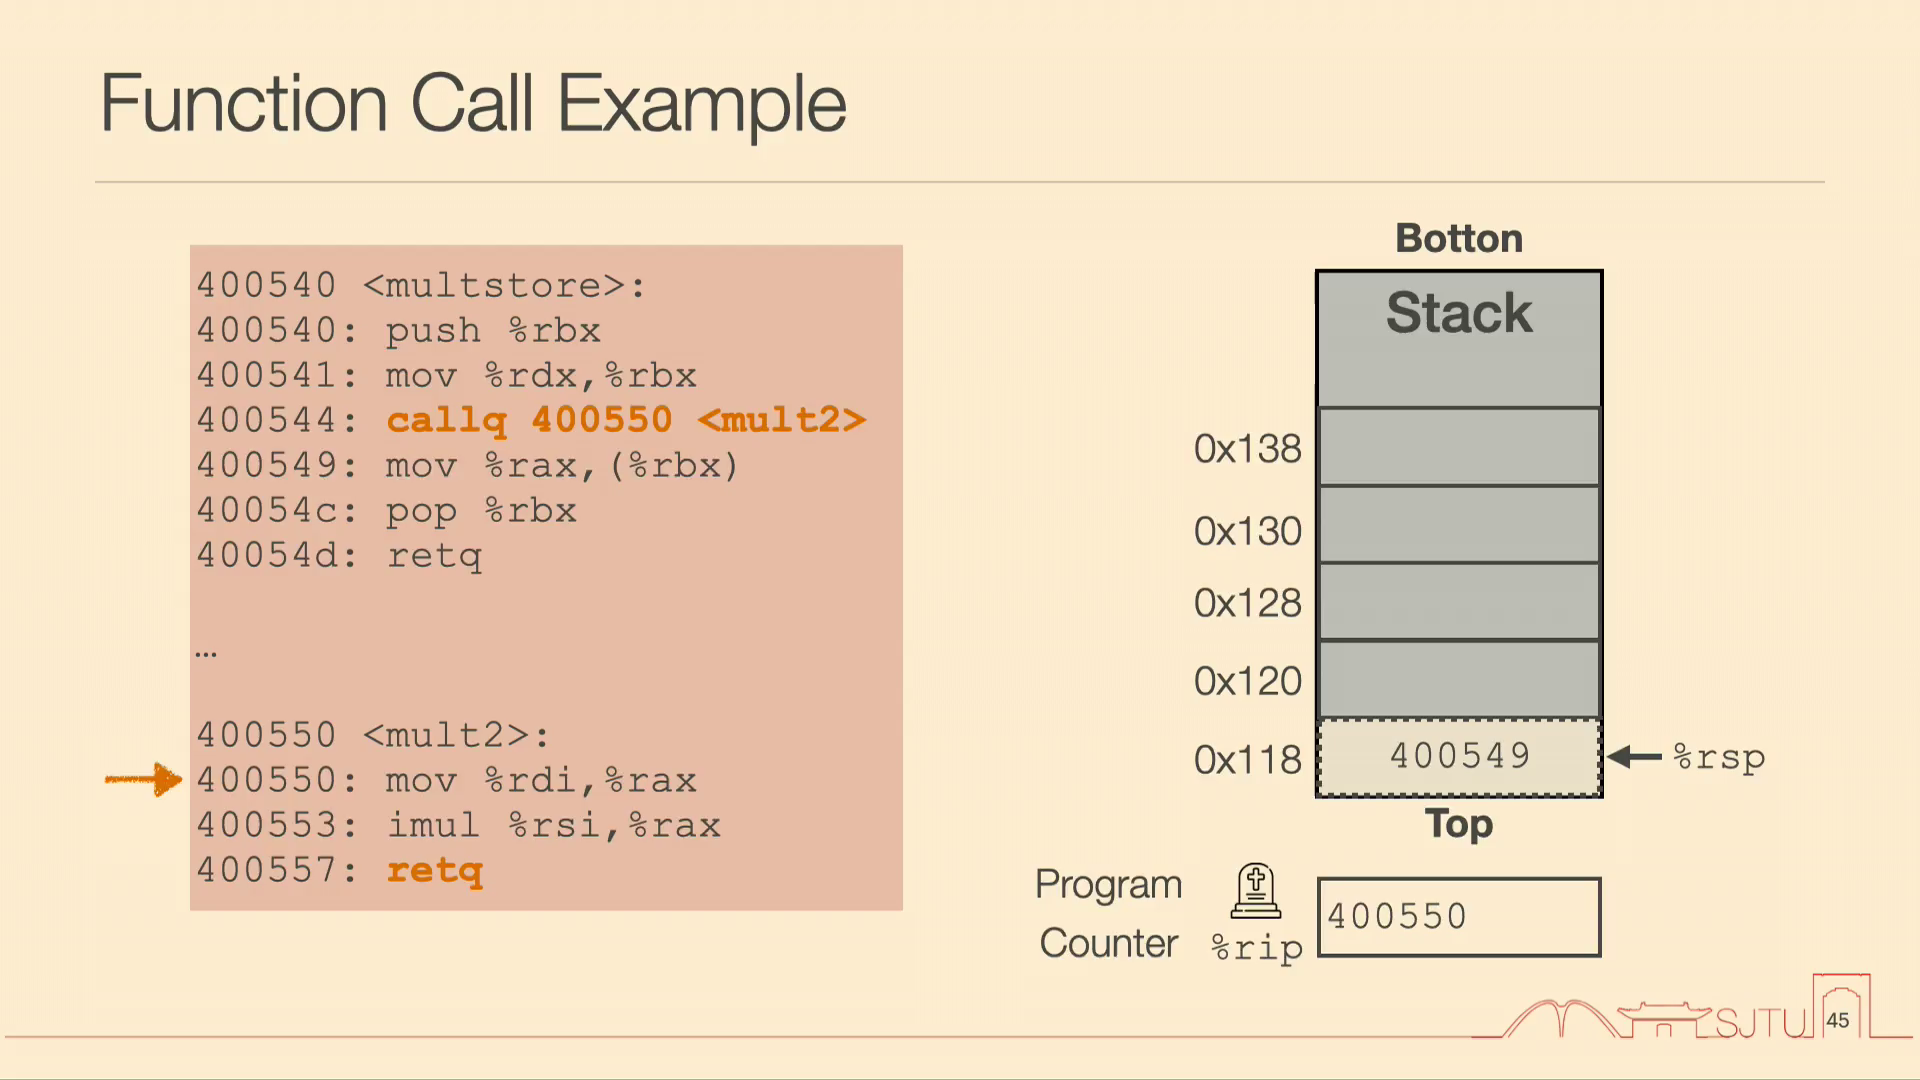
嵌套调用之所以自然,是因为返回地址按后进先出的次序保存。若 A 调用 B,B 又调用 C,那么先返回的必定是 C 到 B,然后才是 B 到 A。每一层要让自己的栈空间在返回前恢复到正确位置,否则 retq 就会把普通数据误当作地址。
三、参数和返回值如何跨越函数边界
回放 A 20:05
现在控制权可以传递了,我们还得让数据跟过去。能用的基本存储位置有寄存器和内存:寄存器访问快,但数量有限;栈可以容纳更多数据,但需要内存操作。于是调用约定规定了双方都认识的位置。
这里使用的是课程例子中的 System V AMD64 调用约定,且先限于普通整数和指针参数。前六个这一类参数按下面的顺序进入寄存器:
| 参数次序 | 位置 |
|---|---|
| 1 | %rdi |
| 2 | %rsi |
| 3 | %rdx |
| 4 | %rcx |
| 5 | %r8 |
| 6 | %r9 |
| 后续参数 | 按约定放入栈上的参数区域 |
普通 long 返回值放在 %rax。这些位置是双方遵守的接口,不能因为某个寄存器空闲,就由调用者临时决定换一个位置。若双方没有共同规则,被调用者即使正确计算,也可能读错输入。
回到 multstore。进入它时,x、y、dest 分别在 %rdi、%rsi、%rdx。调用 mult2 时,前两个参数仍然就是我们要传递的 a、b,所以不用搬动。mult2 用:
movq  %rdi, %rax
imulq %rsi, %rax
retq
把乘积留在返回寄存器 %rax,再由 multstore 执行 movq %rax, (%rbx) 写回内存。retq 负责返回控制权,而 %rax 中的值是双方依照约定解释的结果;不是 retq 额外把某个 C 变量自动复制回去。
我们还没解释为什么 dest 要从 %rdx 搬到 %rbx,也没解释为什么要先保存旧 %rbx。先把这个问题留下,等寄存器保存规则建立起来,就能把这段程序完整读懂。
四、局部变量不一定有独立内存位置
回放 A 24:13
函数内部的局部变量也可以放在寄存器中,或者放在栈上。源程序中写了一个名字,并不意味着机器一定为它分配了一个同名的内存格子。编译器会根据值的使用关系复用寄存器,甚至完全消除某些中间变量。
看下面这个 incr:
long incr(long *p, long val) {
    long x = *p;
    long y = x + val;
    *p = y;
    return x;
}
它有两个不同的结果:内存被更新成新值,函数返回旧值。我们逐行看汇编:
incr:
    movq (%rdi), %rax
    addq %rax, %rsi
    movq %rsi, (%rdi)
    retq
进入函数时,%rdi=p,%rsi=val。第一条从 p 指向的内存读取旧值,保存在 %rax,它同时就是 x 和最终返回值。第二条把旧值加到 %rsi,此时 %rsi 从参数 val 的存放处变成了局部结果 y 的存放处。第三条把新值写回 *p,并没有改动 %rax。
例如初始 *p=15213、val=3000:
| 时刻 | %rax |
%rsi |
*p |
|---|---|---|---|
| 进入函数 | 尚未确定 | 3000 | 15213 |
| 读出旧值后 | 15213 | 3000 | 15213 |
| 完成加法后 | 15213 | 18213 | 15213 |
| 写回并返回 | 15213 | 18213 | 18213 |
所以返回值是 15213。这一点后面会用来检查另一页课件的数值。我们不需要为 x、y 各分配 8 字节栈空间,整段函数只用寄存器便能完成。
五、需要地址的局部数据怎样放到栈上
回放 A 27:24
如果局部变量的地址要传给另一个函数,我们通常就需要给它一个可寻址的内存位置。课件用下面的程序说明:
long call_add(void) {
    long v1 = 15213;
    long v2 = 3000;
    long v3 = add(&v1, &v2);
    return v2 + v3;
}
在这个教学例子中,add 读取两个指针所指向的数并返回其和,且不改变 v2,于是返回的 v3=18213,整个函数返回 21213。
课件为了突出两个局部变量的布局,给出如下代码:
call_add:
    subq $16, %rsp
    movq $15213, (%rsp)
    movq $3000, 8(%rsp)
    leaq (%rsp), %rdi
    leaq 8(%rsp), %rsi
    call add
    addq 8(%rsp), %rax
    addq $16, %rsp
    retq
设进入函数时 %rsp=s,其指向本函数的返回地址。subq $16, %rsp 后新的栈顶是 。两个变量的布局为:
| 地址 | 内容 |
|---|---|
| 本函数的返回地址 | |
v2=3000 |
|
v1=15213,也是此时 %rsp 指向的位置 |
这里 $16 是十进制立即数 16,即两个 8 字节位置;立即数前面的 $ 不表示十六进制,十六进制形式要写成 $0x10。课堂对图中格子数的核对,最终应按 16 字节理解。
接下来两条 leaq 传的是地址:%rdi=s-16,%rsi=s-8。leaq 计算括号里的地址表达式,不会从那个地址读取数据。如果改成 movq (%rsp), %rdi,传过去的就成了数值 15213,而不是 &v1。
call add 会在更低的地址再压入返回地址。add 返回后,栈指针恢复到调用它之前的位置,因此 8(%rsp) 仍能用来读取 v2。addq 8(%rsp), %rax 得到 3000+18213=21213。
为什么结束前一定要恢复栈指针
在最后的 retq 前,当前 %rsp 仍指着局部变量 v1。如果不执行 addq $16, %rsp,retq 就会把 15213 当成下一条指令的地址,而不会自动跳过我们的局部变量。
因此,恢复栈空间不是为了“清空变量”,而是为了让栈顶重新指向该返回时应该读出的地址。分配多少、释放多少,要连同 push、pop 和嵌套调用一起计算。
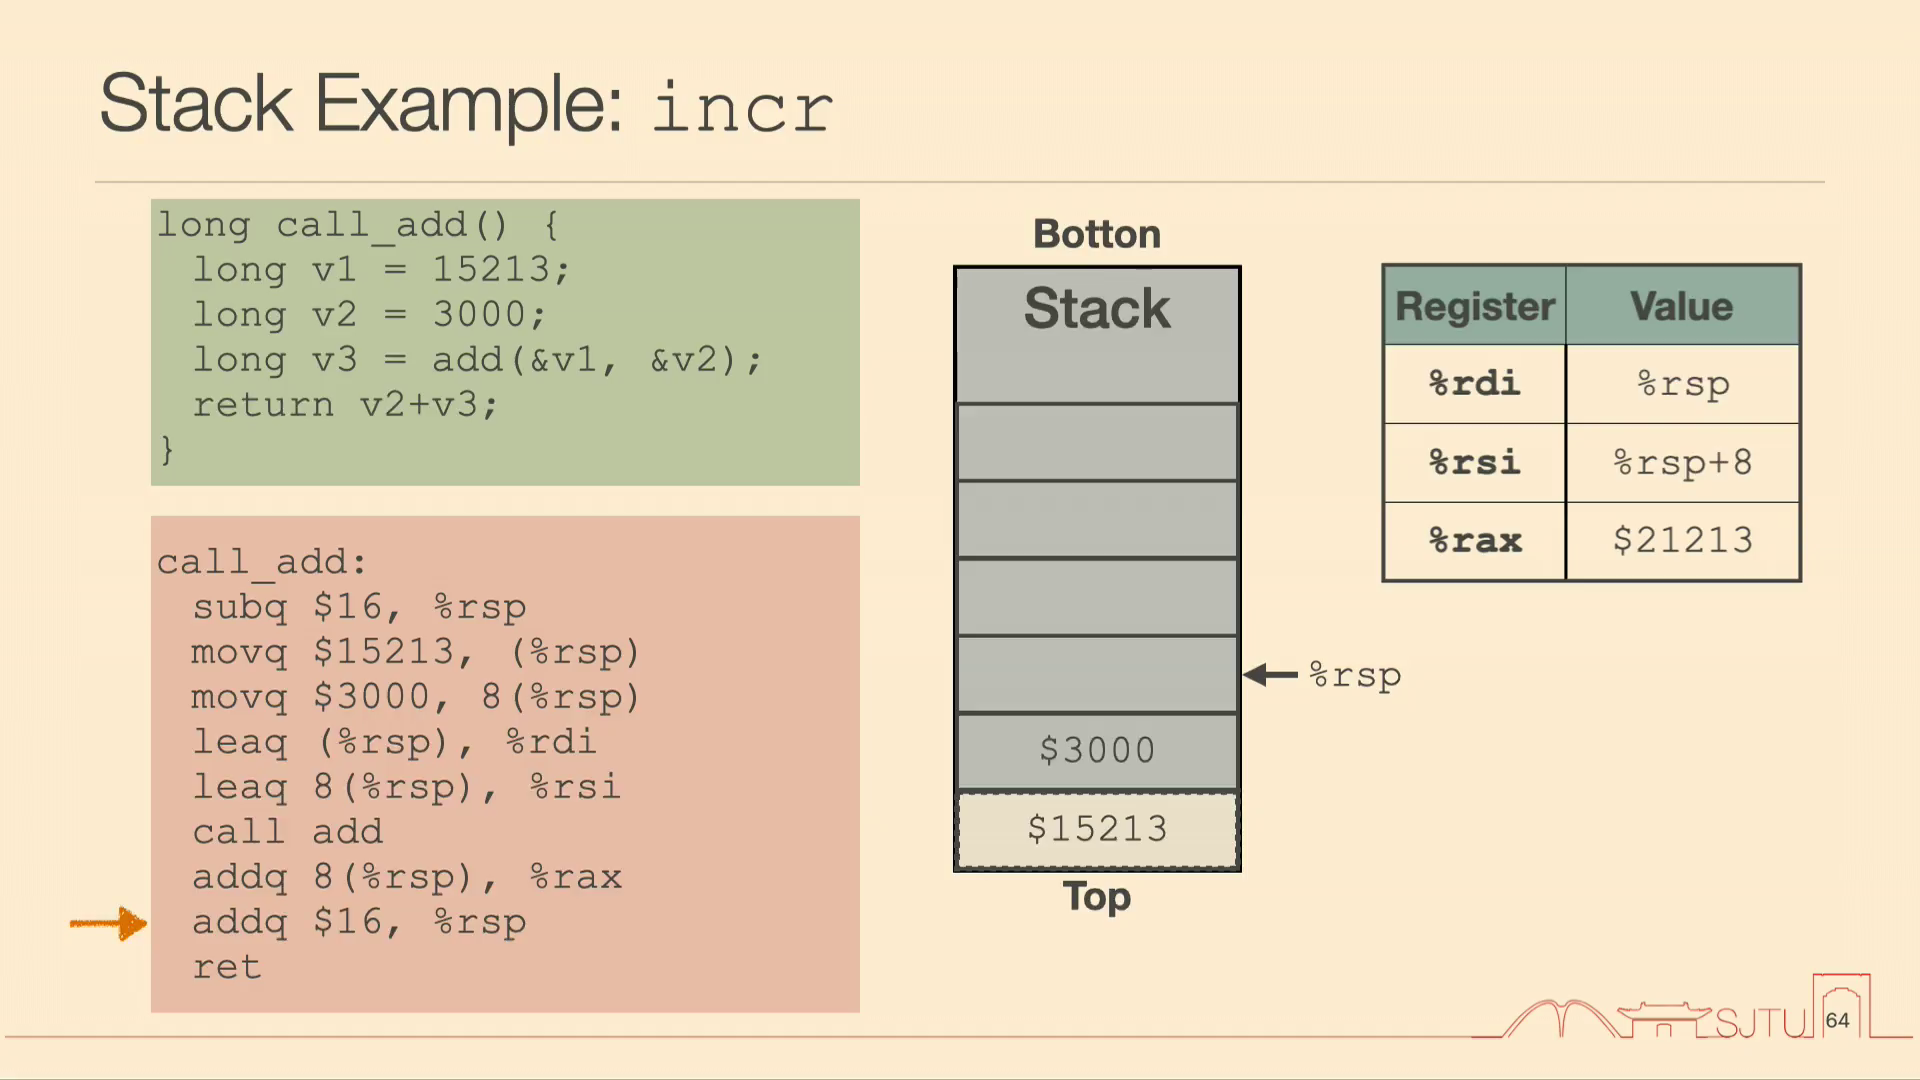
另一个课堂问题是:能不能把 addq 8(%rsp), %rax 换成通过 %rsi 间接取数?如果这个具体的 add 保持 %rsi 不变,确实可以;但稍后我们会看到 %rsi 是 caller-saved。仅依靠调用约定,调用以后不能假定它仍然指向 v2。使用恢复后的 %rsp 加固定偏移量更容易建立可靠的依据。
编者补全:上面原样保留的是课件用于解释布局的
subq $16版本。按 System V AMD64 的普通 16 字节栈对齐要求,函数入口通常满足%rsp≡8 (mod 16),而执行嵌套call前须满足%rsp≡0 (mod 16)。本例没有先push一个寄存器,因此若把它写成遵守该对齐要求的完整代码,可以把开头和末尾的 16 改成 24,两个局部变量仍放在(%rsp)和8(%rsp),其余 8 字节作填充。
六、寄存器为什么需要保存约定
回放 A 38:10
现在假设一个函数把后面还要用的值放在 %rdi,接着调用另一个函数。被调用者也需要寄存器,完全可能覆盖 %rdi。程序如果没有规则,就无法知道调用回来以后哪些值还有效。
我们建立两类责任。
调用者保存(caller-saved):如果调用者在调用结束后还需要某个旧值,它负责在调用前把这个值妥善保留下来。被调用者可以自由改动这一类寄存器,不承诺恢复旧值。保存到栈上是一种做法,也可以把值转移到已经妥善保护的其他位置。
被调用者保存(callee-saved):被调用者若要改动这一类寄存器,就负责保留进入时的值,并在返回前恢复。调用者可以依赖这个承诺,继续使用原值。
这两种规则都不是说“每次都无条件保存所有寄存器”。caller-saved 中只有跨调用仍需使用的值才需要保护;callee-saved 中只有函数实际改动的寄存器才需要相应保存和恢复。
课程采用的普通通用寄存器分工如下:
| 类别 | 寄存器 | 我们怎样理解 |
|---|---|---|
| caller-saved | %rax、%rdi、%rsi、%rdx、%rcx、%r8、%r9、%r10、%r11 |
跨调用不能依赖旧值仍在 |
| callee-saved | %rbx、%rbp、%r12、%r13、%r14、%r15 |
被调用函数用完须恢复入口值 |
| 栈指针 | %rsp |
必须正确平衡栈空间,使返回能继续执行 |
%rax 自然会被返回结果覆盖,所以属于调用者不能保留旧值的那一类。%rsp 在函数体内会变化,但函数必须在约定的时刻恢复正确的栈位置。讨论“恢复”时还要区分 retq 弹出返回地址前、后两个时刻。
回头看 multstore:dest 进入时在 caller-saved 的 %rdx,但调用 mult2 之后仍要用这个指针。于是 multstore 把它放到 callee-saved 的 %rbx。同时,multstore 自己也有责任把更上层调用者的旧 %rbx 用 pushq 保存,结束时用 popq 恢复。一个函数同时承担两种身份,这里就体现出来了。
七、把所有规则放进 call_incr2
回放 A 45:48
我们最后用一个完整例子把控制、参数、局部变量和保存责任串起来:
long call_incr2(long x) {
    long v1 = 15213;
    long v2 = incr(&v1, 3000);
    return x + v2;
}
对应汇编为:
call_incr2:
    pushq %rbx
    subq  $16, %rsp
    movq  %rdi, %rbx
    movq  $15213, 8(%rsp)
    movl  $3000, %esi
    leaq  8(%rsp), %rdi
    call  incr
    addq  %rbx, %rax
    addq  $16, %rsp
    popq  %rbx
    retq
调用前:同时保护上层的 rbx 和自己的 x
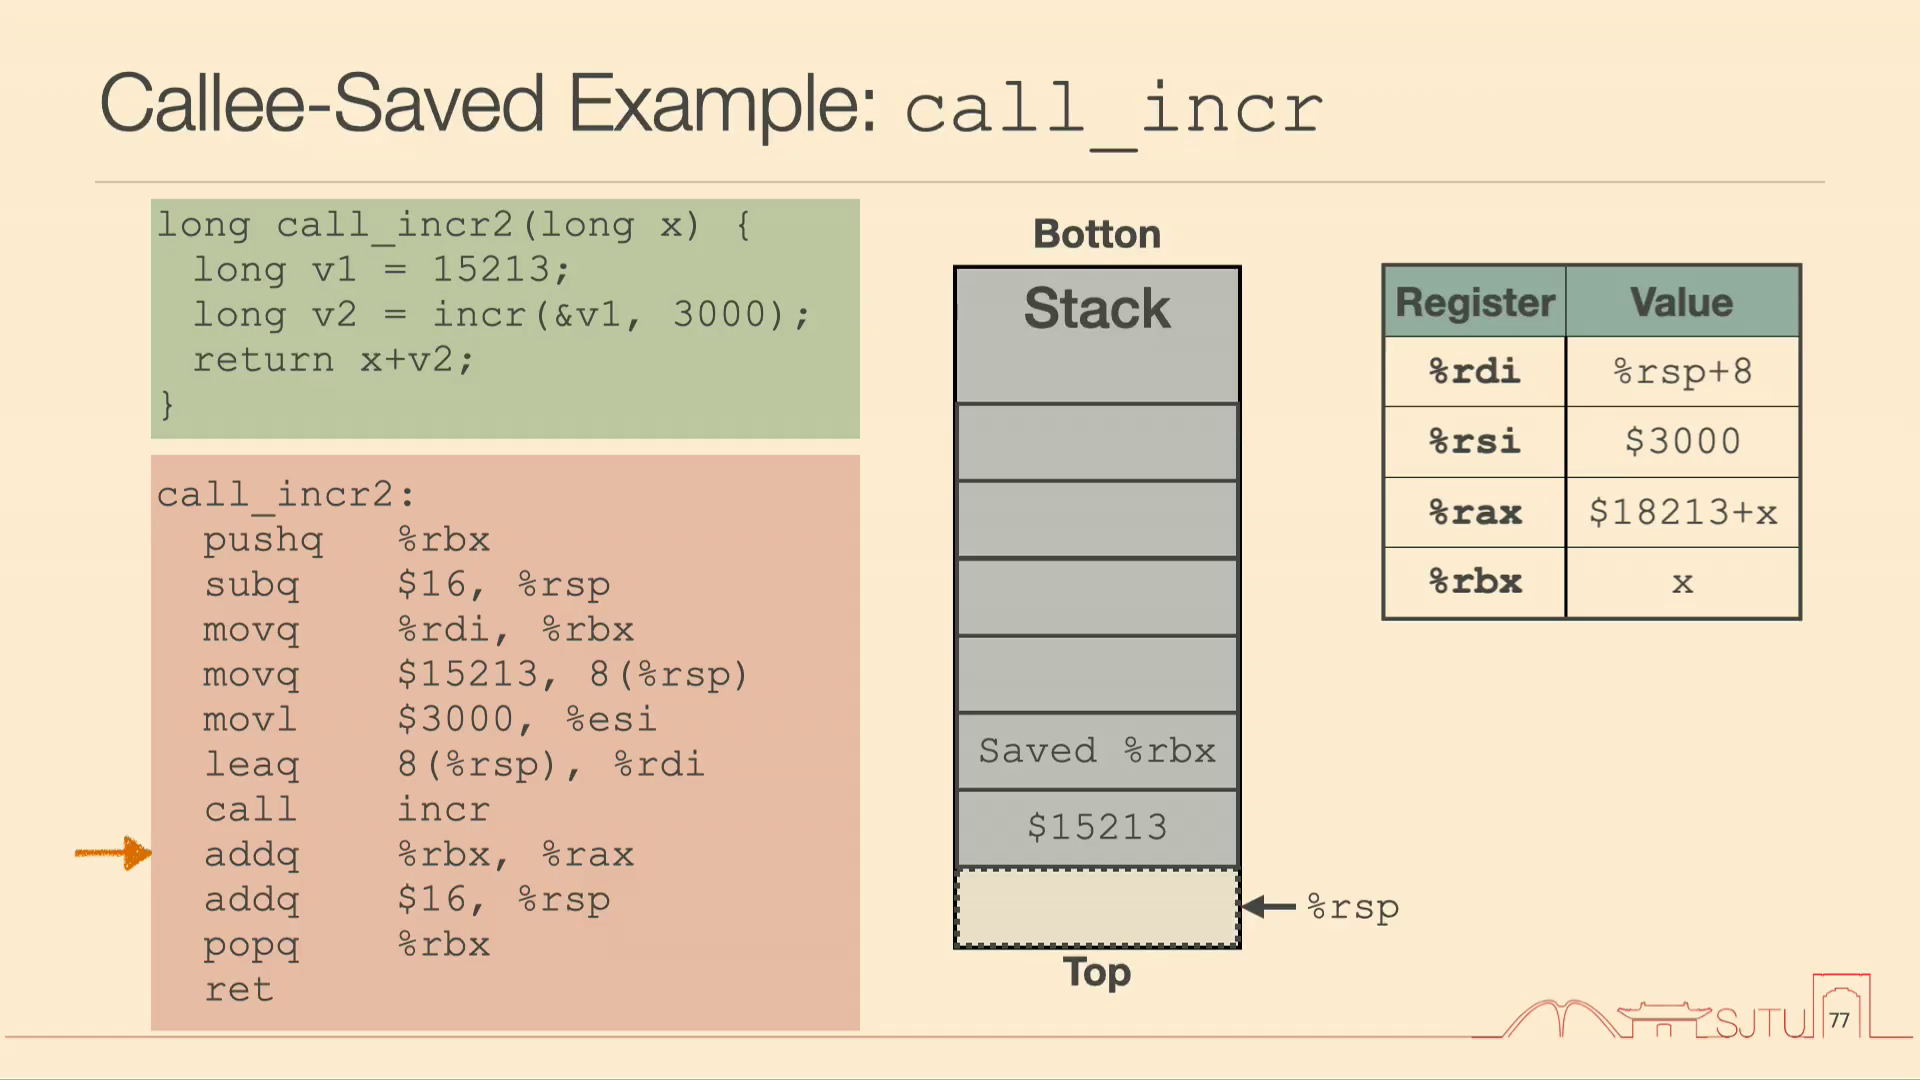
设进入函数时 %rsp=s,%rdi=x,旧 %rbx=b。第一条把 存到 ,并令 %rsp=s-8。再分配 16 字节后,%rsp=s-24。
此时执行 movq %rdi, %rbx,把本函数的输入 x 保存到 %rbx。为什么不能直接留在 %rdi?一是马上要用 %rdi 传递 &v1,二是被调用的 incr 没有保存 %rdi 的责任。
v1 放在 8(%rsp)=s-16;movl $3000, %esi 写入 32 位子寄存器,同时把 %rsi 的高 32 位清零,因此这里得到 64 位数值 3000。leaq 8(%rsp), %rdi 把 v1 的地址传给第一个参数。
在 call incr 前,各位置为:
| 位置 | 内容 |
|---|---|
%rbx |
本函数输入 x |
%rdi |
,即 &v1 |
%rsi |
3000 |
| 返回到上层调用者的地址 | |
上层调用者的旧 %rbx=b |
|
v1=15213 |
|
%rsp=s-24 |
本函数当前栈顶 |
调用后:把内存结果与函数返回值分开
call 会在 处再放入返回到 call_incr2 的地址。incr 执行完以后,这个地址被 retq 取走,回到 call_incr2 时 %rsp=s-24,而 %rbx 仍应为 x。
此时我们必须按 incr 的代码重新计算,而不能只看课件动画里的数字:
纠错:原 PDF 物理页 130(印刷页 76)及回放 A 约49分钟把
%rax误写为 18213。incr的 C 与汇编都返回旧值,因此应为 15213,call_incr2返回x+15213。
返回前:反向撤销栈上的安排
addq %rbx, %rax 得到本函数的返回值。之后 addq $16, %rsp 释放局部空间,令 %rsp=s-8;popq %rbx 取回旧值 ,令 %rsp=s;这时栈顶终于重新指向本函数的返回地址,retq 才能安全完成返回。
按时间排列,关键状态可以压成这张表:
| 时刻 | %rsp |
%rbx |
关键数据 |
|---|---|---|---|
| 函数入口 | %rdi=x |
||
| 保存并分配后 | 存旧 %rbx |
||
| 准备好参数 | &v1 和 3000 已传入寄存器 |
||
进入 incr |
新返回地址在当前栈顶 | ||
从 incr 回来 |
v1=18213,%rax=15213 |
||
恢复后、retq 前 |
%rax=x+15213 |
||
| 完成返回 | 上层继续执行 |
这个例子已经足以分析递归中的保存责任。每一层调用都有自己的一次栈分配,保存的是该次调用需要的值;同一份函数代码可以被多次执行,而各层尚未结束的局部状态要彼此区分。寄存器数量有限,栈承担了跨调用保存这些状态的工作。
八、自己检查一次调用是否正确
我们读一段函数汇编时,会沿着四条线同时追踪:控制权下一步去哪里,参数和返回值放在哪里,局部内存相对哪个时刻的 %rsp 定位,以及跨调用还要使用的寄存器值由谁保护。
比如 retq 的正确性不能只看它这一条;必须往前检查此时 %rsp 是否已经恢复到返回地址。leaq 的正确性也不能只看括号;必须区分我们要传的是地址还是地址里的值。最后,代码的正确结果由指令和源程序语义决定,课件动画中的示例数字也要接受同样的检查。
九、栈帧把调用所需的信息放在一起
回放 B 05:15
我们把前面的几条线合成一张栈帧图。当前 %rsp 标识栈顶,一次调用的帧可以包含保存的寄存器、局部变量,以及交给下一层函数的栈参数。调用前,调用者保护还要继续使用的 caller-saved 值并准备参数;返回前,被调用者恢复自己用过的 callee-saved 值、撤销局部分配,让栈顶重新指向返回地址。这样,控制转移、数据传递和存储管理就成为同一套协作过程。
十、数组的地址和大小怎样计算
回放 B 10:00
声明数组时,我们给出元素类型、数组名和元素个数:
char a[12];
int val[5];
char *p[3];
数组在内存里占据连续空间。若元素大小为 字节、元素数为 ,总大小就是 字节。课堂的 x86-64 数据模型中,char 为 1 字节,int 为 4 字节,指针为 8 字节,上面三个数组分别占 12、20、24 字节。char *p[3] 的每个元素是指针,不能按三个字符计算大小。
设数组起始地址为 ,第 个元素地址为
地址 是数组尾后位置。对 int val[5],val+i 前进 个元素,数值地址增加 字节;val[i] 则在该地址取出一个 int。我们把课上逐项辨认表达式的过程列成表:
| 表达式 | 含义 | 地址或数值 |
|---|---|---|
val |
首元素指针 | |
val+i |
第 个元素的指针 | |
&val[2] |
第三个元素的地址 | |
val[i] |
第 个元素的值 | 从 读取的整数 |
*(val+i) |
与 val[i] 相同 |
从 读取的整数 |
字节序改变的是一个元素内部的字节排列
回放 B 11:42
数组各元素按下标递增排列。另一方面,一个多字节元素内部还要约定各字节的顺序。以四字节整数 0x01234567 为例,假定起始地址是 :
| 地址 | 大端序 big endian | 小端序 little endian |
|---|---|---|
01 |
67 |
|
23 |
45 |
|
45 |
23 |
|
67 |
01 |
大端序把最高有效字节放在最低地址,小端序把最低有效字节放在最低地址。x86 使用小端序。这里重排的单位是 byte,字节内部各 bit 的数值含义保持原样;数组中第 0、1、2 个元素的次序也保持原样。
二维数组按行展开
回放 B 20:27
int A[R][C];
这个数组有 行、每行 个整数,总大小为 字节。C 的行优先布局先放完第 0 行,再放第 1 行,依次继续。设基址为 ,在 A[i][j] 之前有 个元素,因此
从一行进入下一行,地址增加的是整行的大小 。这个式子把前面有效地址计算中的“下标乘元素大小”推广到了二维。
十一、结构体字段与对齐
回放 B 21:51
结构体把不同类型的成员放进同一个对象。课上用下面的记录说明字段访问:
struct rec {
    int a[4];
    double i;
    struct rec *next;
};
a 占 16 字节,i 从偏移 16 开始占 8 字节,next 从偏移 24 开始占 8 字节,整个记录共 32 字节。若 r1 是结构体对象,r1.i 访问字段;若 r 是指向该结构体的指针,(*r).i 与 r->i 表达相同访问。指针成员 next 保存下一个对象的地址,由此可以连接多个记录。
字段有了类型和先后次序,仍要决定每个字段从哪里开始。我们先比较紧密排列和对齐排列。一个 char 后接一个 int,若直接紧挨着放,int 就会从偏移 1 开始;按课上使用的对齐规则,int 的起点取 4 的倍数,于是它从偏移 4 开始,中间留下 3 字节填充。
对常用标量类型,我们把起始地址安排为其对齐单位的整数倍:char 对齐到 1 字节,int 对齐到 4 字节,double 与指针对齐到 8 字节。编译器在字段之间插入 padding,安排好字段偏移。对齐也让硬件访存和编译器优化更方便。
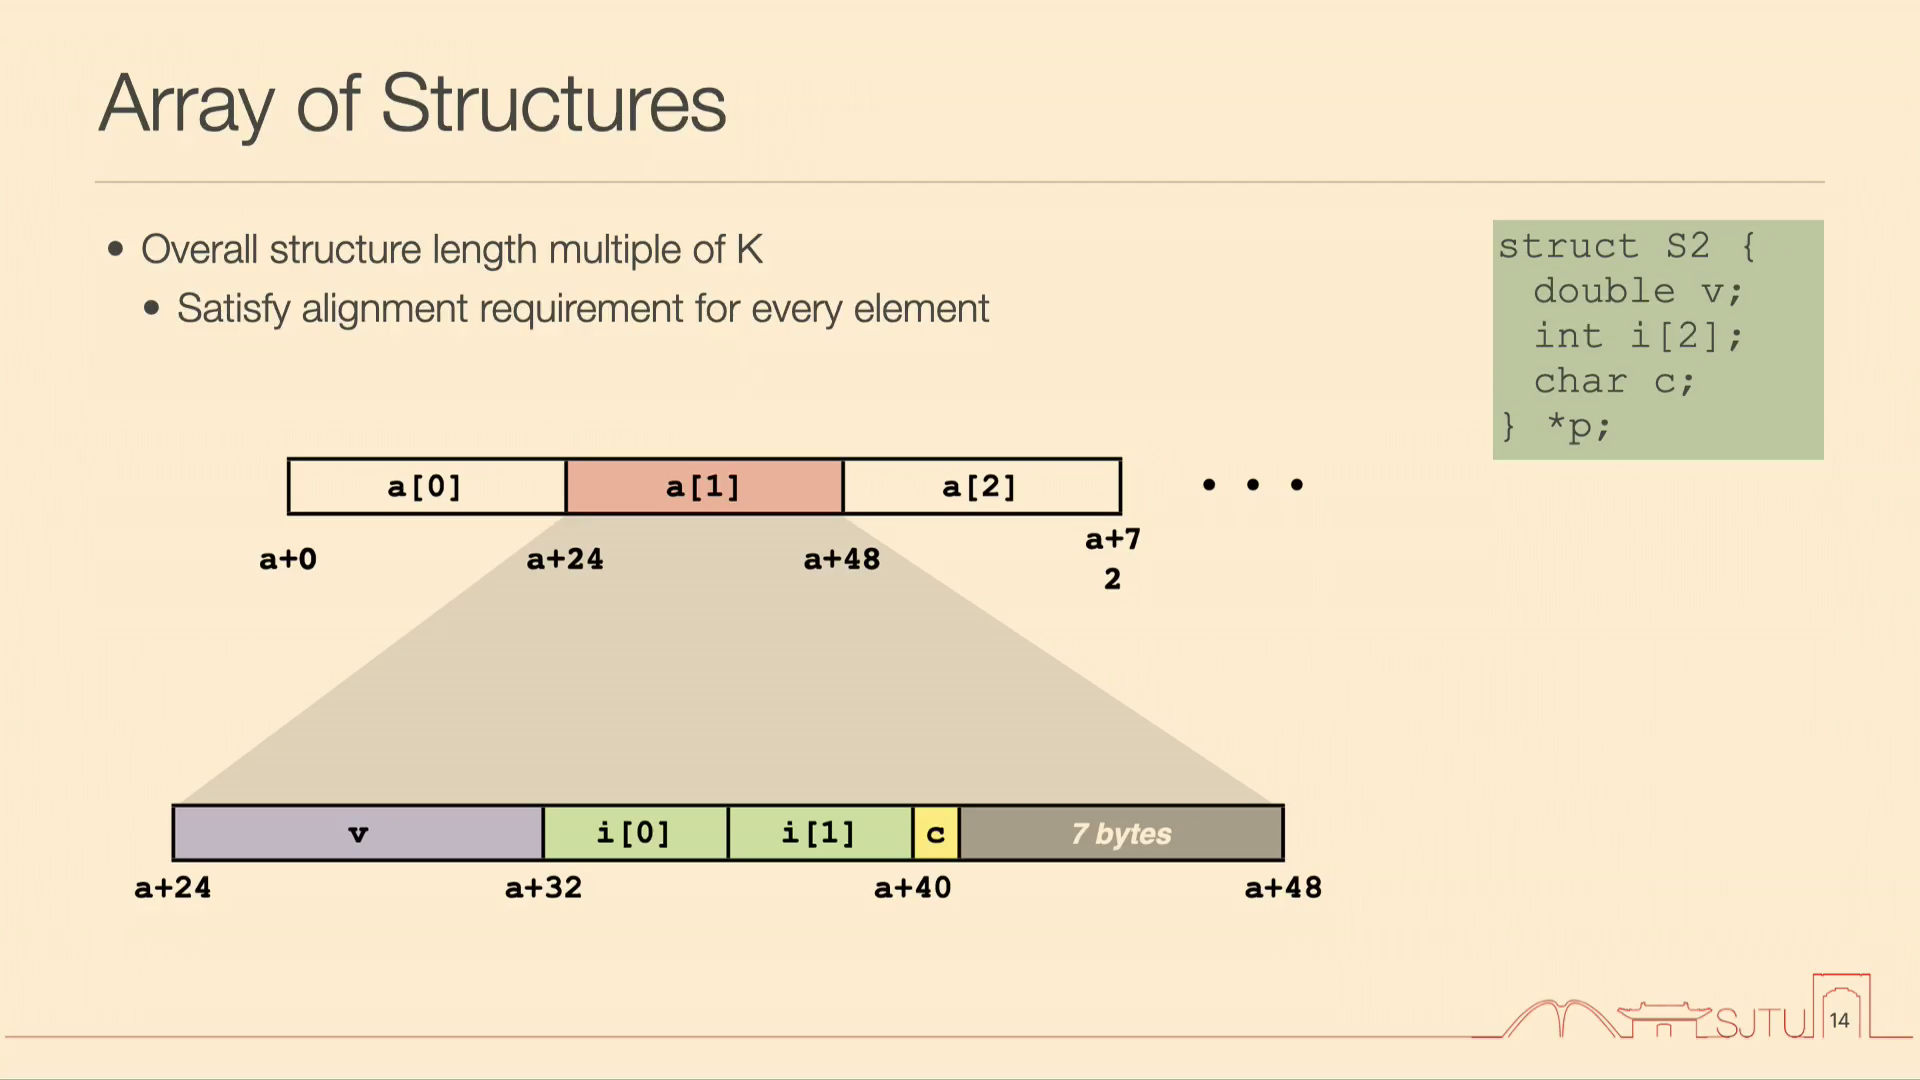
课堂先给出结构体 S1,再把字段重排为 S2:
struct S1 {
    char c;
    int i[2];
    double v;
} *p;

struct S2 {
    double v;
    int i[2];
    char c;
} *p;
S1 中 c 位于偏移 0,偏移 1—3 填充,i 位于 4—11,偏移 12—15 再填充,v 位于 16—23,总大小为 24 字节。S2 把 7 个填充字节集中到了末尾。两者都含一个 double、两个 int 和一个 char,有效数据共 字节。把较大的字段放在前面,可以形成以下布局:
| 偏移范围 | 内容 |
|---|---|
| 0—7 | double |
| 8—11 | 第一个 int |
| 12—15 | 第二个 int |
| 16 | char |
| 17—23 | 尾部填充 |
为什么还要补尾部 7 字节?结构体的对齐单位由其中要求最强的成员决定,这里是 8。结构体大小也取 8 的倍数,因而从 17 向上补到 24。若把这种结构体放入数组,相邻元素间距就是 24 字节,下一元素中的 double 仍从 8 的倍数地址开始。字段重排改变的是我们声明的布局,数组步长必须按填充后的整个结构体大小计算。
十二、返回局部地址与返回结构体值
回放 B 31:09
我们再问一个函数接口问题:被调用函数在栈上建立一个局部结构体,能否把这个局部对象的地址返回给调用者?课件先给出下面的写法:
struct S {
    int a, b;
};

struct S *foo(int c, int d) {
    struct S retval;
    retval.a = c;
    retval.b = d;
    return &retval;
}

void bar(void) {
    struct S *test = foo(3, 4);
    printf("%d, %d\n", test->a, test->b);
}
课堂纠正:原页附注称会得到
3, 4,授课者明确指出这段程序不正确;retval返回后已经结束生存期,不能继续通过其地址读取成员。
函数一旦返回,该局部对象的生存期便结束;这段栈空间可以被后续调用复用,调用者通过原指针访问它就失去了有效对象。这是返回局部变量地址的问题。
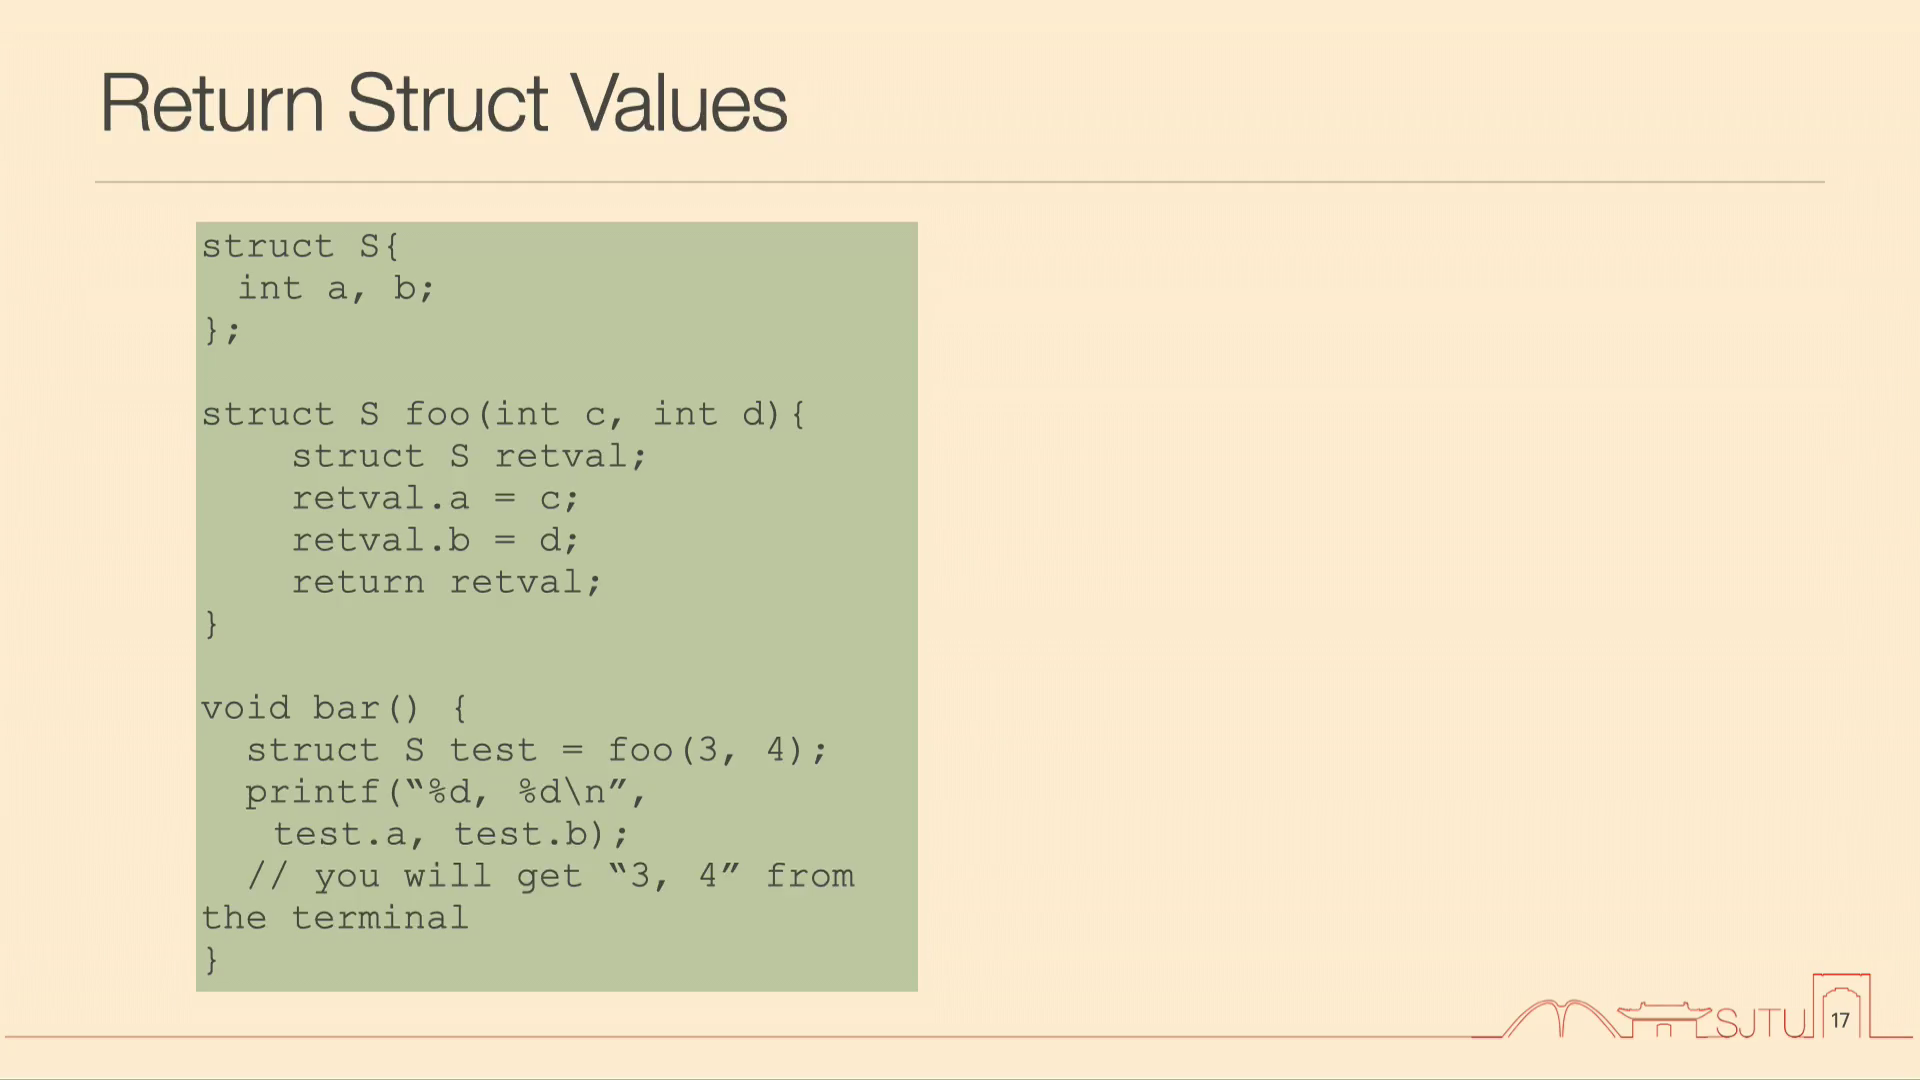
如果改成按值返回整个结构体,情况就不同了:
struct S foo(int c, int d) {
    struct S retval;
    retval.a = c;
    retval.b = d;
    return retval;
}

void bar(void) {
    struct S test = foo(3, 4);
    printf("%d, %d\n", test.a, test.b);
}
返回的是结构体值,调用者得到可继续使用的结果,打印 3, 4。实现可以按调用约定利用寄存器传递较小的结果,或用内存传递较大的结果。前面只放一个普通整数到 %rax 的例子由此得到扩展:结构体返回需要考虑返回类型及布局。
十三、程序使用的内存区域
回放 B 35:34
我们在程序员看到的地址空间中辨认几类区域:
| 区域 | 主要内容与用途 |
|---|---|
| 代码及只读区域 | 可执行指令、只读常量等 |
| 数据区域 | 全局变量、静态变量等 |
| 堆 heap | malloc、calloc、new 等动态分配所使用的存储 |
| 内存映射区域 | 共享库以及示例中的大块动态分配等映射 |
| 运行时栈 | 活跃调用的返回地址、局部变量、保存值等 |
课堂用下面的程序,把各对象与区域逐项对应:
char big_array[1L << 24];   /* 16 MB */
char huge_array[1L << 31];  /* 2 GB */

int global = 0;
int useless() { return 0; }

int main()
{
    void *phuge1, *psmall2, *phuge3, *psmall4;
    int local = 0;
    phuge1 = malloc(1L << 28);   /* 256 MB */
    psmall2 = malloc(1L << 8);   /* 256 B */
    phuge3 = malloc(1L << 32);   /* 4 GB */
    psmall4 = malloc(1L << 8);   /* 256 B */
    /* Some print statements ... */
}
全局数组与 global 有静态存储位置,useless 的指令在代码区域,local 与指针变量是本次调用的局部数据。小块分配示例位于堆,大块分配示例位于映射区域,函数指令位于代码区域,调用中的局部数据位于栈。字符串常量也有对应的静态存储位置。
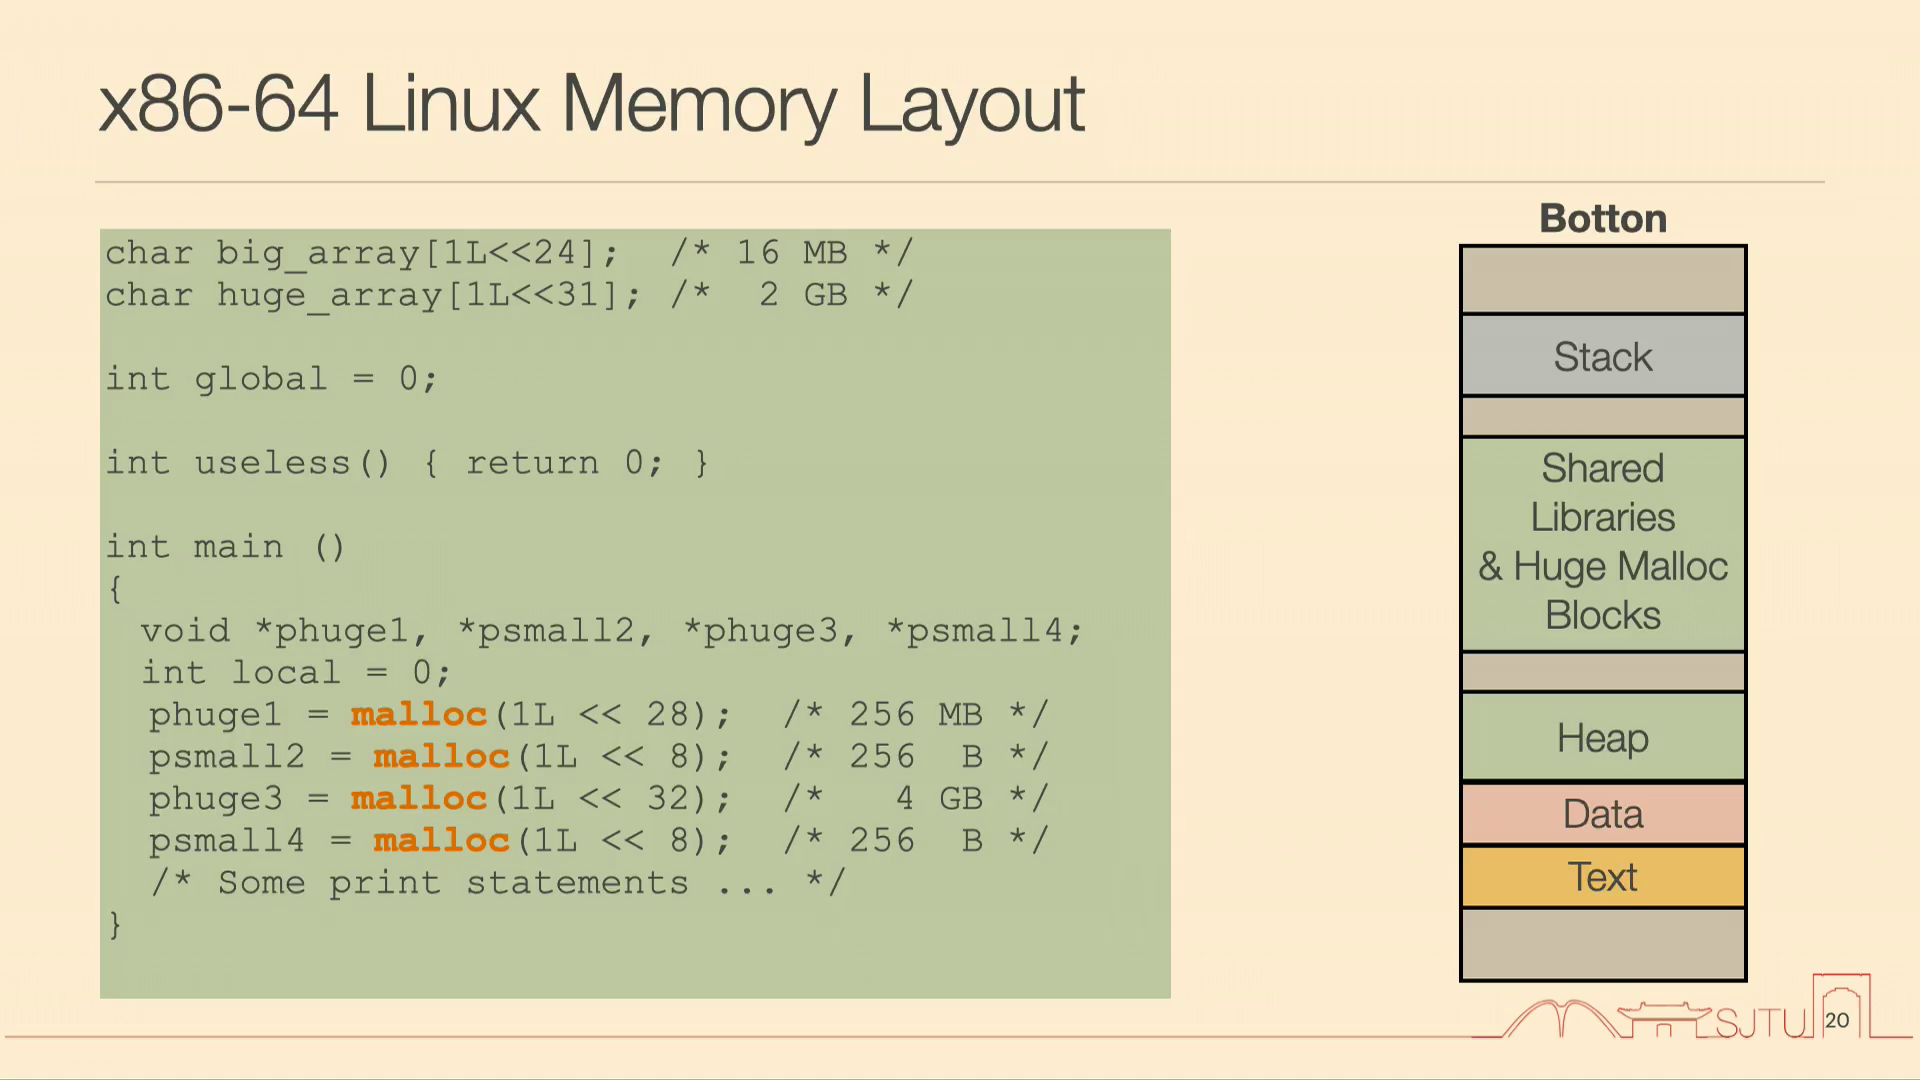
栈空间有限。课堂以约 8 MB 的栈大小说明这一点:递归很深,每层又保留局部数据时,栈帧不断累积,可能耗尽栈空间并触发 segmentation fault(段错误)。这里要同时看递归深度与每帧所需字节数。粗略估计时,若每层额外占 字节, 层就需要约 字节,再加上原先已经使用的空间。
十四、越界写怎样破坏相邻数据
回放 B 40:03
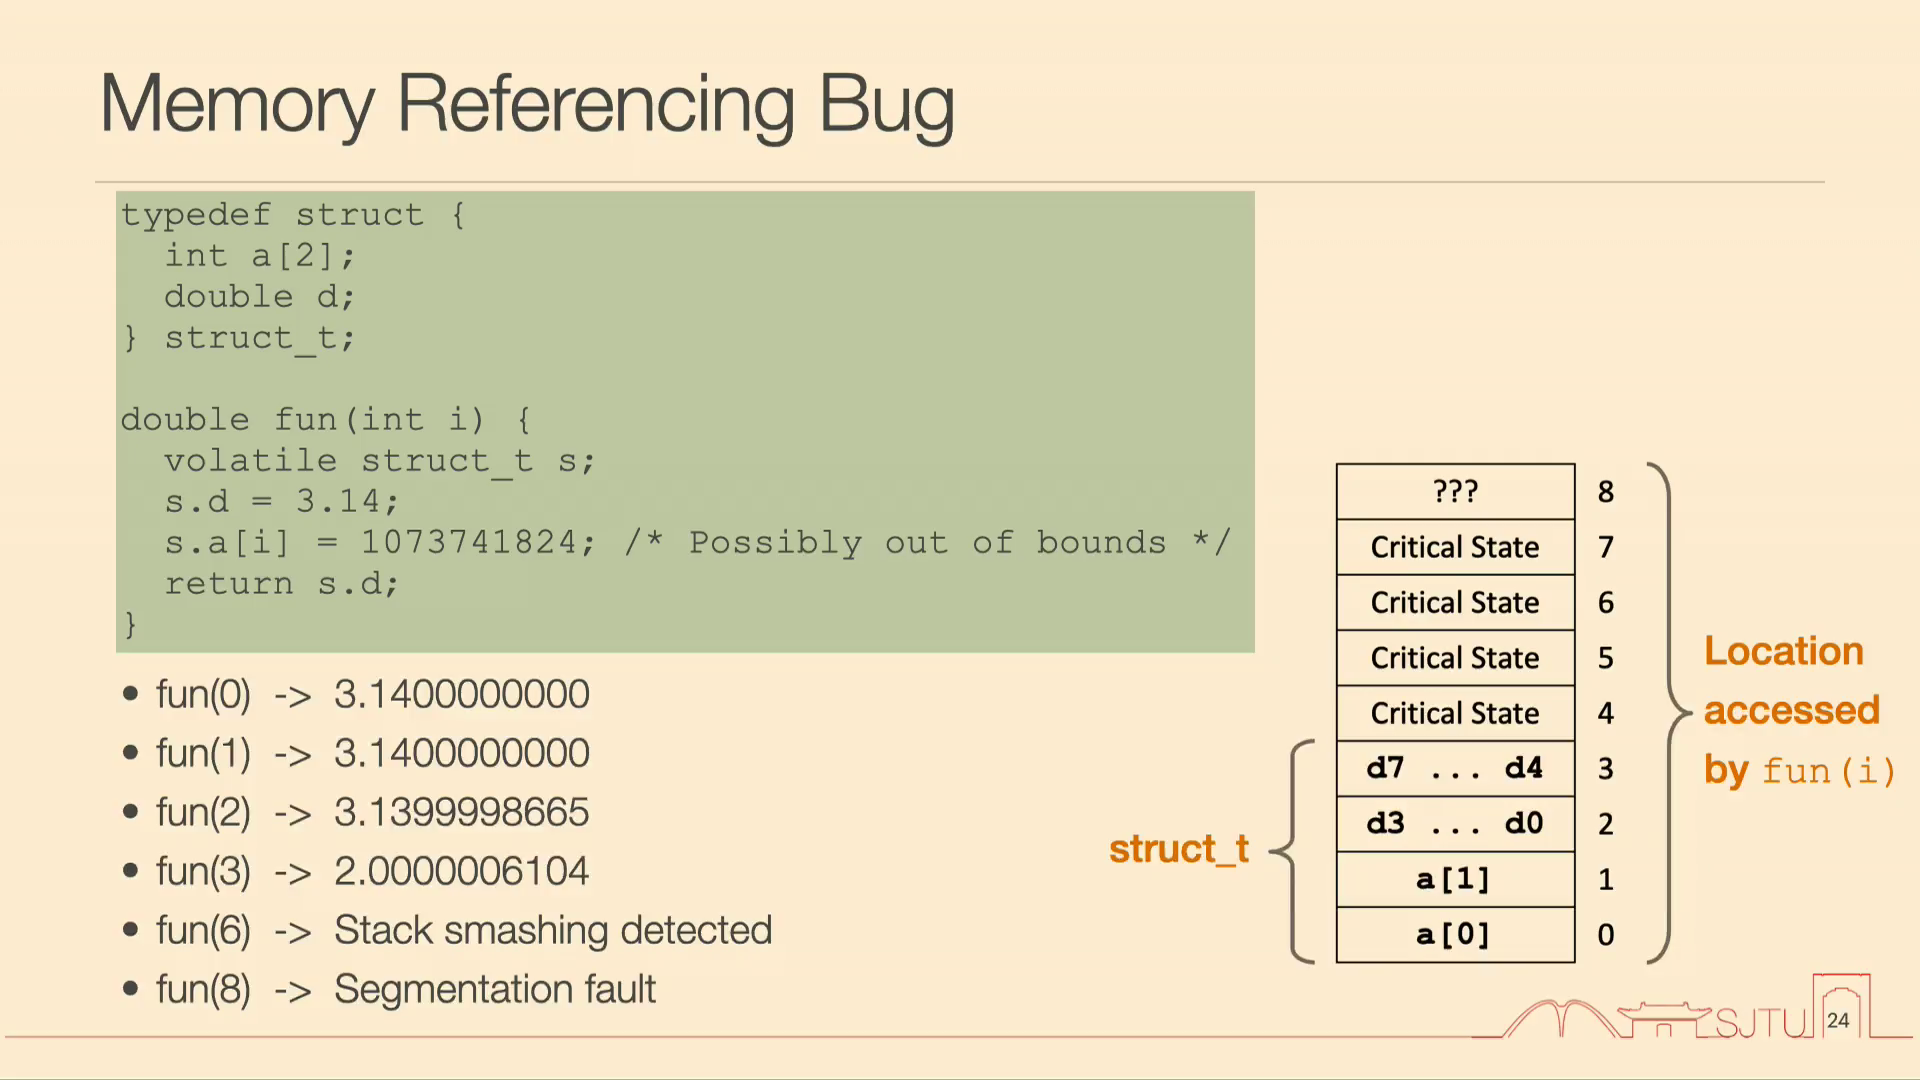
我们最后把“地址可以计算”与“地址是否属于该对象”联系起来。课堂给出下面的实际代码。局部结构体前面是两个 int 的数组 a,后面是 double d。函数先设置 d,再按参数 i 写入 a[i],最后返回 d:
typedef struct {
    int a[2];
    double d;
} struct_t;

double fun(int i) {
    volatile struct_t s;
    s.d = 3.14;
    s.a[i] = 1073741824;  /* Possibly out of bounds */
    return s.d;
}
原页列出的运行示例为:
fun(0) -> 3.1400000000
fun(1) -> 3.1400000000
fun(2) -> 3.1399998665
fun(3) -> 2.0000006104
fun(6) -> Stack smashing detected
fun(8) -> Segmentation fault
i=0 或 i=1 时,写入位于数组的两个元素之内。继续增加 i,计算出的地址就越过数组边界。以图中 int 占 4 字节、double 紧接在偏移 8 的布局计算:
| 写入 | 相对结构体起点的字节偏移 | 图示中影响的位置 |
|---|---|---|
a[0] |
0—3 | 第一个整数 |
a[1] |
4—7 | 第二个整数 |
a[2] |
8—11 | 与 d 的部分字节重叠 |
a[3] |
12—15 | 与 d 的其余字节重叠 |
| 更大的下标 | 16 以后 | 继续越过局部对象,可能破坏栈上保存的信息 |
这就是 buffer overflow:写入超出了为缓冲区分配的范围。我们原来只想改一个数组元素,却可能改写其他数据,甚至改写控制流需要的关键状态。C 的这类越界访问属于未定义行为;表中解释的是课堂所示布局下相邻字节被覆盖的机制。
无界字符串输入为什么危险
回放 B 45:57
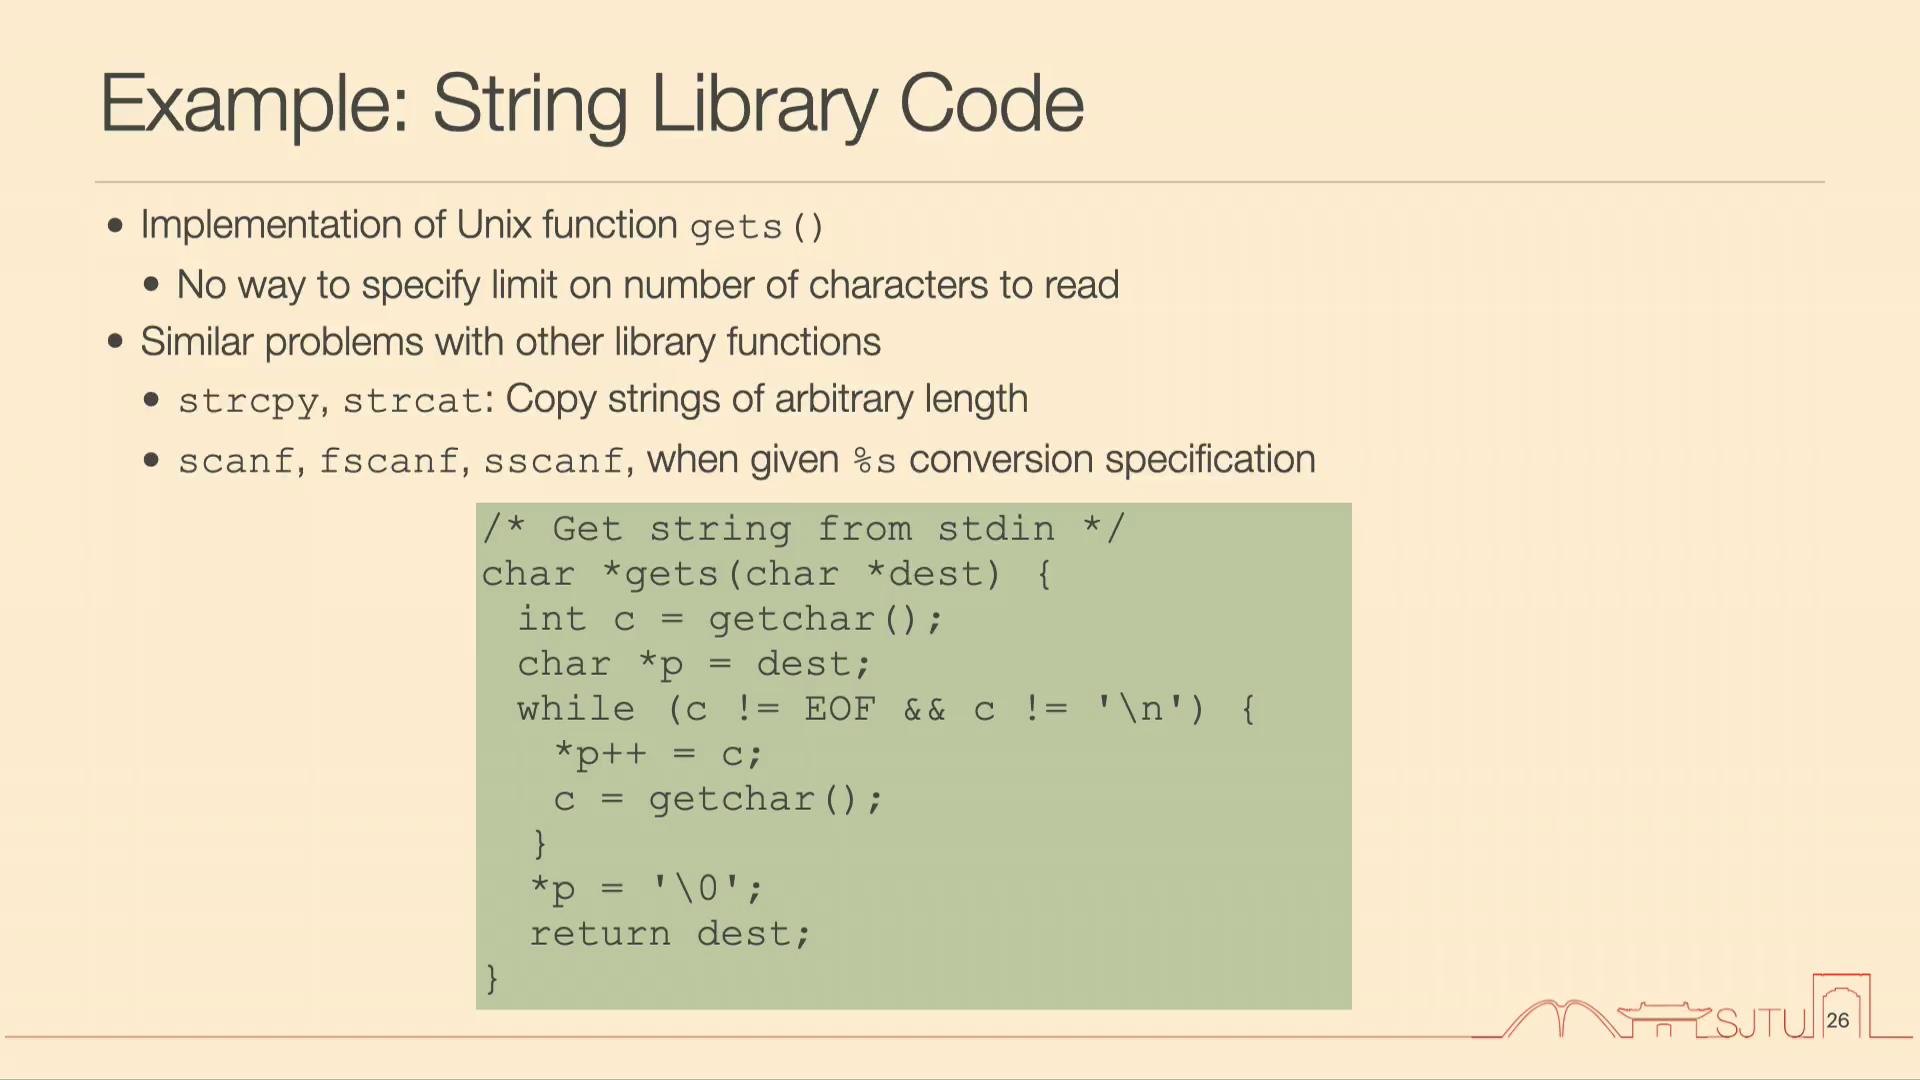
课堂接着展示 gets 的教学实现:
/* Get string from stdin */
char *gets(char *dest) {
    int c = getchar();
    char *p = dest;
    while (c != EOF && c != '\n') {
        *p++ = c;
        c = getchar();
    }
    *p = '\0';
    return dest;
}
它进行无界的字符串读取:给定目的指针 dest,用工作指针 p 从头写入;每次调用 getchar() 取得字符,只要还没有遇到 EOF 或换行,就写到 *p 并让 p 加一。循环结束后再写字符串终止字符 \0,最后返回目的指针。
我们检查这个过程缺少什么。它知道写到哪里开始,也知道何时遇到输入结束,却没有接收目的缓冲区容量,更没有在写入前比较已经写了多少字符。用户输入的这一行足够长,p 就会越过目的数组,末尾的 \0 也同样需要一个合法位置。只按换行或 EOF 停止,无法保证写入始终位于缓冲区内。
课件同时列举 strcpy、strcat 以及未指定宽度的 %s 输入,它们也需要检查目的空间容量。因此,检查数组访问时既要追踪起始地址,也要追踪合法长度和每一次写入的位置。课堂在此转向 echo 的示例,但完整实现与后续分析留到下一课。
来源与补全:本篇据 2026-10-13 A(179756)与本轮恢复的 B(180060)完整转写整理。A 核对 Lecture 9 PDF 61—137 页,B 核对实际回放画面;平台尚无 B 对应独立课件。地址方程、数组索引式和跟踪表补齐计算步骤;
incr返回值及栈对齐问题就地说明,栈对齐参考 System V AMD64 ABI 原始规范。