Lecture 1
Abstract
同一套命题公式可以具有经典与直觉主义两种语义。我们从自然演绎和 Kripke 反模型比较它们,再通过简单类型 λ 演算理解命题即类型、证明即程序的 Curry–Howard 对应。
我们先问一个看似很简单的问题:下面三个公式,是不是都应当为真?
p→p,p∨¬p,(¬p→p)→p.
如果我们已经学过经典命题逻辑,很容易立即回答“是”。不过,我们今天想让我们重新检查这个回答。“真”究竟指什么?我们给出逻辑公式的语法之后,是否只能给它一种意义?我们会保留同一套公式,给出两种合理的语义。第一式在两种语义下都有效,后两式却会把它们区分开来。然后我们再从程序的角度看这些公式:哪些公式能够成为一个程序的类型,为什么自然演绎规则恰好像构造程序的规则?
1. 语法并不替我们决定语义
片段 A,07:30–20:30
我们先固定语法。令 p,q,r,… 为命题变量,公式由下列方式递归构成:
φ::=p∣⊥∣(φ∧φ)∣(φ∨φ)∣(φ→φ).
这里 ⊥ 表示假。否定不需要作为另一个原始联结词加入,我们约定
¬φ:=φ→⊥.
这只是语法上的缩写。特别是,读到 ¬p 时,我们可以把它展开为 p→⊥。经典逻辑与直觉主义逻辑在今天的讨论中使用完全相同的语法;区别要到解释这些符号和规定证明规则时才出现。
1.1 经典语义:一个赋值中的真
经典赋值是一个函数
v:Var⟶{0,1}.
它为每个命题变量指定真假,再按公式的结构扩展到复合公式。写 v⊨Cφ,表示 φ 在赋值 v 下为真。定义是:
v⊨Cpv⊨C⊥v⊨C(φ∧ψ)v⊨C(φ∨ψ)v⊨C(φ→ψ)⟺v(p)=1,对所有 v,⟺v⊨Cφ 且 v⊨Cψ,⟺v⊨Cφ 或 v⊨Cψ,⟺v⊨Cφ 或 v⊨Cψ.
最后一行就是经典蕴含的真值条件:只有当前件为真、后件为假时,蕴含才为假。
因此 p→p 显然总为真。p∨¬p 也总为真:p 为真时左边成立,p 为假时右边成立。对第三式,我们分两种情况:
- 若 p 为真,外层蕴含的后件为真,整个公式为真。
- 若 p 为假,则 ¬p 为真,于是 ¬p→p 为假。外层蕴含的前件为假,整个公式仍为真。
所以它们都是经典有效式。这里第三式的括号和蕴含方向必须写对;课堂在讨论这一式时当场改正了最初写下的公式。我们后面考察的始终是 (¬p→p)→p。
1.2 “满足”“后承”“有效”共用一个符号
片段 B,04:35–09:30;对前半课记号的澄清
我们常把 ⊨ 用在几种相关、但不同的判断里。这个记号的重载很容易造成混淆,所以我们把层次写清楚。
第一层是一个赋值下的满足关系 v⊨Cφ,它按上面的递归定义计算。令 Γ 是一组公式,我们记
v⊨CΓ⟺对每个 γ∈Γ, v⊨Cγ.
第二层是语义后承:
Γ⊨Cφ⟺对每个赋值 v,v⊨CΓ⟹v⊨Cφ.
这说的是:凡是使全部假设为真的赋值,也使结论为真。第三层是不带假设的有效性:
⊨Cφ⟺∅⊨Cφ⟺对每个 v, v⊨Cφ.
空假设集中的每个公式都成立,这个条件自动满足。因而有效性正好是语义后承的空假设特例。直觉主义也会使用类似记号,但它要量化的是 Kripke 模型及其中的世界,而不是单一的经典赋值。为免把两套解释混在一起,我们用下标 C 和 I 区分它们。
2. 自然演绎:怎样构造证明,怎样使用证明
片段 A,20:30–34:30
除了问一个公式在语义上是否为真,我们还可以问:能不能把它证明出来?我们写
Γ⊢Iφ,
表示在假设集 Γ 下,可以用直觉主义自然演绎证明 φ。⊨ 是关于模型的判断,⊢ 是关于形式证明的判断;不能仅因为符号形似就把两者当成同一个定义。
自然演绎的规则有一个很有用的组织方式。对每个联结词,我们问两件事:怎样证明一个以它为最外层联结词的公式?已经有了这样的公式,又能怎样使用它?前者给出引入规则,后者给出消去规则。
2.1 假设与矛盾
假设本身可以使用:
Γ⊢Iφφ∈Γ(Assumption).
如果我们已经得到假,就可以得到任意结论:
Γ⊢IφΓ⊢I⊥(⊥E).
这叫爆炸律。不要把它误读成“无条件地得到任意公式”:它的前提是我们已经在同一组假设下证明了 ⊥。系统没有一个允许无中生有地证明 ⊥ 的引入规则。
2.2 合取:两份证据与两个投影
为了证明 φ∧ψ,我们需要分别证明两个分量:
Γ⊢Iφ∧ψΓ⊢IφΓ⊢Iψ(∧I).
反过来,得到一个合取之后,可以取出任意一边:
Γ⊢IφΓ⊢Iφ∧ψ(∧E1),Γ⊢IψΓ⊢Iφ∧ψ(∧E2).
引入规则解释了怎样创造合取,消去规则解释了怎样使用合取。我们一会儿会看到,这正是构造一对值、再取出第一或第二个分量的程序操作。
2.3 析取:选择一边与分情况讨论
要证明 φ∨ψ,证明其中一边就足够了:
Γ⊢Iφ∨ψΓ⊢Iφ(∨I1),Γ⊢Iφ∨ψΓ⊢Iψ(∨I2).
但假设别人只交给我们 φ∨ψ,我们不能立即取出 φ,也不能立即取出 ψ。我们还不知道给的是哪一边。课堂在这里讨论“如何使用一个析取”的问题,关键回答是分情况:如果从 φ 出发可以得到结论 χ,从 ψ 出发也可以得到同一个结论 χ,那么无论是哪一种情况,我们都能得到 χ。
Γ⊢IχΓ⊢Iφ∨ψΓ∪{φ}⊢IχΓ∪{ψ}⊢Iχ(∨E).
第二、第三个前提中的 φ、ψ 是各自分支中的临时假设。推出最终结论时,这两个临时假设被撤销;最终的假设仍然只有 Γ。两个分支必须得到同一结论,否则不能合成一个确定的结论。
2.4 蕴含:使用函数与撤销假设
已知蕴含,并且已经得到它的前件,我们就能得到后件:
Γ⊢IψΓ⊢Iφ→ψΓ⊢Iφ(→E).
这就是通常的 modus ponens。另一方面,怎样证明蕴含?暂时增加假设 φ,在它的帮助下证明 ψ,然后撤销这个临时假设:
Γ⊢Iφ→ψΓ∪{φ}⊢Iψ(→I).
例如,要证明 p→p,先假设 p,使用假设规则得到 p,最后撤销该假设:
∅⊢Ip→p{p}⊢Ip(→I).
这样我们就给出了今天所用的直觉主义命题自然演绎系统的全部规则。
2.5 经典系统多加了什么?
在这套系统上,对任意公式 φ 加上排中律,就得到今天讨论的经典证明系统:
Γ⊢Cφ∨¬φ(LEM).
这条规则没有前提。经典真值语义使它显得理所当然;但从刚才的引入、消去规则来看,它又不像是单凭构造和使用联结词自然得到的。这正是我们需要另一种语义的原因:我们不能仅凭“暂时不知道怎样证明”就断定不可证明,必须找到真正的反模型,并最终建立证明系统的可靠性。
3. Kripke 语义:证据可以增长,真不能丢失
片段 A,34:30–46:55;片段 B,37:45–44:35 正式化定义
经典模型中只有一个赋值。现在我们允许多个世界,每个世界代表一种信息状态,而且可以从一个世界进入信息更多的世界。“未来”是帮助理解的说法,数学结构不必是一条时间线:从同一个世界出发,可以有互不比较的分支。
一个命题 Kripke 模型写为
M=(W,≤,V).
其中 W 是非空世界集,≤ 是偏序,表示可到达的信息扩展;它满足自反性、传递性和反对称性。尤其不要求任意两个世界都能比较。V 给每个世界指定当时为真的命题变量集合:
V:W⟶P(Var).
模型还必须满足单调性:
w≤u⟹V(w)⊆V(u).
也就是说,一旦变量 p 在某个世界成立,在所有后继世界中它都继续成立。我们可以获得新的真命题,但不能把已经为真的命题变回不真。也可以等价地为每个世界给出一个 0/1 赋值 vw,要求 w≤u 且 vw(p)=1 时 vu(p)=1。
3.1 迫使关系的递归定义
写 w⊩φ,表示世界 w 迫使公式 φ;这就是该世界中有足够依据使公式成立的语义判断。严格地说还依赖模型 M,在固定模型内我们省略它。
w⊩pw⊮⊥w⊩φ∧ψw⊩φ∨ψw⊩φ→ψ⟺p∈V(w),对每个 w,⟺w⊩φ 且 w⊩ψ,⟺w⊩φ 或 w⊩ψ,⟺对每个 u≥w,u⊩φ⟹u⊩ψ.
合取和析取仍在同一个世界内检查。蕴含才是关键变化:不能只检查当前世界,必须检查每个可到达世界,包含当前世界本身,因为 w≤w。
注意 w⊮φ 是我们在模型外说“w 不迫使 φ”,它不是逻辑公式 ¬φ 的迫使判断。否定仍然是缩写,所以
w⊩¬φ⟺w⊩φ→⊥⟺对每个 u≥w, u⊮φ.
最后一步用到了没有世界迫使 ⊥。因此 ¬p 不是“目前还没有 p”;它要求在当前世界及所有可到达世界,p 都不成立。如果 p 现在尚未成立,但在某个未来世界会成立,那么当前世界既不迫使 p,也不迫使 ¬p。
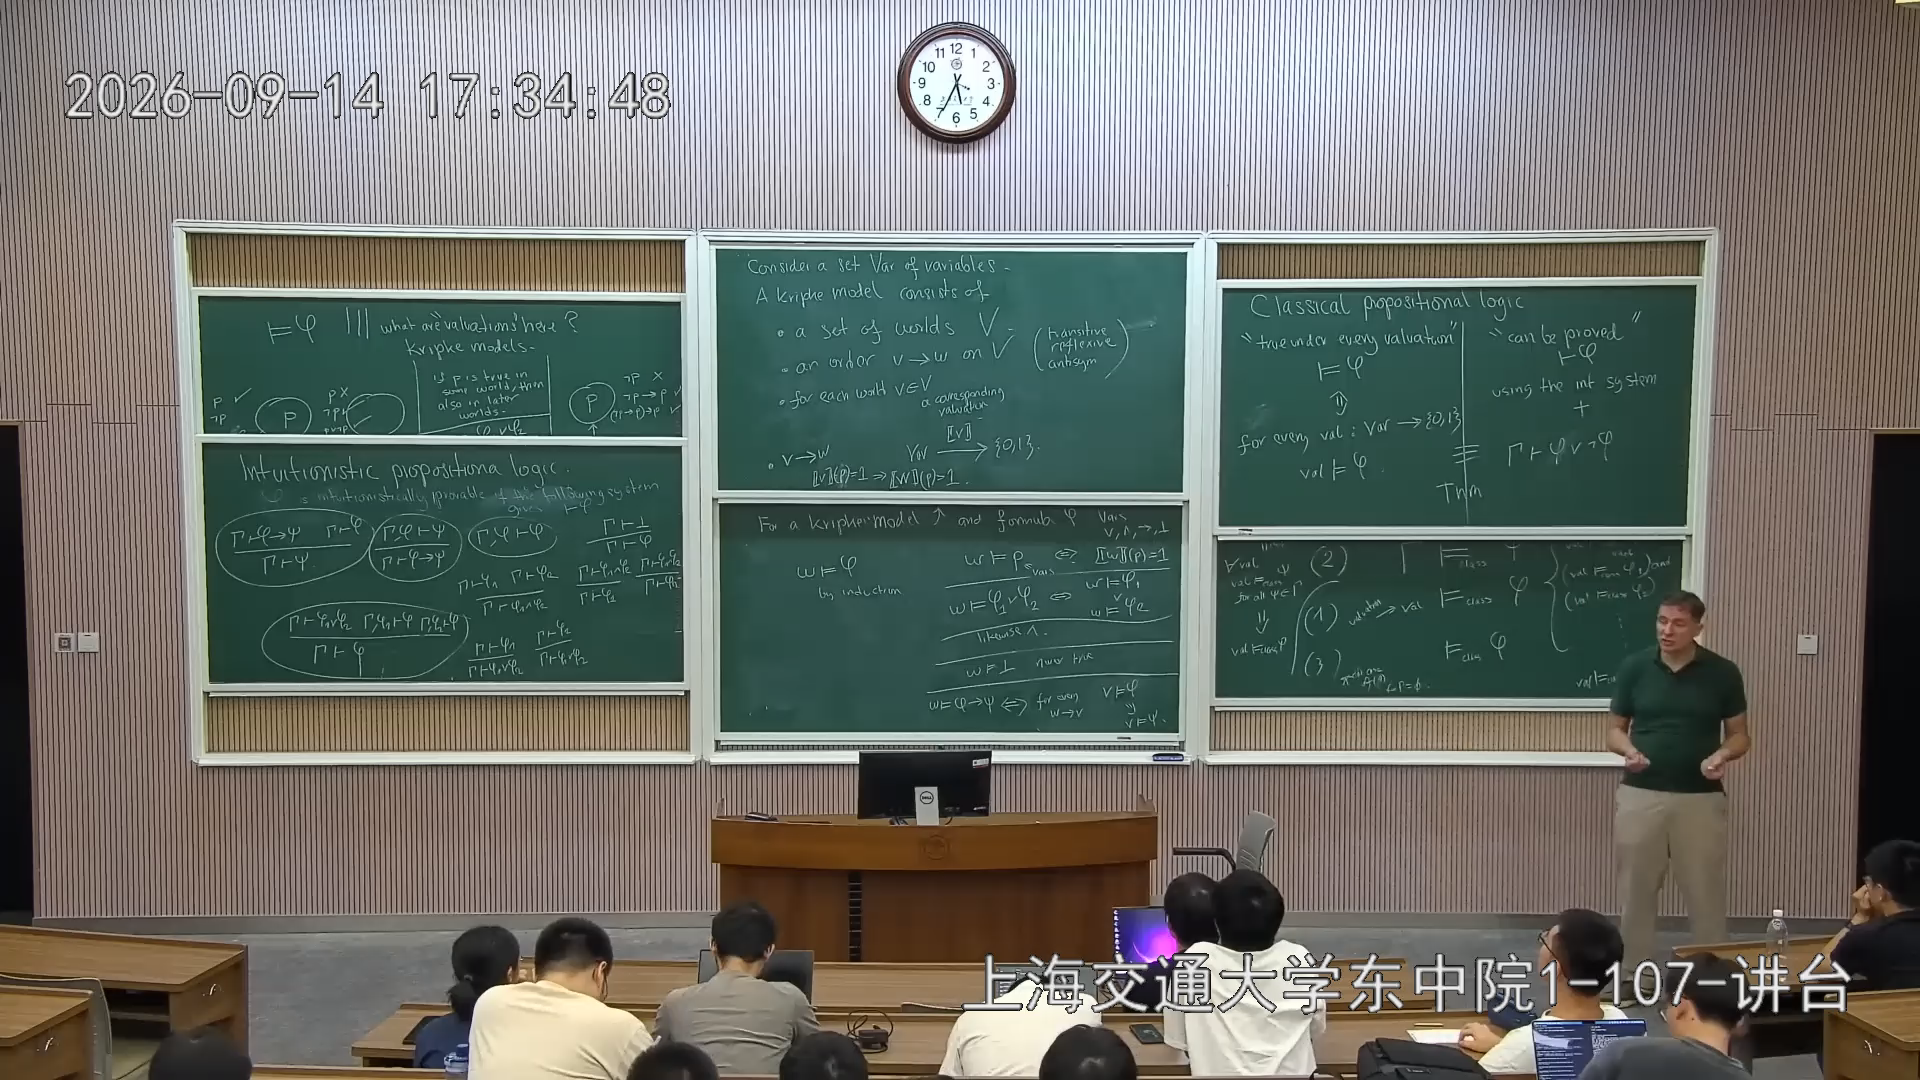 回放 B,44:30。看中间上下两块板书:世界、偏序、单调赋值,以及蕴含检查所有可达世界的定义;具体符号以正文的规范公式为准。
3.2 一个简单的持久性事实
变量的单调性会沿公式结构传递:
w≤u 且 w⊩φ⟹u⊩φ.
我们可以按 φ 的结构检查它。变量情形就是模型的单调性;合取、析取继承分量的持久性;⊥ 情形没有前提成立的可能。对蕴含,若 w⊩α→β,则任意 z≥u≥w 已经在 w 的检查范围内,所以 z⊩α 时必有 z⊩β。因此 u⊩α→β。这个补全解释了为什么“已经得到的证据不会丢失”也适用于复合公式。
直觉主义的语义后承相应定义为
Γ⊨Iφ⟺对每个 Kripke 模型及每个世界 w,(∀γ∈Γ, w⊩γ)⟹w⊩φ.
取空假设集,就得到直觉主义有效性 ⊨Iφ。
4. 两个反例:现在未定,不等于永远为假
片段 A,39:15–45:05
4.1 排中律在分支根部失败
先考虑三个世界 w0,w1,w2,其中
w0≤w1,w0≤w2,
除自反关系外没有其他关系。w1,w2 是两个终端世界,互不比较。令 p 只在 w1 中成立:
V(w0)=∅,V(w1)={p},V(w2)=∅.
这个模型满足单调性:没有已经为真的变量在向上移动时丢失。我们逐个世界检查:
| 世界 |
p |
¬p |
p∨¬p |
| w1 |
迫使 |
不迫使 |
迫使 |
| w2 |
不迫使 |
迫使 |
迫使 |
| w0 |
不迫使 |
不迫使 |
不迫使 |
在 w2,没有当前或未来世界使 p 成立,所以 w2⊩¬p。但在根部 w0,虽然 p 当前不成立,却有后继 w1 使它成立,故 w0⊮¬p。析取要求某个分量在当前世界成立,因此
w0⊮p∨¬p.
这不是经典赋值遗漏了某一种真假情况,而是我们的“真”已经按另一种方式定义:一个模型包含一族受单调性约束的赋值,蕴含与否定还必须考虑可到达世界。
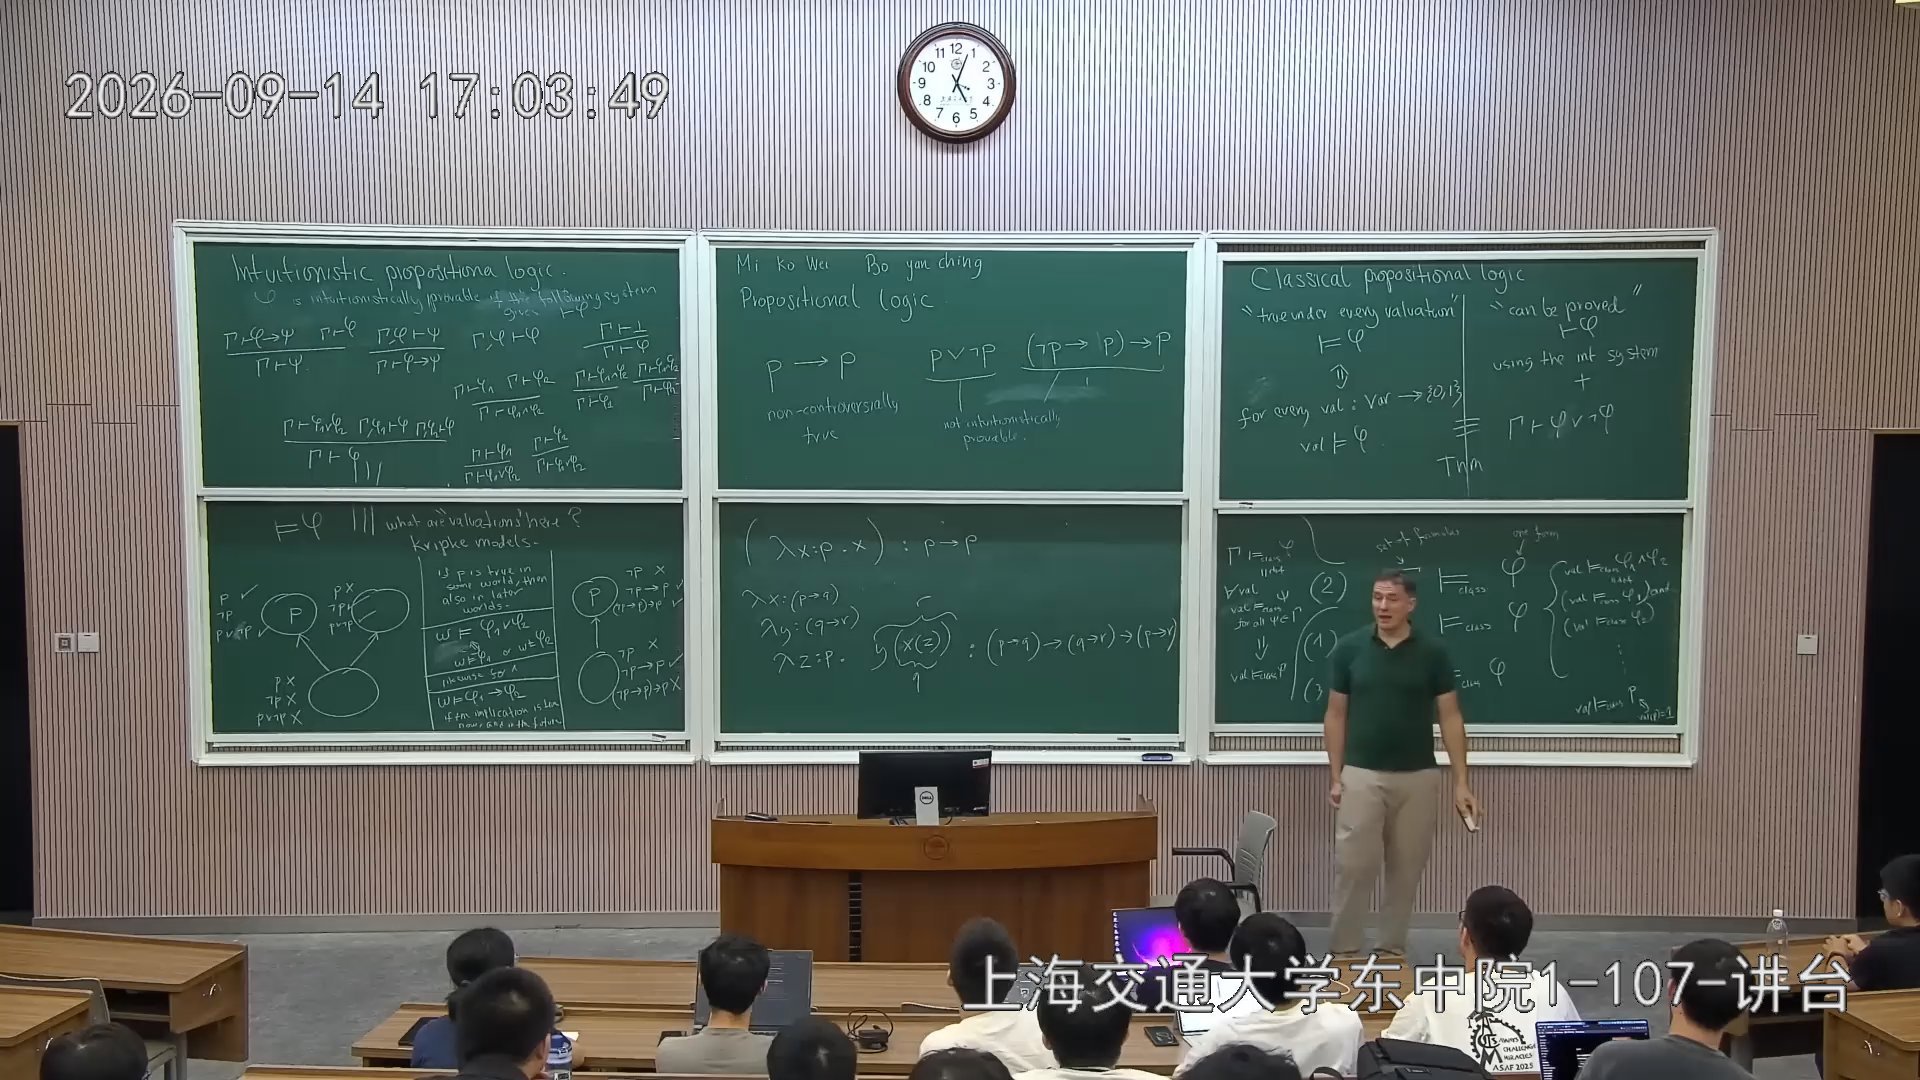 回放 B,13:30。看左上、左下保留的模型:分支根部不决定排中律,两世界链反驳(¬p→p)→p。中间上方同时保留本课的函数组合例子。
4.2 (¬p→p)→p 的两世界反例
现在把模型简化为一条链:
w0<w1,V(w0)=∅,V(w1)={p}.
当前 p 尚未成立,将来会成立。两世界都不迫使 ¬p:在 w0,后继 w1 使 p 成立;在 w1,p 就在当前成立。
因此在 w0 和 w1,蕴含 ¬p→p 都成立。理由要按定义说清楚:对于每个可到达世界,前件 ¬p 都不成立,所以没有一个世界给出“前件成立而后件不成立”的反例。尤其
w0⊩¬p→p,w0⊮p.
检查外层蕴含时,我们可以取 u=w0 自身。它使外层前件成立,却不使后件成立,于是
w0⊮(¬p→p)→p.
在终端 w1,p 已成立,整个公式也成立;但有效性要求每个模型、每个世界都成立,根部的一个失败点就足以否定有效性。
我们暂时得到的是语义反例。要进一步推出这些公式不能由直觉主义规则证明,需要可靠性定理
Γ⊢Iφ⟹Γ⊨Iφ.
反方向是完备性。经典系统也有对应的可靠性与完备性关系。两套系统的完备性证明留到下一周。
5. 从公式到类型:简单类型 λ 演算
片段 B,09:30–25:10
现在给直觉主义规则另一种直觉:把命题看作类型,把证明看作程序。例如 p→p 是一个输入 p 类型的值、输出 p 类型的值的函数。最简单的程序就是恒等函数:
λx.x:p→p.
它接收一个参数 x,直接把 x 返回。我们还可以构造函数组合:若 f:p→q、g:q→r,给定 x:p,先计算 fx:q,再计算 g(fx):r。于是
λf.λg.λx.g(fx):(p→q)→(q→r)→p→r.
箭头通常按右结合解释,因此右边最后的部分是 p→r,整个类型等于
(p→q)→((q→r)→(p→r)).
程序逐次接受三个参数,得到前两个函数和一个 p 值后,才计算一个 r 值。板书把这三个参数写成 x:p→q、y:q→r、z:p,函数体是 y(xz);这里仅统一了变量名。
5.1 类型判断和环境
我们先只用函数类型。简单类型 λ 演算的项是
t::=x∣λx.t∣tt.
它们分别表示变量、函数抽象、函数应用。这个基础语言不含循环或一般递归。判断
Γ⊢t:A
表示:在环境 Γ 给定的自由变量类型下,项 t 的类型是 A。例如
Γ=x1:A1,…,xn:An
是一组带名称的假设。同一个变量不能在环境中同时带有不一致的类型;抽象时可以选一个新变量名,避免变量捕获。
三条基本类型规则是:
Γ⊢x:Ax:A∈Γ(Var),
Γ⊢λx.t:A→BΓ,x:A⊢t:B(Abs),
Γ⊢fa:BΓ⊢f:A→BΓ⊢a:A(App).
抽象规则说:如果在假定参数 x 是 A 类型的环境下,函数体 t 能正确地产生 B 类型,那么把 x 绑定为参数之后,就得到 A→B 类型的函数。绑定之后,x 不再是整个函数的自由变量。
恒等函数的推导正是
∅⊢λx.x:p→px:p⊢x:p.
应用规则则说:一个能接受 A、返回 B 的函数,应用到一个 A 类型的参数上,结果类型就是 B。函数和参数都必须在同一个外部环境中类型正确。
5.2 为什么它们像证明规则?
现在把类型判断里的项暂时擦掉,把环境里的变量名也擦掉,只留下类型:变量规则变成假设规则,应用规则变成蕴含消去,抽象规则变成蕴含引入。
这不是偶然的外形相似。x:A 是“名为 x 的一个 A 的证明”;函数 f:A→B 是一个能把 A 的证明变成 B 的证明的过程。应用 fa 使用一个蕴含证明和它的前件证明得到后件证明。抽象 λx.t 则把“暂时假定 A 后得到 B”封装成一个从 A 到 B 的证明。
在函数组合例子中,这一点也能逐步看见:
f:p→q, g:q→r, x:p⊢fx:q,
f:p→q, g:q→r, x:p⊢g(fx):r.
接着连续三次抽象,依次撤销 x、g、f 的假设,就得到闭项和它的复合函数类型。一个空环境中的程序不依赖任何未提供的外部参数,这对应于一个没有未撤销假设的证明。
6. 合取、析取、假也有程序解释
片段 B,25:10–36:05
只用函数,我们对应的是命题逻辑的纯蕴含片段。为了对应全部规则,我们再给语言加上积类型、和类型以及空类型。
6.1 合取对应积类型
A∧B 对应积类型 A×B:一个值同时包含一个 A 值和一个 B 值,可以看成有两个字段的记录。构造和使用规则是
Γ⊢⟨s,t⟩:A×BΓ⊢s:AΓ⊢t:B,
Γ⊢π1t:AΓ⊢t:A×B,Γ⊢π2t:BΓ⊢t:A×B.
前者构造一对值,后两者取出相应字段。忽略项之后,它们分别就是合取引入和两个合取消去规则。
6.2 析取对应带标签的和类型
A∨B 对应和类型 A+B。它包含两种变体:一个左标签附带 A 值,或者一个右标签附带 B 值。标签让程序知道收到的是哪一边。
Γ⊢inl(s):A+BΓ⊢s:A,Γ⊢inr(t):A+BΓ⊢t:B.
给定 u:A+B,使用它的方法就是模式匹配,分别为两个分支提供代码:
Γ⊢case u of inl(x)↦s ; inr(y)↦t:CΓ⊢u:A+BΓ,x:A⊢s:CΓ,y:B⊢t:C.
收到左变体时,程序可以在分支里使用它携带的 A 值 x;收到右变体时,可以使用它携带的 B 值 y。两个分支必须产生同一种结果类型 C。这正好解释了析取消去为什么要求两边都得到同一个结论,以及为什么分支假设在离开分支时被撤销。课堂书写此规则时调整了类型记号;这里统一写成输入类型 A,B 和共同输出类型 C。
6.3 假对应空类型,否定仍是缩写
⊥ 对应没有构造子的空类型 0。如果在某个环境中已经有 t:0,就可以使用空类型消去得到任意类型:
Γ⊢abortA(t):AΓ⊢t:0.
没有可能的输入值,因此这个消去操作不需要真正执行某个正常分支。这解释的是爆炸律;它没有赋予我们在空环境中创造一个空类型值的能力。
课堂有关于“否定在哪里”的追问。回答是:我们没有漏掉一个否定构造子,否定一开始就是语法糖,
¬A=A→⊥,
所以对应类型是 A→0,也就是能把一个 A 值送到空类型的函数。关于否定的规则已经包含在箭头和空类型的规则中。
6.4 Curry–Howard 对应
把上面所有规则放在一起,我们得到 Curry–Howard 对应的一个基础实例:
| 逻辑 |
程序 |
| 命题、公式 |
类型 |
| 证明 |
项、程序 |
| 带名称的假设 |
带类型的自由变量 |
| 撤销假设 |
绑定变量 |
| 蕴含 |
函数类型 |
| 合取 |
积类型 |
| 析取 |
带标签的和类型 |
| 假 |
空类型 |
更准确地说,每个自然演绎证明都可以按规则逐步加上项,得到一个具有相应类型的程序;每个程序的类型推导,擦去程序部分后,又给出相应的逻辑证明。因此在这套语言中
⊢Iφ⟺存在闭项 t, ∅⊢t:φ.
只有箭头的基础简单类型 λ 演算对应纯蕴含片段;带上积、和、空类型后才对应我们刚才的全部直觉主义命题规则。
这给直觉主义一个计算上的动机:每条规则都对应一个清楚的程序构造。排中律则要求我们无条件提供
A+(A→0)
的值,或者交出一个 A,或者交出能反驳任意 A 的函数。对于任意尚未提供证据的原子类型 A,这些构造规则并没有这样的统一闭项。并不是“在程序里写一个条件语句”就得到了排中律;条件语句首先需要可执行的判定依据。
技术上看,证明规则与类型规则的对应可以逐条检查;但它揭示了很深的联系:形式证明的构造,本身就像在写程序。更丰富的逻辑和更丰富的类型语言也可以建立各自的对应,不过今天只讨论这个基础实例。
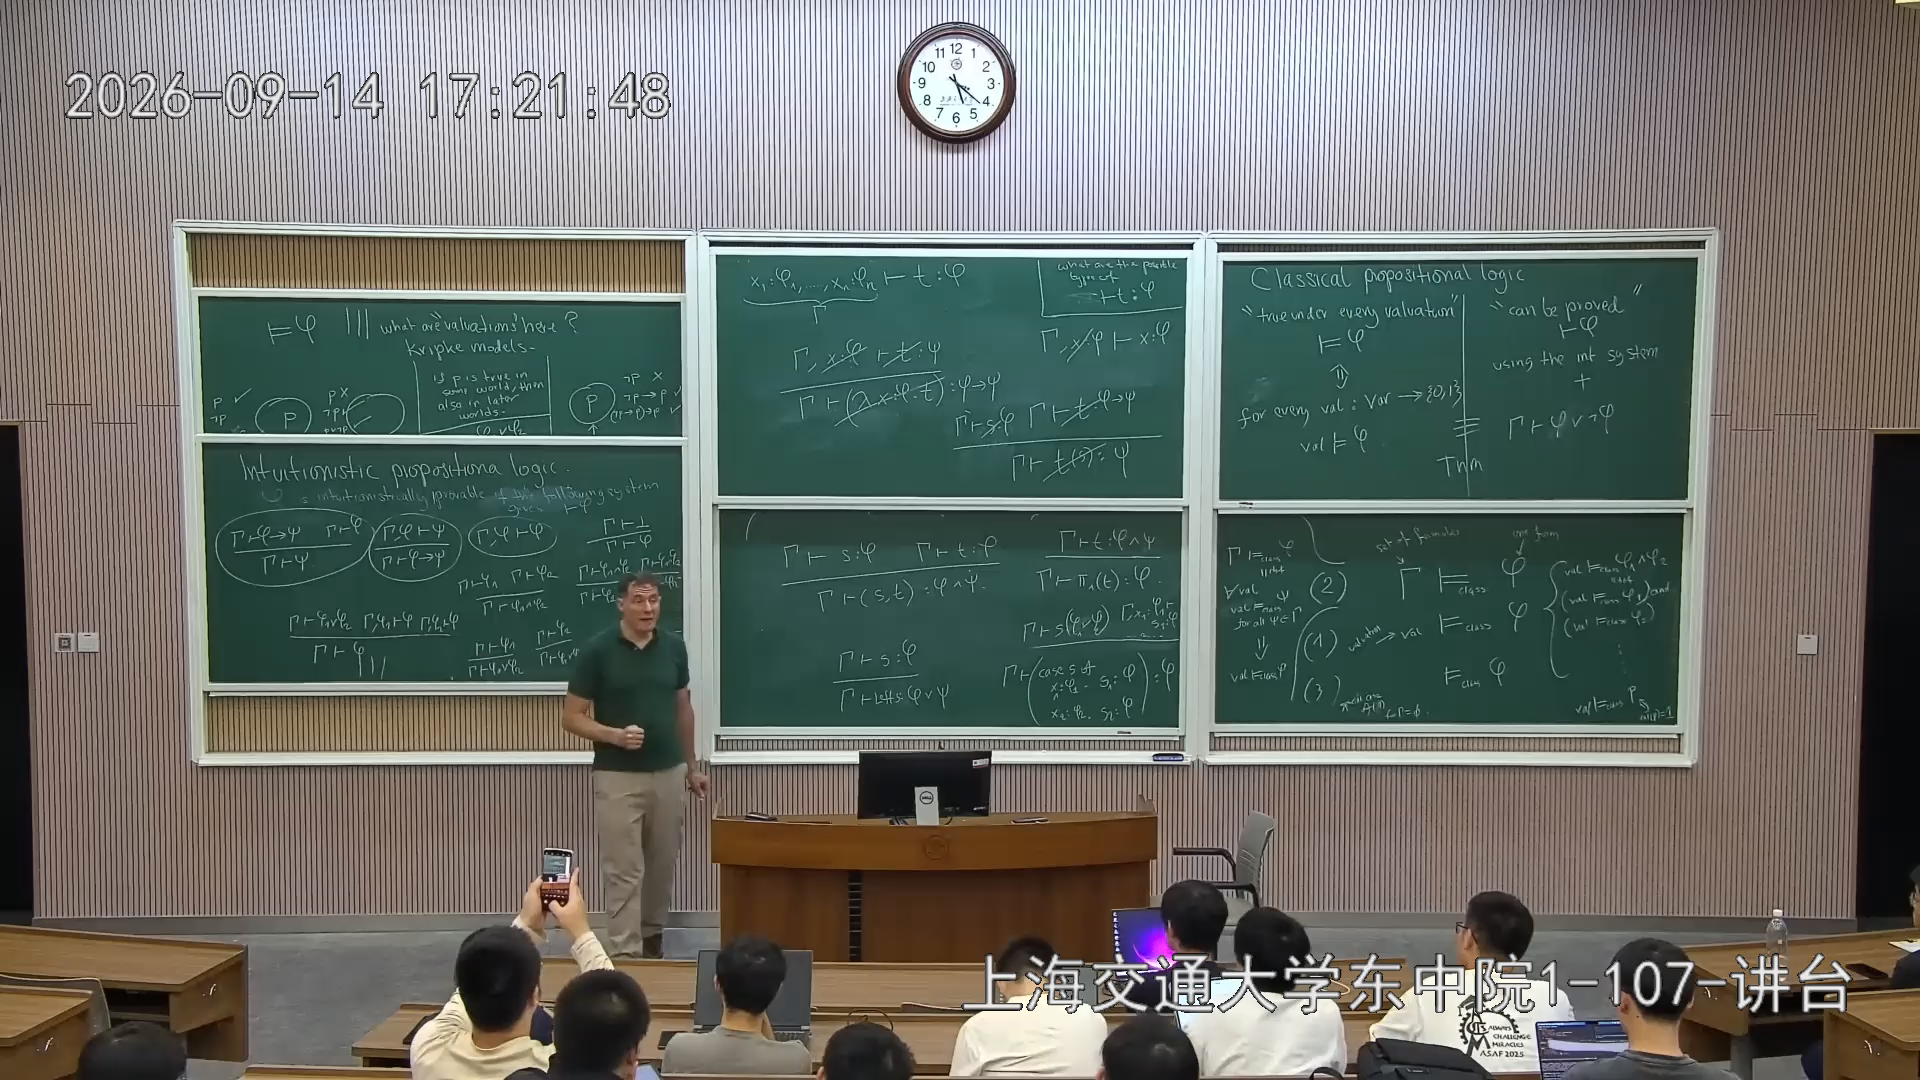 回放 B,31:30。看中间上下两块板书的变量、抽象、应用以及积、和类型规则;与左下的自然演绎规则对照。原图部分下沿较紧,完整规则已在正文补齐。
7. 终端世界与 Peirce 律:差别已经出现在纯蕴含中
片段 B,44:35–52:50
最后我们再玩几个 Kripke 模型的例子。只有一个世界的模型是退化情形:蕴含只需检查该世界自身,所以它与经典真值条件完全一致。更一般地,在没有严格后继的终端世界,所有公式的迫使关系按公式结构归纳,也与当前赋值的经典解释一致。
因此,直觉主义与经典语义的差别出现在世界之间的信息增长中。终端世界看起来是经典的,根部却可能尚未拥有最终分支中的证据。
7.1 Peirce 律的经典计算
考虑只含蕴含的 Peirce 律:
((p→q)→p)→p.
它在经典语义中有效。若 p 为真,最外层后件为真,整个式子为真。若 p 为假,则不论 q 怎样,p→q 都为真,因此 (p→q)→p 为假,最外层蕴含又因前件为假而成立。这样就覆盖了全部经典赋值。
这个例子说明,我们不需要否定或析取就能分开两种逻辑:差异已经存在于纯蕴含片段。按 Curry–Howard 对应,Peirce 律在空上下文的纯简单类型 λ 演算中没有闭项。
7.2 课堂计算的错误与一个完整的正确反例
课堂在最后尝试检查 Peirce 律的反模型时出现了计算错误。 授课者明确承认至少一处判断有误,表示下一周纠正。因此最后的未完成板书不能直接当作正确证明。
实际板书画了一个根部和两个终端分支:左分支只有 p 成立,右分支只有 q 成立。在右分支,p→q 成立而 p 不成立,所以 (p→q)→p 不成立;这也使根部的 (p→q)→p 不成立。于是我们不能用根部作为“外层前件成立、后件不成立”的证据。继续检查,左分支外层的后件 p 成立,右分支外层的前件不成立,根部的前件也不成立,因此这幅三世界草图实际上并未反驳 Peirce 律。这是按实际画面补做的核对,不是课堂已经完成的纠正。
下面把正确的两世界计算完整补齐,供我们独立复算。
取
w0<w1,V(w0)=∅,V(w1)={p},
并让 q 在两个世界都不成立。这个模型仍满足单调性。先计算内层,再计算外层:
- 在 w1,p 成立、q 不成立,因此 w1⊮p→q。
- 在 w0,可到达的 w1 同样提供“p 成立、q 不成立”的反例,因此 w0⊮p→q。不能只看 w0 当前的 p 尚不成立就判定这个蕴含成立。
- 在 w1,没有可到达世界迫使 p→q,所以 w1⊩(p→q)→p。
- 在 w0,它自己和 w1 都不迫使 p→q,同样没有反例,所以 w0⊩(p→q)→p。
- 最外层在 w0 失败:取当前世界自身,前件 (p→q)→p 成立,后件 p 却不成立。
合在一起就是
| 世界 |
p |
q |
p→q |
(p→q)→p |
((p→q)→p)→p |
| w1 |
迫使 |
不迫使 |
不迫使 |
迫使 |
迫使 |
| w0 |
不迫使 |
不迫使 |
不迫使 |
迫使 |
不迫使 |
我们得到
w0⊮((p→q)→p)→p.
这个计算最值得留意的是第二步和第四步。蕴含的前件“当前不成立”,不意味着蕴含自动成立;必须检查全部后继。而如果前件在所有可到达世界都不成立,蕴含才因没有反例而成立。逐层使用同一条定义,能避免在嵌套蕴含中凭希望给某一项打上“真”的标签。
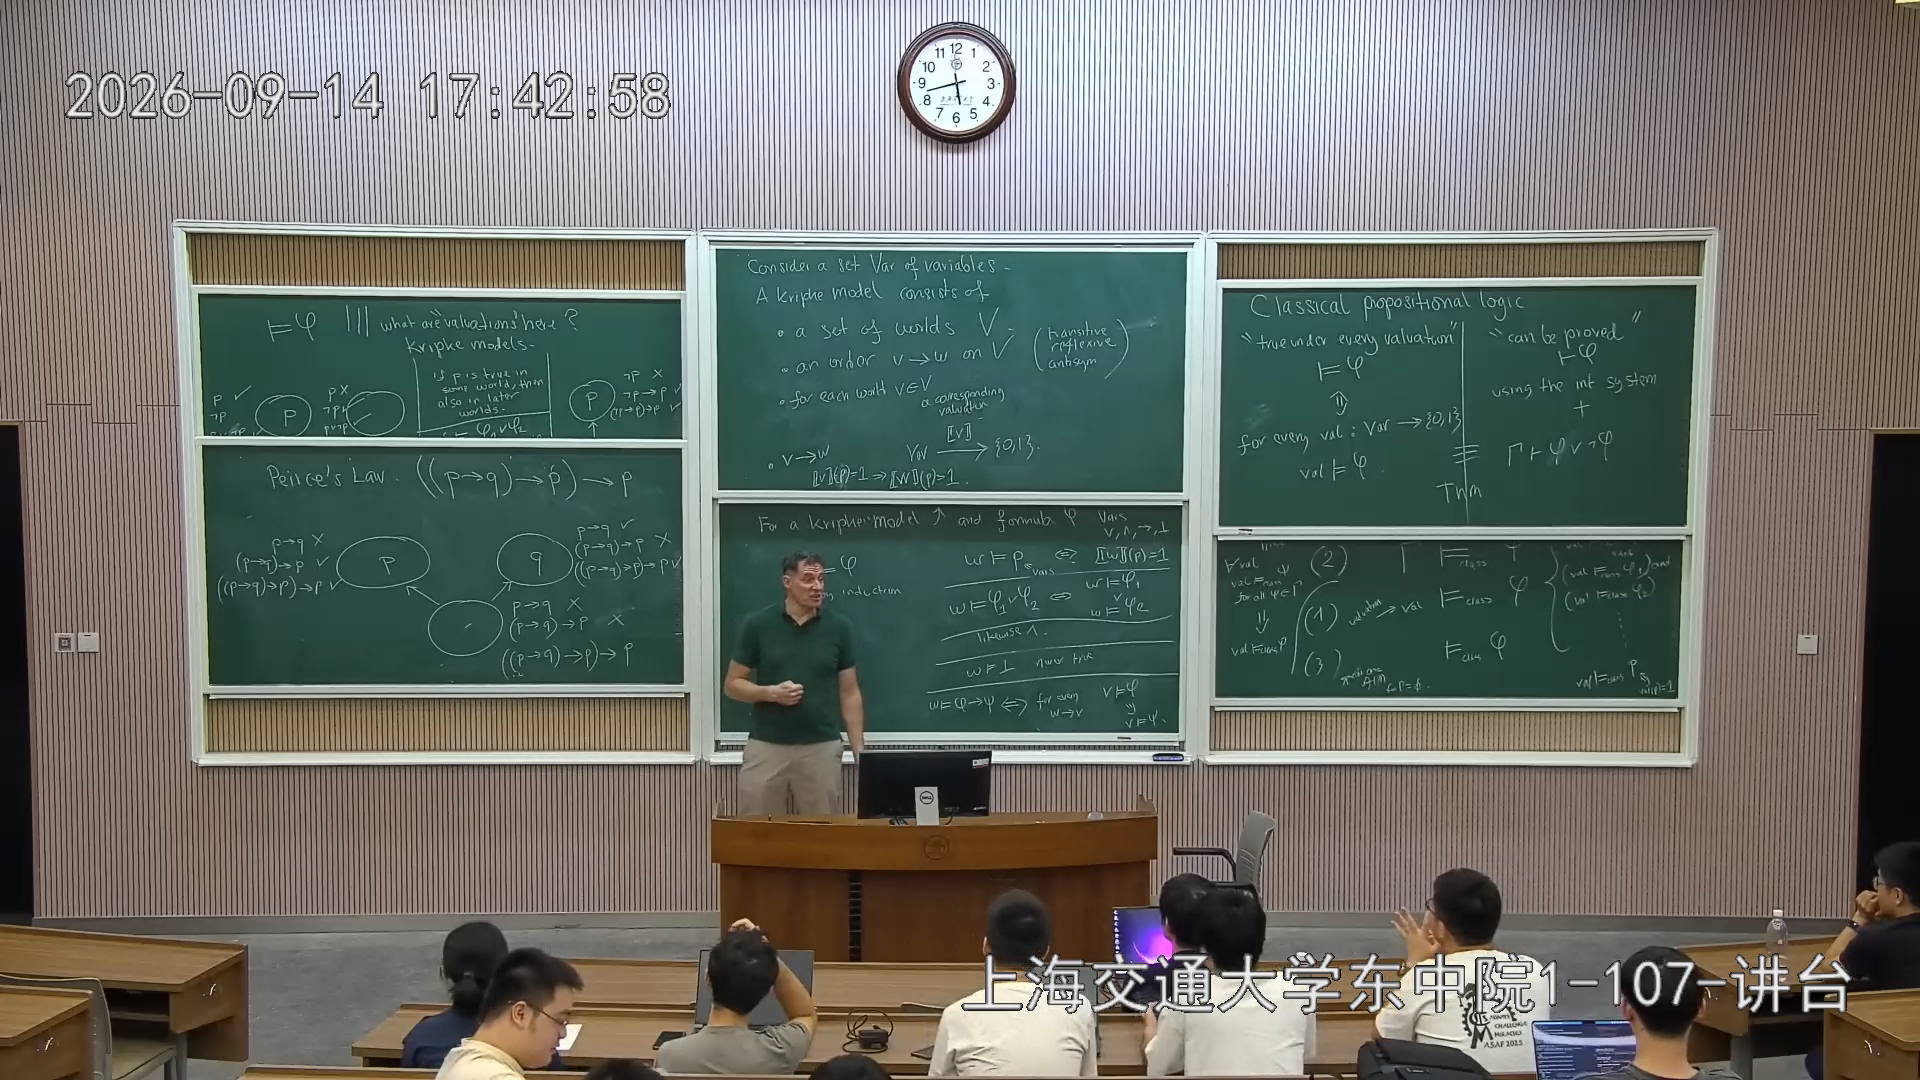 回放 B,52:40。左下是课堂尚未正确完成的三世界草图:根部空、左叶 p、右叶 q。它实际不能反驳 Peirce 律;不要沿用原图的错误真值标记,正确核对与两世界修补见正文。
来源与补全说明
依据 2026 年 9 月 14 日两段完整转写与既有回放帧整理,时间均为段内时间。课堂主线为自然演绎、Kripke 语义及 Curry–Howard 对应;持久性归纳、规范类型规则与 Peirce 正确反模型补齐了推导。完备性证明留待下课。未取得可确认的配套讲义或教材原件。