Lecture 3
Abstract
一阶逻辑把对象、关系与量词带入模型。我们从序、代数和图的例子理解可表达性,证明可数稠密无端点序的同构结论,再定义签名、自由变量、结构、赋值和满足关系。
我们先问一个问题:我们说一个公式“为真”,究竟是在什么东西里为真?在经典命题逻辑中,给每个命题变元一个真值,就给出了一个模型。一个只涉及 n n n 2 n 2^n 2 n
现在,我们想说的不只是几个整体命题之间的关系,而是“有某个对象具有性质 P P P P P P Q Q Q
这里的“一阶”不是课程顺序的编号。命题逻辑可以看作零阶的情形;一阶逻辑允许变量指向结构中的个体,并对这些个体作量化。我们先使用经典语义。此前讨论直觉主义逻辑,是为了提醒大家:逻辑可以有不同的语义;今天不再把同一套讨论重复一遍。
先看一个推理,再问公式是什么意思
考虑下面的推理:
∃ x P ( x ) , ∀ x ( P ( x ) → Q ( x ) ) ⟹ ∃ x Q ( x ) . \exists x\,P(x),\qquad \forall x\,(P(x)\to Q(x))
\quad\Longrightarrow\quad \exists x\,Q(x). ∃ x P ( x ) , ∀ x ( P ( x ) → Q ( x )) ⟹ ∃ x Q ( x ) .
它说:某个对象有性质 P P P P P P Q Q Q Q Q Q a a a
P ( a ) , P ( a ) → Q ( a ) ⟹ Q ( a ) ⟹ ∃ x Q ( x ) . P(a),\qquad P(a)\to Q(a)\quad\Longrightarrow\quad Q(a)
\quad\Longrightarrow\quad \exists x\,Q(x). P ( a ) , P ( a ) → Q ( a ) ⟹ Q ( a ) ⟹ ∃ x Q ( x ) .
中间一步仍是熟悉的蕴含消去,新的步骤是:用全称命题得到一个特定对象的实例,以及由一个实例得到存在命题。可是,“暂时把对象称为 a a a P P P P P P P ( a ) P(a) P ( a ) a a a ∃ x Q ( x ) \exists x\,Q(x) ∃ x Q ( x ) P ( a ) P(a) P ( a ) a a a P ( a ) P(a) P ( a ) Q ( a ) Q(a) Q ( a )
今天我们先给这个证明作为动机,完整的量词引入、消去规则及其变量条件留到后面。我们先把模型与公式的意义弄清楚,再讨论形式证明。
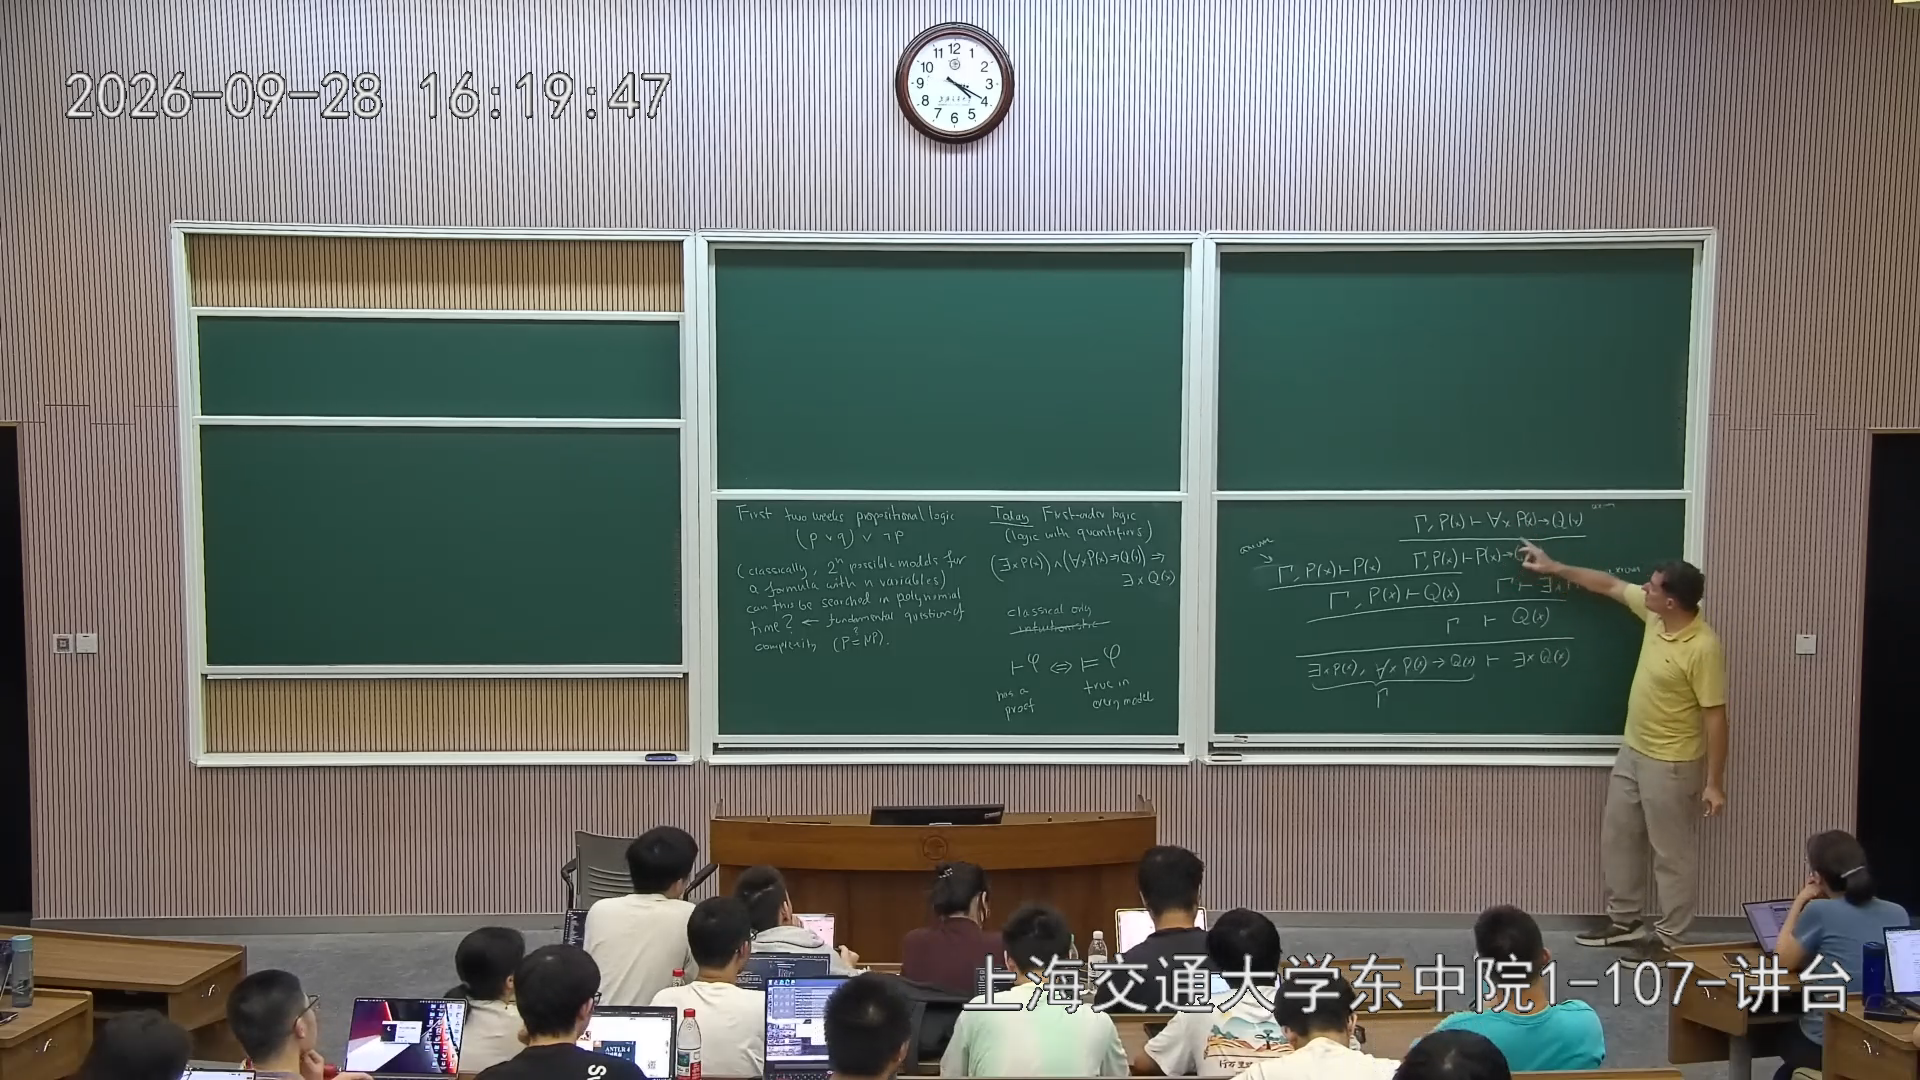
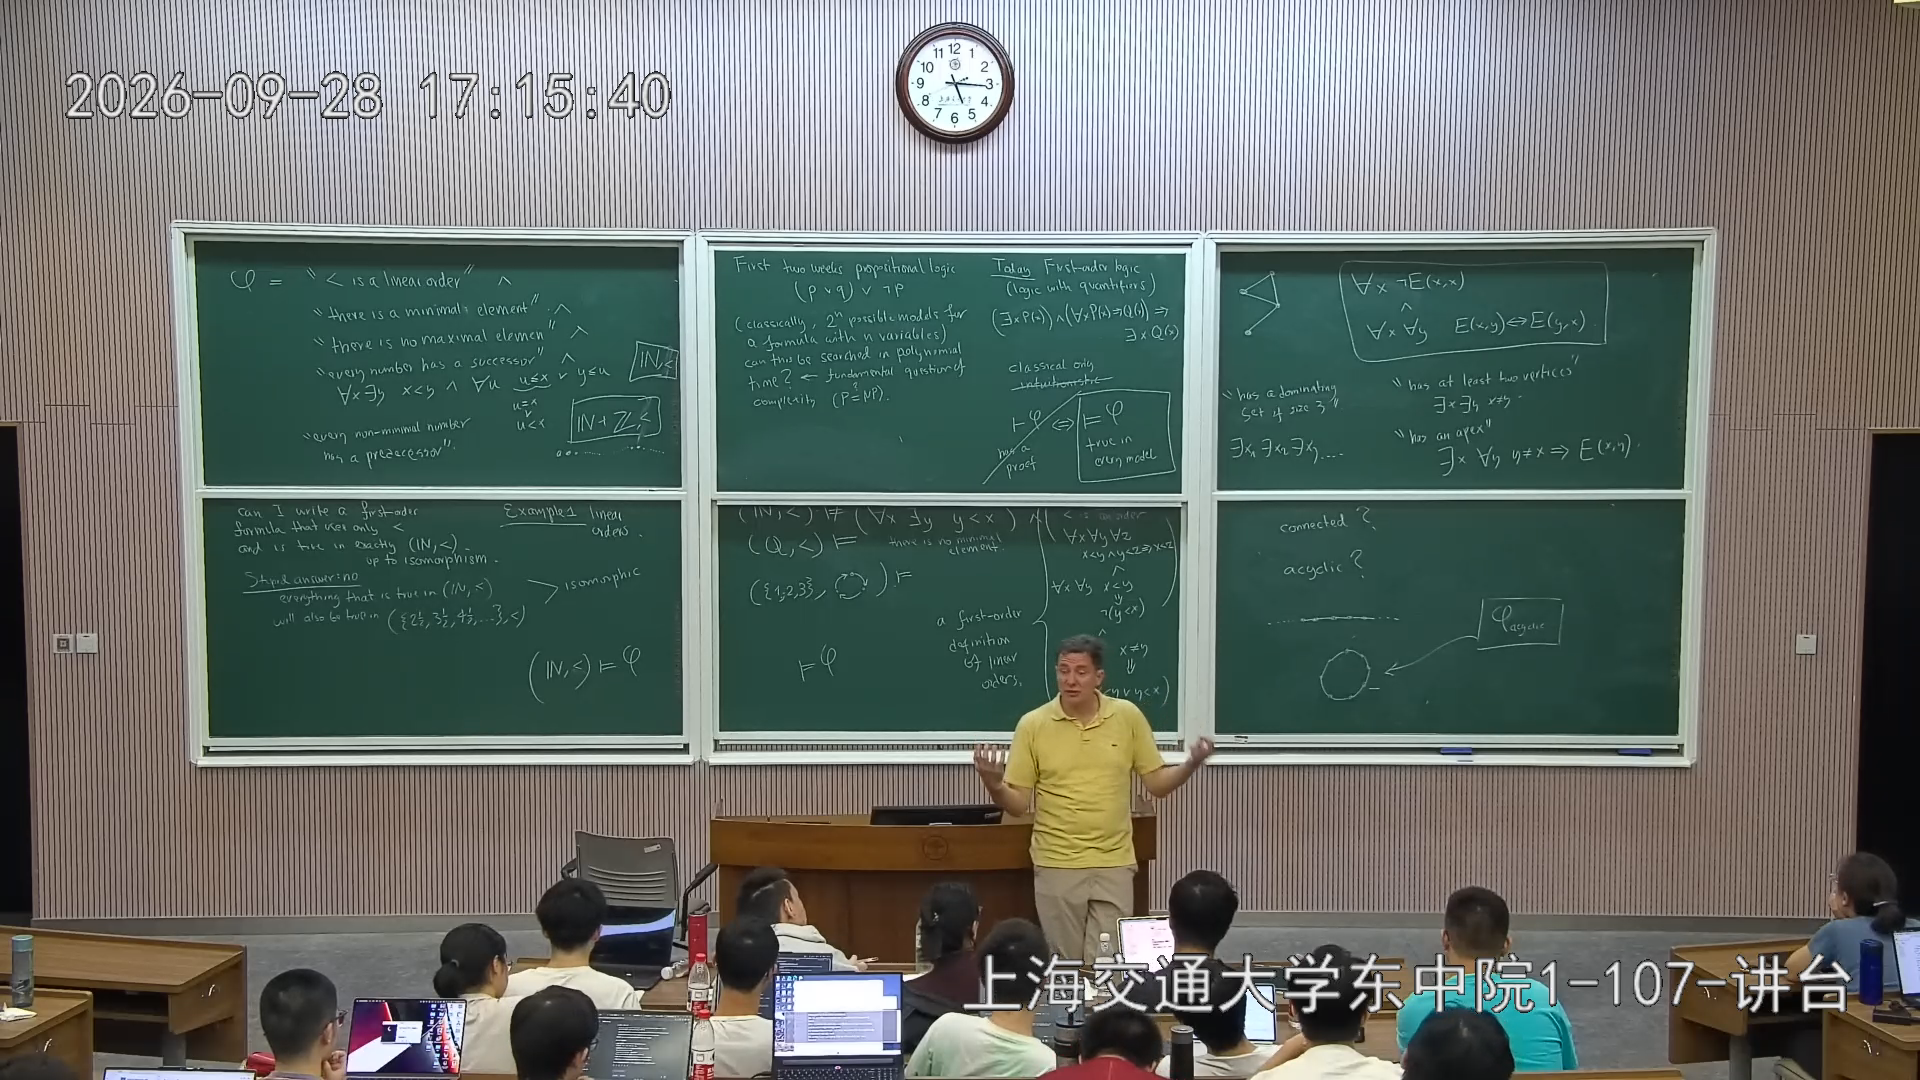
回放 A,24:50。看右下的量词推理尝试。原图中间项保留的见证变量不满足规范存在消去的新变量条件;正文补清了先得到存在结论、再撤销临时见证假设的顺序,不能直接沿用草稿中的撤销步骤。 同一个关系符号,在不同结构里可以有不同解释
看看“每个元素都有一个比它小的元素”:
∀ x ∃ y ( y < x ) . \forall x\,\exists y\,(y<x). ∀ x ∃ y ( y < x ) .
在自然数的通常严格次序 ( N , < ) (\mathbb N,<) ( N , < ) N = { 0 , 1 , 2 , … } \mathbb N=\{0,1,2,\ldots\} N = { 0 , 1 , 2 , … } x = 0 x=0 x = 0 1 1 1
在有理数的通常严格次序 ( Q , < ) (\mathbb Q,<) ( Q , < ) q ∈ Q q\in\mathbb Q q ∈ Q q − 1 q-1 q − 1 x , y x,y x , y
不过,写成 < < <
若要要求一个二元关系是严格线性序,可以写出下面三类条件:
∀ x ¬ ( x < x ) , \forall x\,\neg(x<x), ∀ x ¬ ( x < x ) ,
∀ x ∀ y ∀ z ( ( x < y ∧ y < z ) → x < z ) , \forall x\forall y\forall z\,
((x<y\land y<z)\to x<z), ∀ x ∀ y ∀ z (( x < y ∧ y < z ) → x < z ) ,
∀ x ∀ y ( x = y ∨ x < y ∨ y < x ) . \forall x\forall y\,(x=y\lor x<y\lor y<x). ∀ x ∀ y ( x = y ∨ x < y ∨ y < x ) .
第一条是不自反性,第二条是传递性,第三条保证不同元素可比较。由前两条还可推出不能同时有 x < y x<y x < y y < x y<x y < x
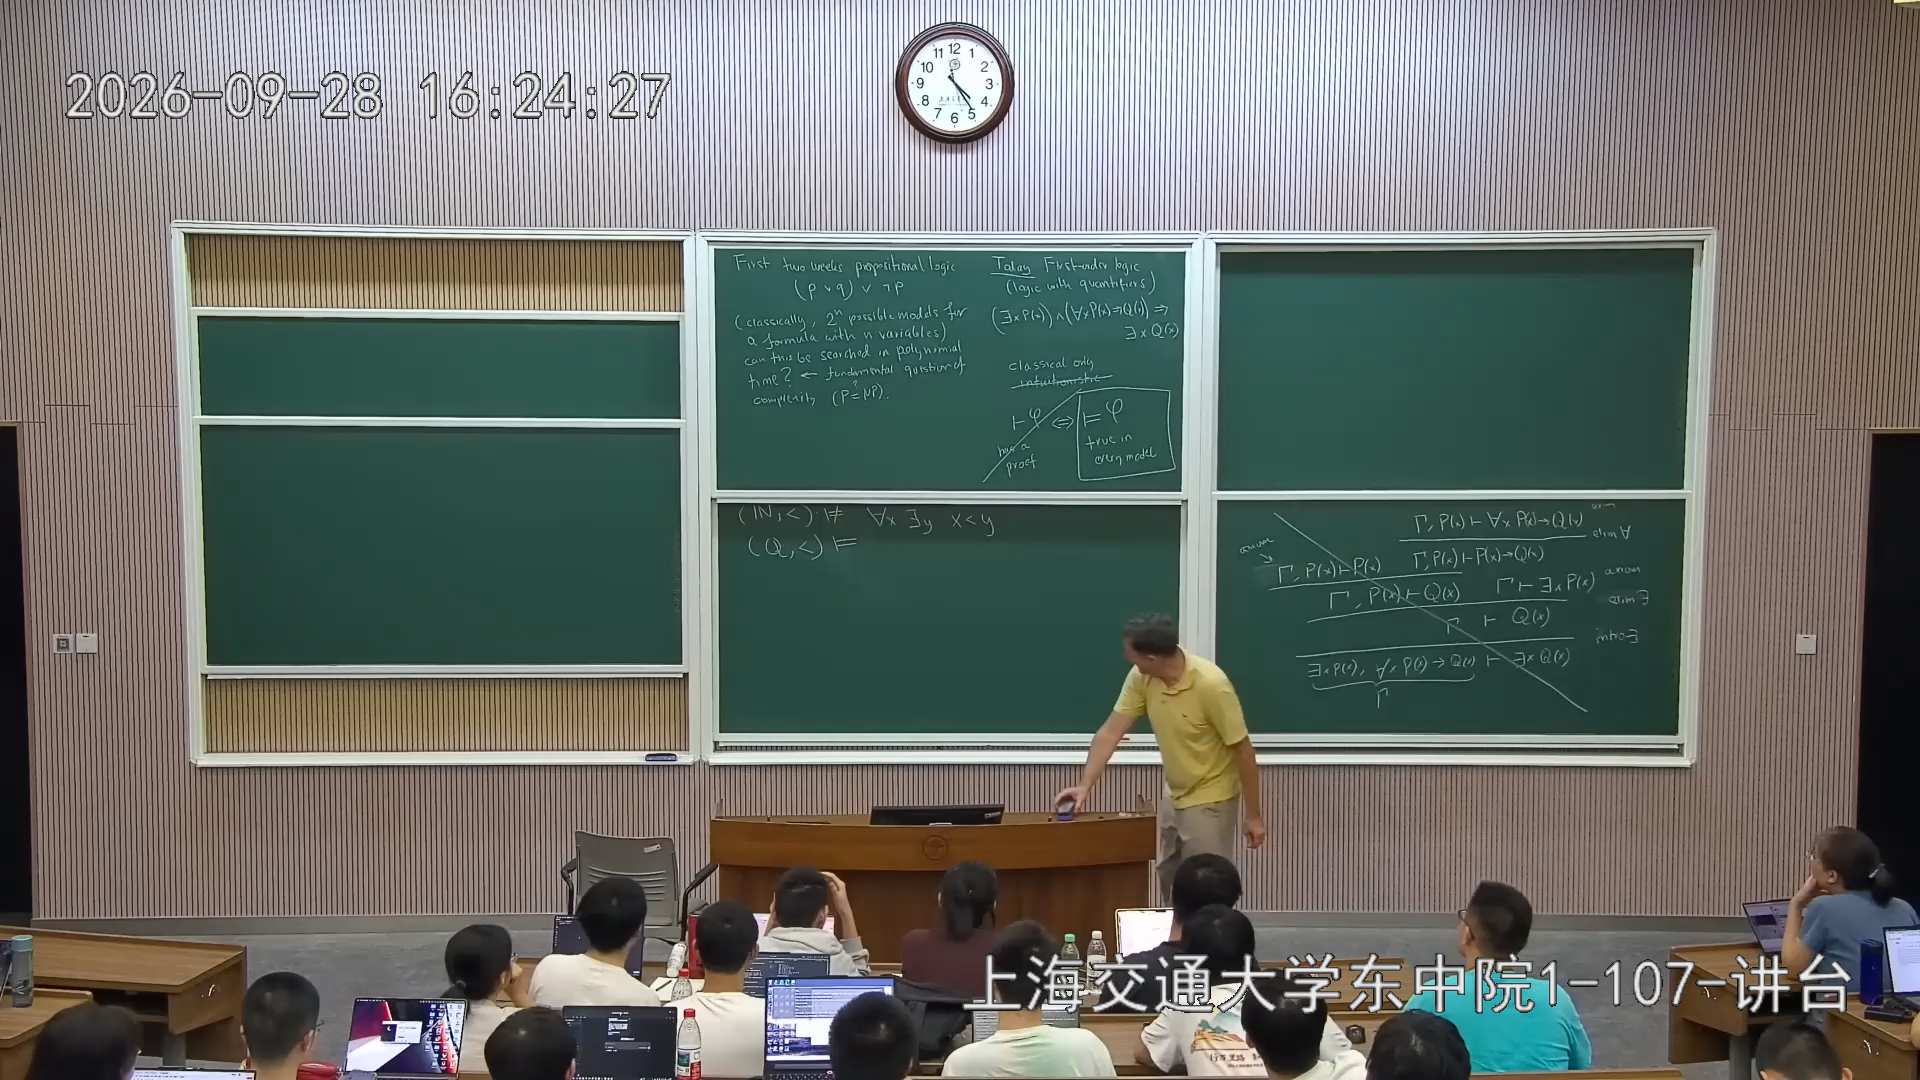
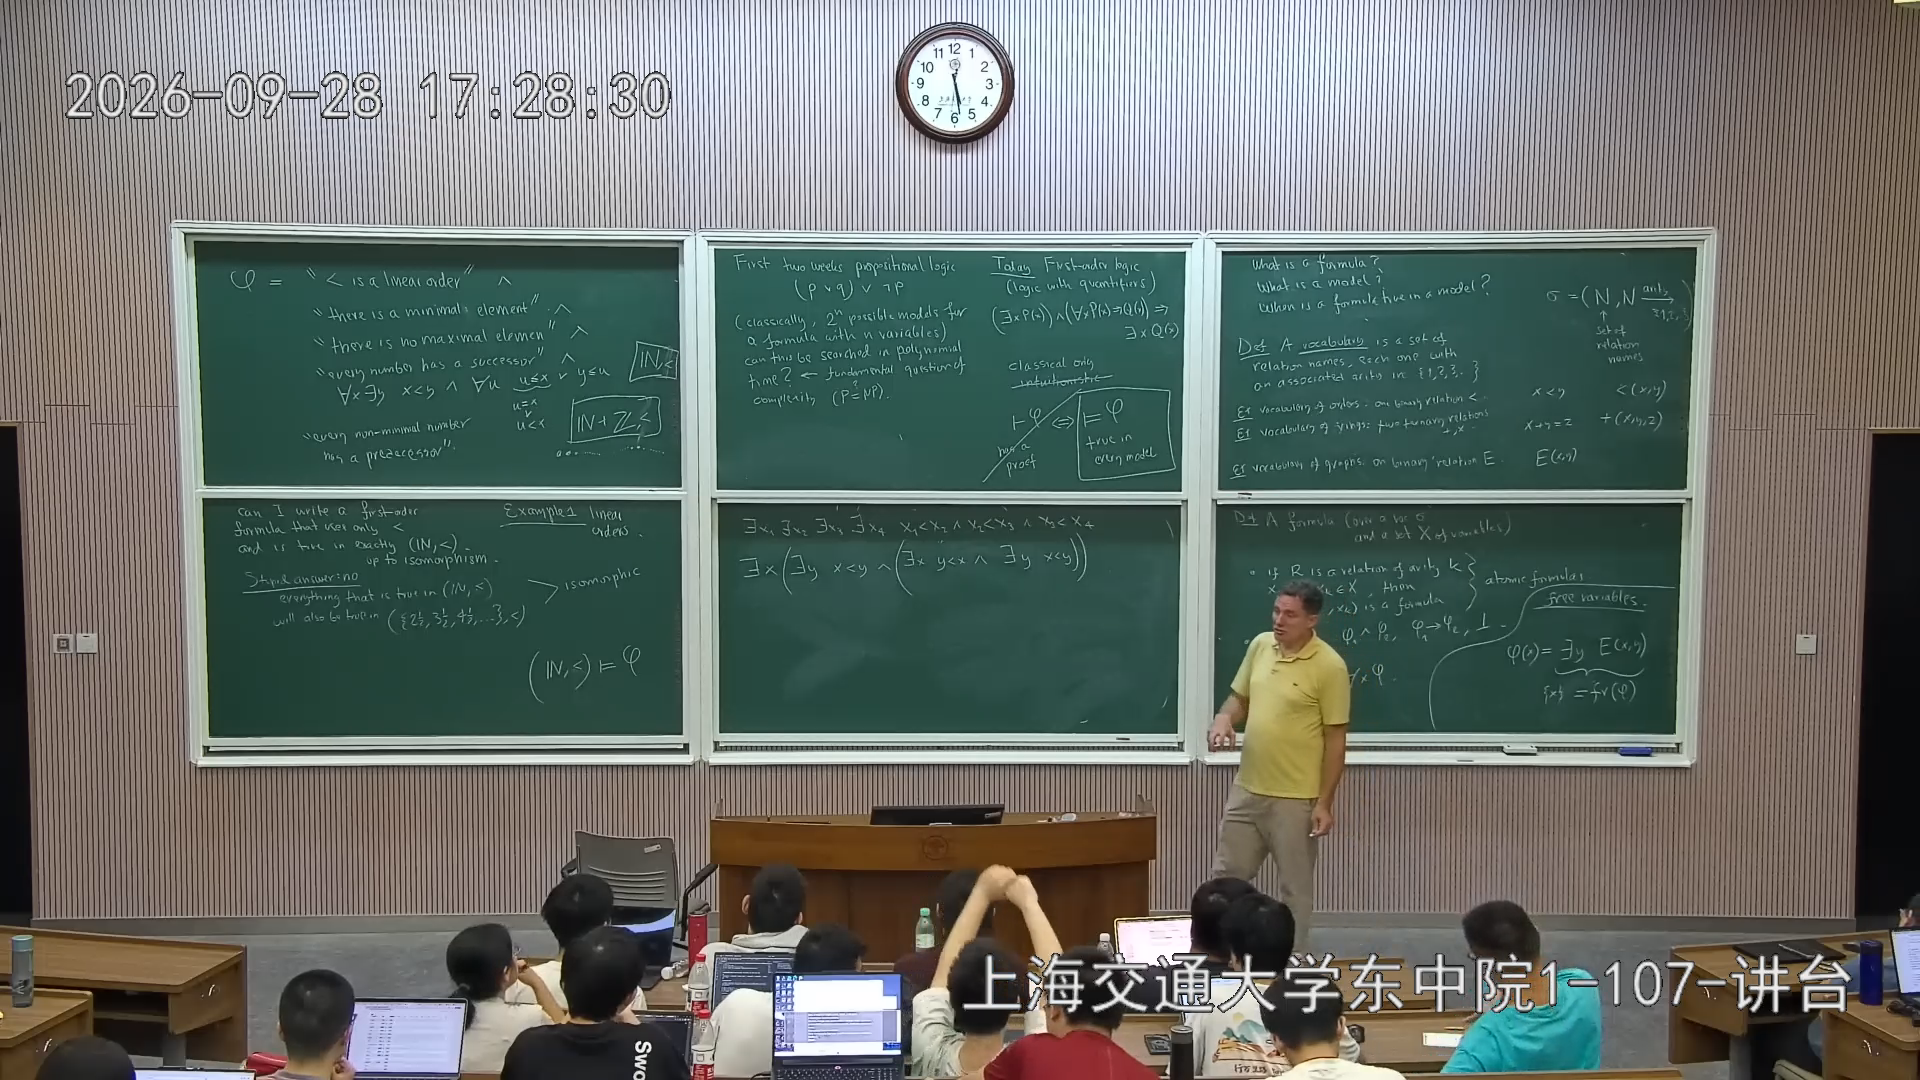
回放 A,29:30。看中间下方:同一个“每个元素都有更小元素”的量词公式,在自然数序中为假、在有理数序中为真。左侧此时尚未写出后面的自然数局部公理。 能不能用一阶公式刻画自然数的次序?
现在我们把问题变得更有挑战性:能否仅使用 < < <
首先,“恰好”必须说清楚。把 0 , 1 , 2 , … 0,1,2,\ldots 0 , 1 , 2 , … a 0 , a 1 , a 2 , … a_0,a_1,a_2,\ldots a 0 , a 1 , a 2 , … ( N , < ) (\mathbb N,<) ( N , < ) 直到同构为止 ?
两个序结构 ( A , < A ) (A,<_{A}) ( A , < A ) ( B , < B ) (B,<_{B}) ( B , < B ) f : A → B f:A\to B f : A → B
∀ a , a ′ ∈ A , a < A a ′ ⟺ f ( a ) < B f ( a ′ ) . \forall a,a'\in A,\qquad
a<_{A}a'\quad\Longleftrightarrow\quad f(a)<_{B}f(a'). ∀ a , a ′ ∈ A , a < A a ′ ⟺ f ( a ) < B f ( a ′ ) .
这不仅是“把元素重新取名”,还要求关系被完整地保留下来。一阶句子的真假在同构下不变。这里先记住这个原则;它解释了为什么不能要求模型的元素一定要叫作数字 0 , 1 , 2 0,1,2 0 , 1 , 2
接下来,我们试着收集自然数序的性质。它是线性序,有最小元素,没有最大元素;每个元素有直接后继,而每个非最小元素有直接前驱。为了写得清楚,先引入一个缩写:
Succ ( x , y ) : = x < y ∧ ¬ ∃ z ( x < z ∧ z < y ) . \operatorname{Succ}(x,y)\;:=\;
x<y\land\neg\exists z\,(x<z\land z<y). Succ ( x , y ) := x < y ∧ ¬∃ z ( x < z ∧ z < y ) .
这个缩写没有增加新的关系符号,它只是说 y y y x x x
∃ m ∀ x ( m = x ∨ m < x ) , ∀ x ∃ y ( x < y ) , \exists m\,\forall x\,(m=x\lor m<x),
\qquad
\forall x\,\exists y\,(x<y), ∃ m ∀ x ( m = x ∨ m < x ) , ∀ x ∃ y ( x < y ) ,
∀ x ∃ y Succ ( x , y ) , \forall x\,\exists y\,\operatorname{Succ}(x,y), ∀ x ∃ y Succ ( x , y ) ,
∀ x ( ( ∃ u u < x ) → ∃ y Succ ( y , x ) ) . \forall x\,
\bigl((\exists u\,u<x)\to
\exists y\,\operatorname{Succ}(y,x)\bigr). ∀ x ( ( ∃ u u < x ) → ∃ y Succ ( y , x ) ) .
为什么要把“直接后继”单独写出来?因为没有最大元素太弱了。有理数也没有最大元素,但给定 q < r q<r q < r ( q + r ) / 2 (q+r)/2 ( q + r ) /2
然而,要求直接后继仍然不够。把两份自然数序前后连接,形成
N + N , \mathbb N+\mathbb N, N + N ,
第一份的每个元素都在第二份的每个元素之前。它仍有最小元素、没有最大元素,而且每个元素有直接后继。问题出在第二份的第一个元素:它不是整个序的最小元素,却没有直接前驱,因为第一份没有最后一个元素。于是我们又补上了非最小元素有直接前驱的条件。
但再看
N + Z . \mathbb N+\mathbb Z. N + Z .
这里把一份整数序整体放在自然数序后面。整数部分没有第一个元素,每个整数都可以在整数部分中找到直接前驱和后继。因而刚才所有条件都成立;这个结构却不是自然数序。自然数部分与整数部分之间有一个“间隔”,但它不是某一对相邻元素之间的空档,也没有一个“进入整数部分的第一点”供公式轻易抓住。
课堂还讨论了更丰富的排列:以一个稠密序作索引,在某些位置放整数块,在最前面放自然数块。要点相同:单凭反复增加眼前这些局部条件,未必能消除额外的块。
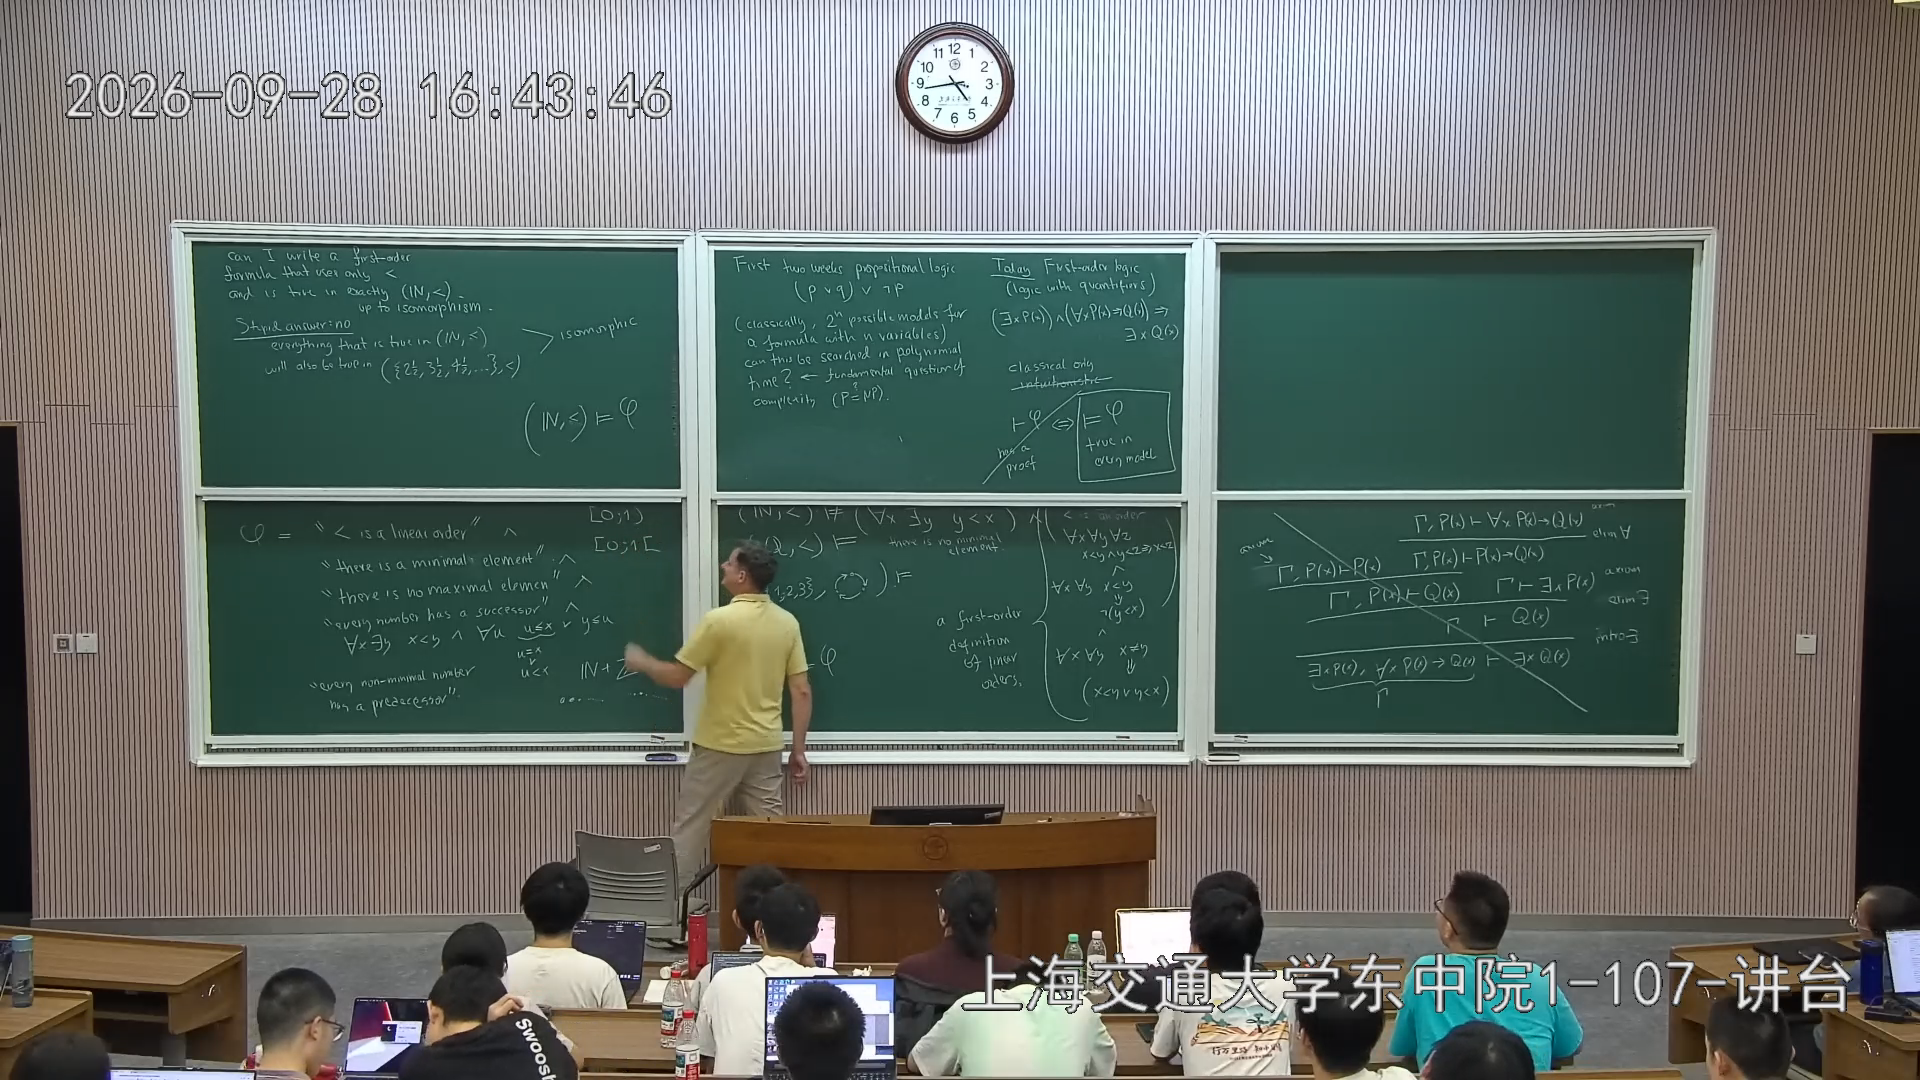
回放 A,48:50。看左上 N 与 N+Z 的对照以及“非最小元素有前驱”的条件;增加这个局部条件仍不能排除后接整数块的反例。 我们在这里给出一个以后要证明的结论:在只含次序关系的语言中,自然数序与上述适当的非标准离散序,可以满足相同的一阶句子。一阶逻辑因此不能用一个句子把自然数序刻画到同构为止。正式证明将在后续建立。
这个区别值得记住:同构一定意味着满足同样的一阶句子,反过来未必成立。 如果两个结构满足相同的一阶句子,我们称它们一阶等价。逻辑所能辨认的信息,可以少于完整结构包含的信息。
有理数序:限制为可数结构之后,我们几乎能做到
接着问有理数的次序能否被刻画。一个立即出现的障碍是:( Q , < ) (\mathbb Q,<) ( Q , < ) ( R , < ) (\mathbb R,<) ( R , < )
可是,如果我们预先保证结构的域是可数的,情况就不同了。考虑一个非空线性序 ( A , < ) (A,<) ( A , < )
∀ x ∀ y ( x < y → ∃ z ( x < z ∧ z < y ) ) , \forall x\forall y\,
\bigl(x<y\to\exists z\,(x<z\land z<y)\bigr), ∀ x ∀ y ( x < y → ∃ z ( x < z ∧ z < y ) ) ,
∀ x ∃ y ( y < x ) , ∀ x ∃ y ( x < y ) . \forall x\,\exists y\,(y<x),
\qquad
\forall x\,\exists y\,(x<y). ∀ x ∃ y ( y < x ) , ∀ x ∃ y ( x < y ) .
线性序、稠密、无端点都是一阶条件;可数性是外部给定的条件。 在这个承诺下,任何满足这些条件的序都与 ( Q , < ) (\mathbb Q,<) ( Q , < )
我们来把这个正面结果的证明做出来。设
Q = { q 0 , q 1 , q 2 , … } , A = { a 0 , a 1 , a 2 , … } \mathbb Q=\{q_0,q_1,q_2,\ldots\},\qquad
A=\{a_0,a_1,a_2,\ldots\} Q = { q 0 , q 1 , q 2 , … } , A = { a 0 , a 1 , a 2 , … }
是两边的枚举。我们逐步建立有限的、保持次序的部分双射。只在一边不停地选点是不够的:那样最后可能漏掉另一边的元素,所以必须轮流从两边出发。
在“向前”一步,我们取枚举中第一个还没有被配对的 q i q_i q i A A A
在“向后”一步,我们取 A A A a j a_j a j Q \mathbb Q Q
设第 n n n f n f_n f n
f = ⋃ n ∈ N f n . f=\bigcup_{n\in\mathbb N}f_n. f = n ∈ N ⋃ f n .
因为每一步总选相应枚举中第一个遗漏的元素,每个 q i q_i q i a j a_j a j f f f Q \mathbb Q Q A A A f f f
这就是来回法(back-and-forth)的一个具体例子。可数性真正用在能把两边列成枚举,并通过可数多步保证每个元素都被覆盖的地方。
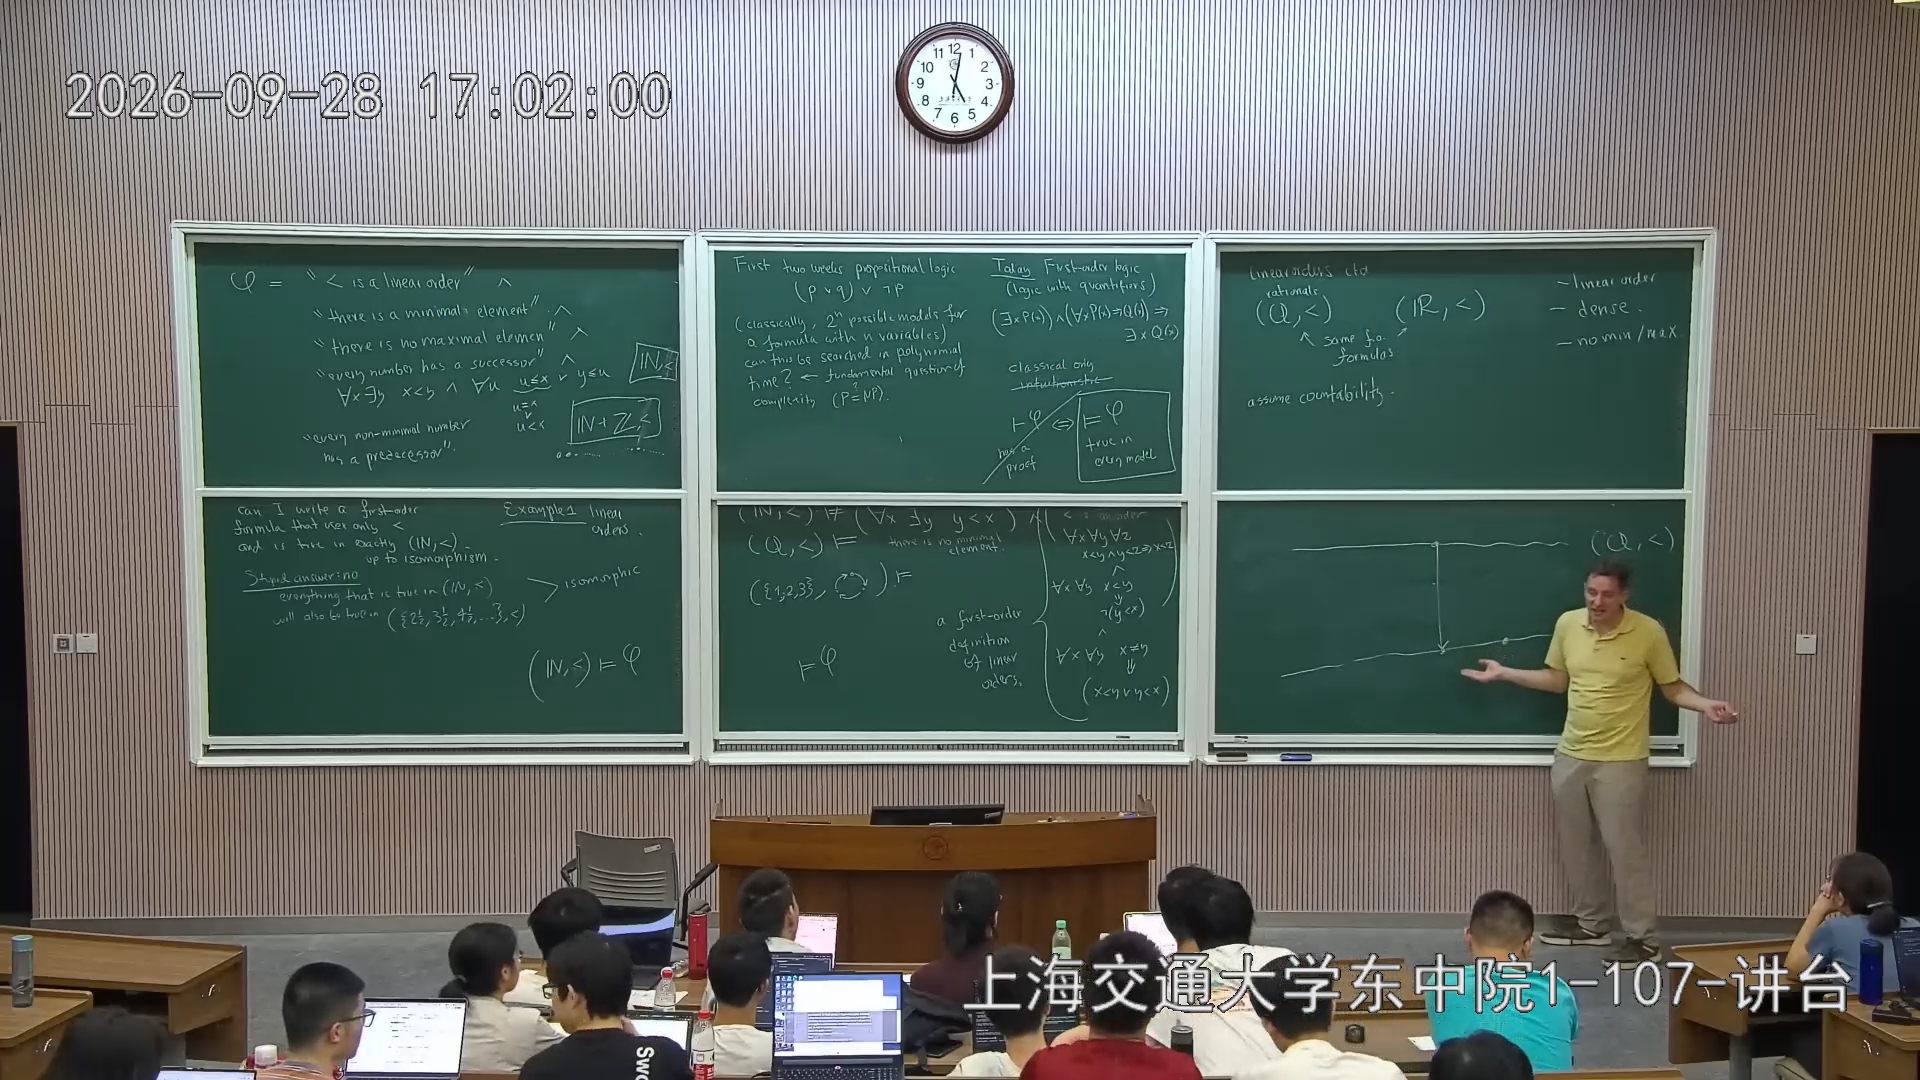
回放 B,11:40。看课堂关于可数稠密无端点序的配对讨论;两侧轮流补入未匹配元素,完整扩展与满射论证在正文展开。 代数中的运算:今天把它们编码成关系
不仅次序可以用一阶逻辑讨论。我们也可以表达环中的加法、乘法性质。不过,我们今天刻意使用的是关系语言 :把加法记为三元关系 Add ( x , y , z ) \operatorname{Add}(x,y,z) Add ( x , y , z ) x x x y y y z z z Mul ( x , y , z ) \operatorname{Mul}(x,y,z) Mul ( x , y , z )
这里有三个参数,而不是两个。第三个参数是候选结果,关系回答这个候选是否正确。若改用二元函数符号 + + + x + x + x x+x+x x + x + x z z z x x x
∃ u ( Add ( x , x , u ) ∧ Add ( u , x , z ) ) . \exists u\,
\bigl(\operatorname{Add}(x,x,u)\land
\operatorname{Add}(u,x,z)\bigr). ∃ u ( Add ( x , x , u ) ∧ Add ( u , x , z ) ) .
采用函数符号往往更方便,但会增加项和公式定义的工作;今天为了把定义讲清楚,先不把函数加入正式语言。
有加法中性元,可以用一句存在量化表达:
∃ e ∀ x ( Add ( e , x , x ) ∧ Add ( x , e , x ) ) . \exists e\,\forall x\,
\bigl(\operatorname{Add}(e,x,x)\land
\operatorname{Add}(x,e,x)\bigr). ∃ e ∀ x ( Add ( e , x , x ) ∧ Add ( x , e , x ) ) .
加法交换律则可以表达为
∀ x ∀ y ∀ z ( Add ( x , y , z ) ↔ Add ( y , x , z ) ) . \forall x\forall y\forall z\,
\bigl(\operatorname{Add}(x,y,z)
\leftrightarrow\operatorname{Add}(y,x,z)\bigr). ∀ x ∀ y ∀ z ( Add ( x , y , z ) ↔ Add ( y , x , z ) ) .
但也要留意:一个任意的三元关系还不自动是运算的图。如果确实要用它编码一个处处有定义的二元运算,就需要保证每一对输入有且仅有一个输出。例如,加法的这项要求是
∀ x ∀ y ∃ z ( Add ( x , y , z ) ∧ ∀ w ( Add ( x , y , w ) → w = z ) ) . \forall x\forall y\,\exists z\,
\left(\operatorname{Add}(x,y,z)\land
\forall w\,(\operatorname{Add}(x,y,w)\to w=z)\right). ∀ x ∀ y ∃ z ( Add ( x , y , z ) ∧ ∀ w ( Add ( x , y , w ) → w = z ) ) .
课堂还提出了“没有零因子”的性质。在已经保证结构是环、e e e
∀ x ∀ y ( Mul ( x , y , e ) → ( x = e ∨ y = e ) ) . \forall x\forall y\,
\bigl(\operatorname{Mul}(x,y,e)\to(x=e\lor y=e)\bigr). ∀ x ∀ y ( Mul ( x , y , e ) → ( x = e ∨ y = e ) ) .
其中 e e e x y = 0 xy=0 x y = 0 0 0 0
图结构:容易表达的局部性质与困难的整体性质
在图中,域是顶点集,二元关系 E ( x , y ) E(x,y) E ( x , y )
∀ x ¬ E ( x , x ) , ∀ x ∀ y ( E ( x , y ) → E ( y , x ) ) . \forall x\,\neg E(x,x),
\qquad
\forall x\forall y\,(E(x,y)\to E(y,x)). ∀ x ¬ E ( x , x ) , ∀ x ∀ y ( E ( x , y ) → E ( y , x )) .
第一条排除自环,第二条要求对称。因为量词遍历所有有序对,第二条也保证反方向的蕴含。如果讨论有向图,就不能默认加上对称条件。
例如,“至少有两个顶点”只需要 ∃ x ∃ y ( x ≠ y ) \exists x\exists y\,(x\ne y) ∃ x ∃ y ( x = y )
∃ x ∀ y ( y ≠ x → E ( x , y ) ) . \exists x\,\forall y\,(y\ne x\to E(x,y)). ∃ x ∀ y ( y = x → E ( x , y )) .
这里必须说“其他顶点”:简单图没有自环,不能把条件写成 ∀ y E ( x , y ) \forall y\,E(x,y) ∀ y E ( x , y )
再看大小为三的支配集:存在三个不同的顶点,使每个顶点或者是其中之一,或者与其中一个相邻。公式是
∃ x 1 ∃ x 2 ∃ x 3 ( x 1 ≠ x 2 ∧ x 1 ≠ x 3 ∧ x 2 ≠ x 3 ∧ ∀ y ( y = x 1 ∨ y = x 2 ∨ y = x 3 ∨ E ( y , x 1 ) ∨ E ( y , x 2 ) ∨ E ( y , x 3 ) ) ) . \begin{aligned}
\exists x_1\exists x_2\exists x_3\,\bigl(&
x_1\ne x_2\land x_1\ne x_3\land x_2\ne x_3\\
&\land\forall y\,(y=x_1\lor y=x_2\lor y=x_3
\lor E(y,x_1)\lor E(y,x_2)\lor E(y,x_3))\bigr).
\end{aligned} ∃ x 1 ∃ x 2 ∃ x 3 ( x 1 = x 2 ∧ x 1 = x 3 ∧ x 2 = x 3 ∧ ∀ y ( y = x 1 ∨ y = x 2 ∨ y = x 3 ∨ E ( y , x 1 ) ∨ E ( y , x 2 ) ∨ E ( y , x 3 )) ) .
必须把 y = x i y=x_i y = x i
连通性却不同。两点连通,是说存在一条有限长度的路径,但没有事先给出长度上限。对任何固定的 k k k k k k k k k
前面自然数与额外整数块的例子也提供了直觉。把严格序中的直接后继关系定义出来,再忘掉其他次序信息,只保留无向相邻关系。自然数给出一条连通的单向无限路径,而 N + Z \mathbb N+\mathbb Z N + Z
于是,图的连通性不能被一个一阶句子在所有图中定义。这个结论在本课仍依赖前面尚待证明的不可区分性;这里的替换解释补出了从序结构到图结构的推理桥梁。
“有环”与不可表达性论证的量词顺序
“图中有一个环”也带来类似困难,但这里我们特别纠正一种证明思路。固定长度的环完全可以写出来。对于 k ≥ 3 k\ge3 k ≥ 3
∃ x 0 ⋯ ∃ x k − 1 ( ⋀ 0 ≤ i < j < k x i ≠ x j ∧ ⋀ i = 0 k − 1 E ( x i , x ( i + 1 ) m o d k ) ) , \exists x_0\cdots\exists x_{k-1}\,
\left(
\bigwedge_{0\le i<j<k}x_i\ne x_j
\land
\bigwedge_{i=0}^{k-1}E(x_i,x_{(i+1)\bmod k})
\right), ∃ x 0 ⋯ ∃ x k − 1 0 ≤ i < j < k ⋀ x i = x j ∧ i = 0 ⋀ k − 1 E ( x i , x ( i + 1 ) mod k ) ,
就表达存在长度为 k k k
所以,我们不能指望找到一张固定的有环图和一张固定的无环图,使它们满足所有相同的一阶句子:第一张图里的某个环总有一个具体有限长度 k k k
要否定“有一个句子定义有环”,真正需要的是:对每个候选公式,找出适合这个公式的一对反例。 反例可以随着公式而改变。符号上,所需的是
∀ φ ∃ G , H ( G 有环 , H 无环 , ( G ⊨ φ ⟺ H ⊨ φ ) ) , \forall\varphi\;\exists G,H\;
\bigl(G\text{ 有环},\ H\text{ 无环},\
(G\models\varphi\Longleftrightarrow H\models\varphi)\bigr), ∀ φ ∃ G , H ( G 有环 , H 无环 , ( G ⊨ φ ⟺ H ⊨ φ ) ) ,
而不是要求
∃ G , H ∀ φ ( G ⊨ φ ⟺ H ⊨ φ ) . \exists G,H\;\forall\varphi\;
(G\models\varphi\Longleftrightarrow H\models\varphi). ∃ G , H ∀ φ ( G ⊨ φ ⟺ H ⊨ φ ) .
课堂的想法是:根据候选公式的有限观察能力,选取足够大的环,再与合适的无环结构比较。严格量化“足够大”并证明不可区分,需要后面的工具。
回放 B,25:20。右上列出至少两个顶点和 apex 等局部性质;右下比较大圈与双向无限路径,并讨论候选无环公式。反例结构随候选公式选择。 把刚才使用的语言正式定义出来
例子积累够了,我们来完成形式化。首先指定词汇表,也叫签名。今天的关系签名 σ \sigma σ
arity : σ → { 1 , 2 , 3 , … } . \operatorname{arity}:\sigma\to\{1,2,3,\ldots\}. arity : σ → { 1 , 2 , 3 , … } .
元数是关系需要的参数个数。次序签名有一个二元符号 < < < E E E Add , Mul \operatorname{Add},\operatorname{Mul} Add , Mul
关系符号可以有很多个,甚至无限多个,但一个公式只使用有限多个符号,每个关系符号的元数是有限的。正式板书把元数取在 { 1 , 2 , 3 , … } \{1,2,3,\ldots\} { 1 , 2 , 3 , … }
我们另备一组变量 x , y , z , x 1 , x 2 , … x,y,z,x_1,x_2,\ldots x , y , z , x 1 , x 2 , … R ∈ σ R\in\sigma R ∈ σ k k k
R ( x 1 , … , x k ) R(x_1,\ldots,x_k) R ( x 1 , … , x k )
是原子公式,其中各位置可以重复同一个变量。为统一前面的序、图例子,我们采用带逻辑等号的整理约定:另允许相等原子公式 x = y x=y x = y
从原子公式出发,可以用命题联结词构造更大的公式,也可以添加量词:如果 φ \varphi φ ∃ x φ \exists x\,\varphi ∃ x φ ∀ x φ \forall x\,\varphi ∀ x φ x + ( y + z ) x+(y+z) x + ( y + z )
自由变量、束缚变量与作用域
量词绑定的是其作用域中的变量出现。一个变量名字可以在同一公式中既有自由出现,也有束缚出现,所以我们首先区分的是出现位置 。例如
E ( x , y ) ∧ ∃ x E ( x , z ) E(x,y)\land\exists x\,E(x,z) E ( x , y ) ∧ ∃ x E ( x , z )
中,左边的 x x x x x x ∃ x \exists x ∃ x y , z y,z y , z { x , y , z } \{x,y,z\} { x , y , z }
可以递归计算自由变量集合:
FV ( R ( x 1 , … , x k ) ) = { x 1 , … , x k } , \operatorname{FV}(R(x_1,\ldots,x_k))=\{x_1,\ldots,x_k\}, FV ( R ( x 1 , … , x k )) = { x 1 , … , x k } ,
FV ( ¬ φ ) = FV ( φ ) , FV ( φ ∧ ψ ) = FV ( φ ) ∪ FV ( ψ ) , \operatorname{FV}(\neg\varphi)=\operatorname{FV}(\varphi),
\qquad
\operatorname{FV}(\varphi\land\psi)=
\operatorname{FV}(\varphi)\cup\operatorname{FV}(\psi), FV ( ¬ φ ) = FV ( φ ) , FV ( φ ∧ ψ ) = FV ( φ ) ∪ FV ( ψ ) ,
FV ( ∃ x φ ) = FV ( ∀ x φ ) = FV ( φ ) ∖ { x } . \operatorname{FV}(\exists x\,\varphi)
=\operatorname{FV}(\forall x\,\varphi)
=\operatorname{FV}(\varphi)\setminus\{x\}. FV ( ∃ x φ ) = FV ( ∀ x φ ) = FV ( φ ) ∖ { x } .
其他二元联结词同样取两边的并集。没有自由变量的公式叫作句子。
课堂用次序长度的例子说明,变量也能像程序里的局部变量一样被重复使用。在线性序中,“至少有四个元素”最直接写作
∃ x 1 ∃ x 2 ∃ x 3 ∃ x 4 ( x 1 < x 2 ∧ x 2 < x 3 ∧ x 3 < x 4 ) . \exists x_1\exists x_2\exists x_3\exists x_4\,
(x_1<x_2\land x_2<x_3\land x_3<x_4). ∃ x 1 ∃ x 2 ∃ x 3 ∃ x 4 ( x 1 < x 2 ∧ x 2 < x 3 ∧ x 3 < x 4 ) .
但只用两个变量名字也能写:
∃ x ∃ y ( x < y ∧ ∃ x ( y < x ∧ ∃ y ( x < y ) ) ) . \exists x\,\exists y\,
\bigl(x<y\land
\exists x\,(y<x\land\exists y\,(x<y))\bigr). ∃ x ∃ y ( x < y ∧ ∃ x ( y < x ∧ ∃ y ( x < y )) ) .
内层 ∃ x \exists x ∃ x x x x x < y x<y x < y x x x ∃ y \exists y ∃ y y y y
回放 B,38:10。看中间下方:四变量递增链和重复绑定 x、y 的写法。作用域以正文补清的括号为准,重复名字不等于复用同一个自由变量的取值。 一般写公式时,我们建议每次量化都使用一个新的变量名字。除非专门研究“能用几个变量表达”,重复绑定很容易造成误读。改名时也要避免捕获:例如把
∃ x E ( x , y ) \exists x\,E(x,y) ∃ x E ( x , y )
中的束缚变量 x x x z z z ∃ z E ( z , y ) \exists z\,E(z,y) ∃ z E ( z , y ) y y y ∃ y E ( y , y ) \exists y\,E(y,y) ∃ y E ( y , y ) y y y
结构与赋值:公式的真假需要两层信息
给定关系签名 σ \sigma σ σ \sigma σ
A = ( A , ( R A ) R ∈ σ ) , \mathcal A=(A,(R^{\mathcal A})_{R\in\sigma}), A = ( A , ( R A ) R ∈ σ ) ,
本文采用标准约定,A A A k k k
R A ⊆ A k . R^{\mathcal A}\subseteq A^k. R A ⊆ A k .
二元关系是一组有序对,三元关系是一组三元组。零元关系的解释是空元组是否在关系中,从而给出一个真值。域可以有限,也可以无限。相同的签名可以有很多不同结构,它们的域、关系解释都可以不同。
有时我们把结构与它的域都简称为 A A A
如果公式有自由变量,还需要变量赋值
s : Var → A . s:\operatorname{Var}\to A. s : Var → A .
我们写 A , s ⊨ φ \mathcal A,s\models\varphi A , s ⊨ φ A \mathcal A A s s s x < y x<y x < y x , y x,y x , y s ( x ) = 0 , s ( y ) = 1 s(x)=0,s(y)=1 s ( x ) = 0 , s ( y ) = 1
即使最终只关心没有自由变量的句子,递归定义也必须处理带自由变量的公式,因为一个句子的子公式可以有自由变量。比如 ∃ x P ( x ) \exists x\,P(x) ∃ x P ( x ) P ( x ) P(x) P ( x ) x x x
递归定义满足关系
原子公式的语义就是查关系:
A , s ⊨ R ( x 1 , … , x k ) ⟺ ( s ( x 1 ) , … , s ( x k ) ) ∈ R A . \mathcal A,s\models R(x_1,\ldots,x_k)
\quad\Longleftrightarrow\quad
(s(x_1),\ldots,s(x_k))\in R^{\mathcal A}. A , s ⊨ R ( x 1 , … , x k ) ⟺ ( s ( x 1 ) , … , s ( x k )) ∈ R A .
对于等号,
A , s ⊨ x = y ⟺ s ( x ) = s ( y ) . \mathcal A,s\models x=y
\quad\Longleftrightarrow\quad s(x)=s(y). A , s ⊨ x = y ⟺ s ( x ) = s ( y ) .
联结词仍按经典真值解释。例如
A , s ⊨ ¬ φ ⟺ A , s ⊭ φ , \mathcal A,s\models\neg\varphi
\quad\Longleftrightarrow\quad
\mathcal A,s\not\models\varphi, A , s ⊨ ¬ φ ⟺ A , s ⊨ φ ,
A , s ⊨ φ ∧ ψ ⟺ A , s ⊨ φ 且 A , s ⊨ ψ . \mathcal A,s\models\varphi\land\psi
\quad\Longleftrightarrow\quad
\mathcal A,s\models\varphi\ \text{且}\ \mathcal A,s\models\psi. A , s ⊨ φ ∧ ψ ⟺ A , s ⊨ φ 且 A , s ⊨ ψ .
量词的关键是只改变对应变量的值。记 s [ x ↦ a ] s[x\mapsto a] s [ x ↦ a ] s s s x x x a a a
A , s ⊨ ∃ x φ ⟺ ∃ a ∈ A A , s [ x ↦ a ] ⊨ φ , \mathcal A,s\models\exists x\,\varphi
\quad\Longleftrightarrow\quad
\exists a\in A\;\mathcal A,s[x\mapsto a]\models\varphi, A , s ⊨ ∃ x φ ⟺ ∃ a ∈ A A , s [ x ↦ a ] ⊨ φ ,
A , s ⊨ ∀ x φ ⟺ ∀ a ∈ A A , s [ x ↦ a ] ⊨ φ . \mathcal A,s\models\forall x\,\varphi
\quad\Longleftrightarrow\quad
\forall a\in A\;\mathcal A,s[x\mapsto a]\models\varphi. A , s ⊨ ∀ x φ ⟺ ∀ a ∈ A A , s [ x ↦ a ] ⊨ φ .
因此判断 ∀ x ∃ y ( x < y ) \forall x\exists y\,(x<y) ∀ x ∃ y ( x < y ) x x x y y y y y y x x x ∃ y ∀ x ( x < y ) \exists y\forall x\,(x<y) ∃ y ∀ x ( x < y )
公式的真假只取决于自由变量的赋值:若 s , t s,t s , t FV ( φ ) \operatorname{FV}(\varphi) FV ( φ )
A , s ⊨ φ ⟺ A , t ⊨ φ . \mathcal A,s\models\varphi
\quad\Longleftrightarrow\quad
\mathcal A,t\models\varphi. A , s ⊨ φ ⟺ A , t ⊨ φ .
这可以对公式构造作归纳验证;量词步骤正是利用“更新被绑定变量后,两个赋值在子公式剩余的自由变量上一致”。所以句子的真假与赋值无关,我们可以直接写 A ⊨ φ \mathcal A\models\varphi A ⊨ φ
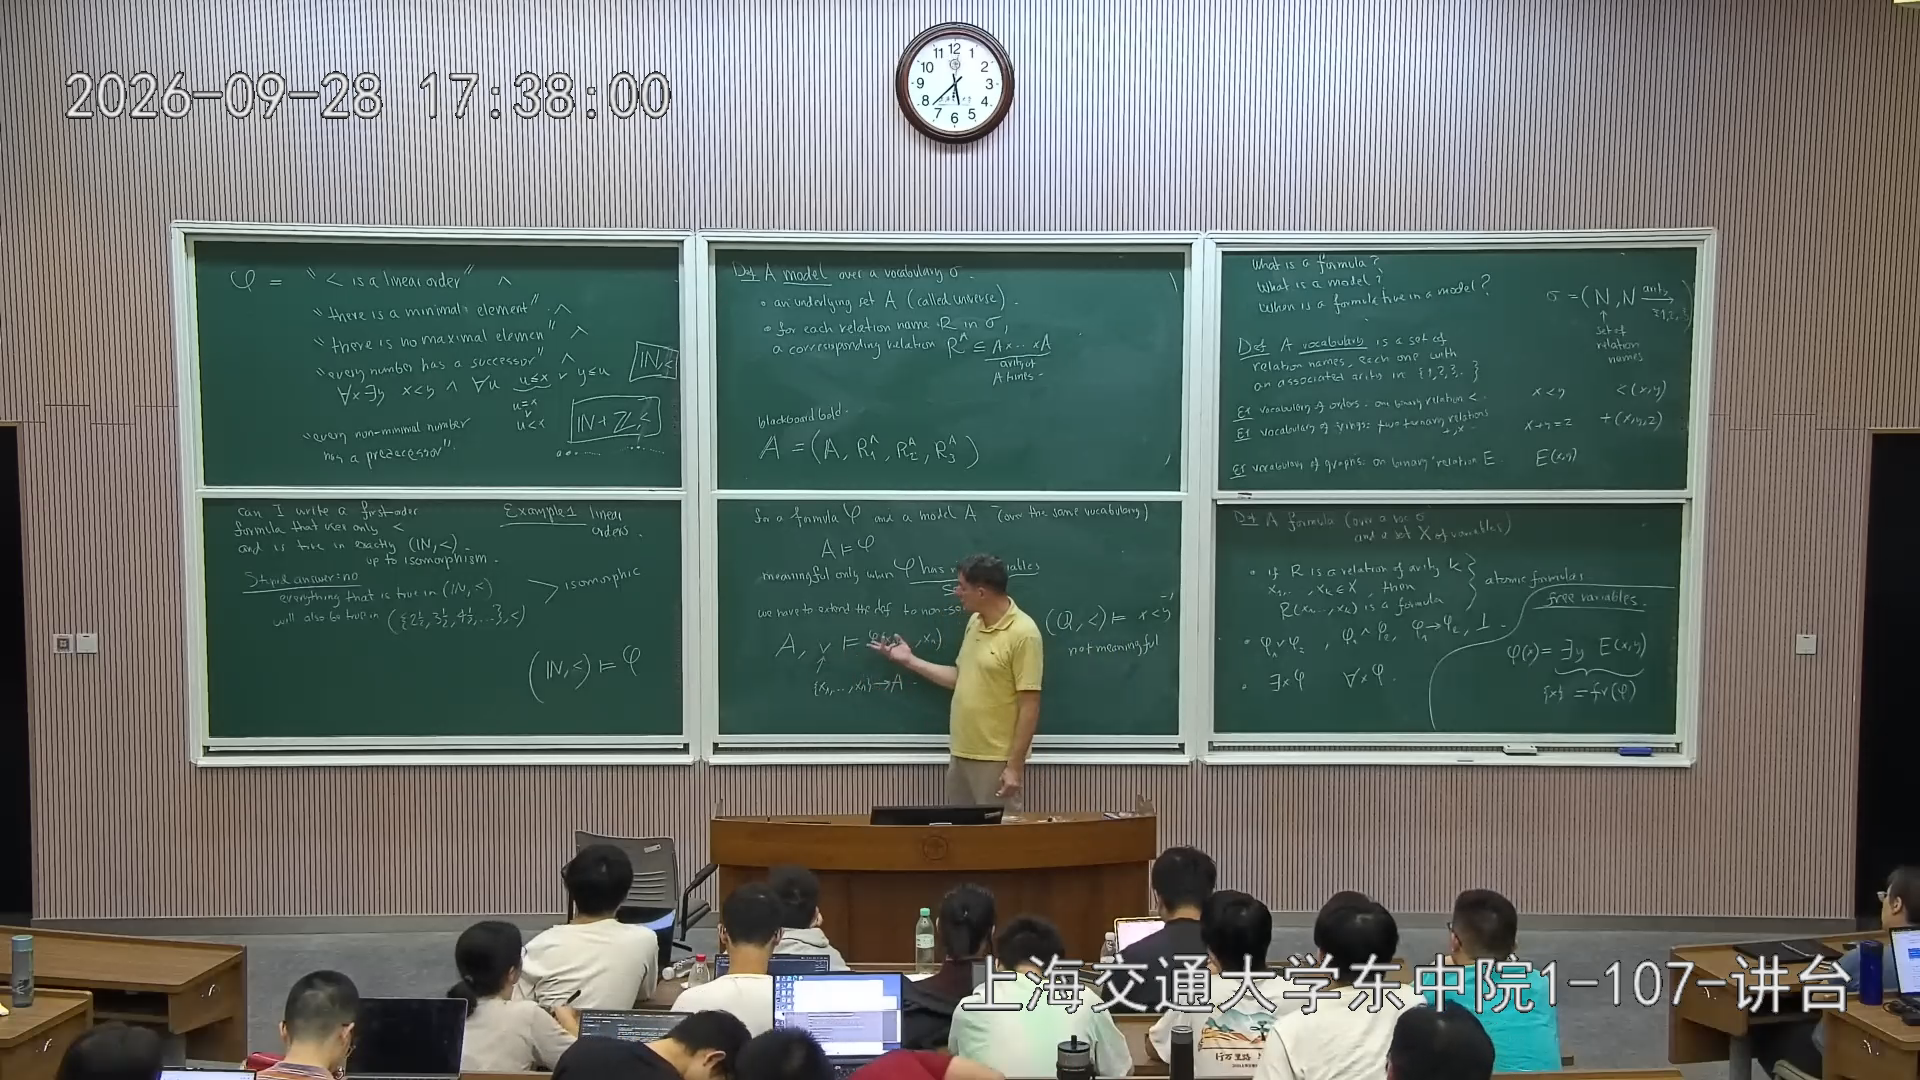
回放 B,47:40。看中间的结构域与关系解释、右侧的签名和公式语法;中间下方区分句子与带自由变量公式的满足关系。等号和非空域按正文注明的整理约定处理。 “在一个模型里真”与“逻辑上真”
最后把两个层次再分开。给定一个结构,我们已经知道量词在它的域中遍历。若说一个句子逻辑有效,则还要求它在同一签名的所有结构中都真:
⊨ φ ⟺ 对每个非空 σ -结构 A , A ⊨ φ . \models\varphi
\quad\Longleftrightarrow\quad
\text{对每个非空 }\sigma\text{-结构 }\mathcal A,
\ \mathcal A\models\varphi. ⊨ φ ⟺ 对每个非空 σ - 结构 A , A ⊨ φ .
而可满足是说至少有一个这样的结构使它为真。不存在模型则是不可满足。最开始的存在到存在推理,可以写成一个有效句子:
( ∃ x P ( x ) ∧ ∀ x ( P ( x ) → Q ( x ) ) ) → ∃ x Q ( x ) . \bigl(\exists x\,P(x)\land
\forall x\,(P(x)\to Q(x))\bigr)
\to\exists x\,Q(x). ( ∃ x P ( x ) ∧ ∀ x ( P ( x ) → Q ( x )) ) → ∃ x Q ( x ) .
我们不需要先指定对象是数字、顶点还是其他东西;任何结构中,只要前提真,就能取到一个 P P P Q Q Q
这也回答了课堂中的一个疑问:一阶逻辑与命题逻辑之间,并不是“把真值改成自然数”就结束了。一阶逻辑有两层选择:先指定结构,再在结构里选择变量值。若我们固定域为 { 0 , 1 } \{0,1\} { 0 , 1 }
从计算的角度看,“输入一个公式,问是否存在一个模型”和“固定一个结构,问公式在它里面是否为真”是不同问题。任意模型可以无限,甚至根本无法逐个枚举。
课堂最后明确提出三个问题,前两个回答“NO”,第三个回答“YES”:
输入任意关系签名上的一个一阶句子 φ \varphi φ A \mathcal A A A ⊨ φ \mathcal A\models\varphi A ⊨ φ
输入加法、乘法语言中的一个句子 φ \varphi φ ( Z , + , × ) (\mathbb Z,+,\times) ( Z , + , × )
输入同样使用加法、乘法的一阶句子 φ \varphi φ ( R , + , × ) (\mathbb R,+,\times) ( R , + , × )
这里的算法问题要求句子具有有限、可有效读取的表示。加法、乘法语言若加入逻辑等号、0 , 1 0,1 0 , 1
这三个结论的证明与算法留到后续课程。固定结构本身不是一个保证可判定的条件;结构中有哪些关系、这些关系有多强,同样重要。
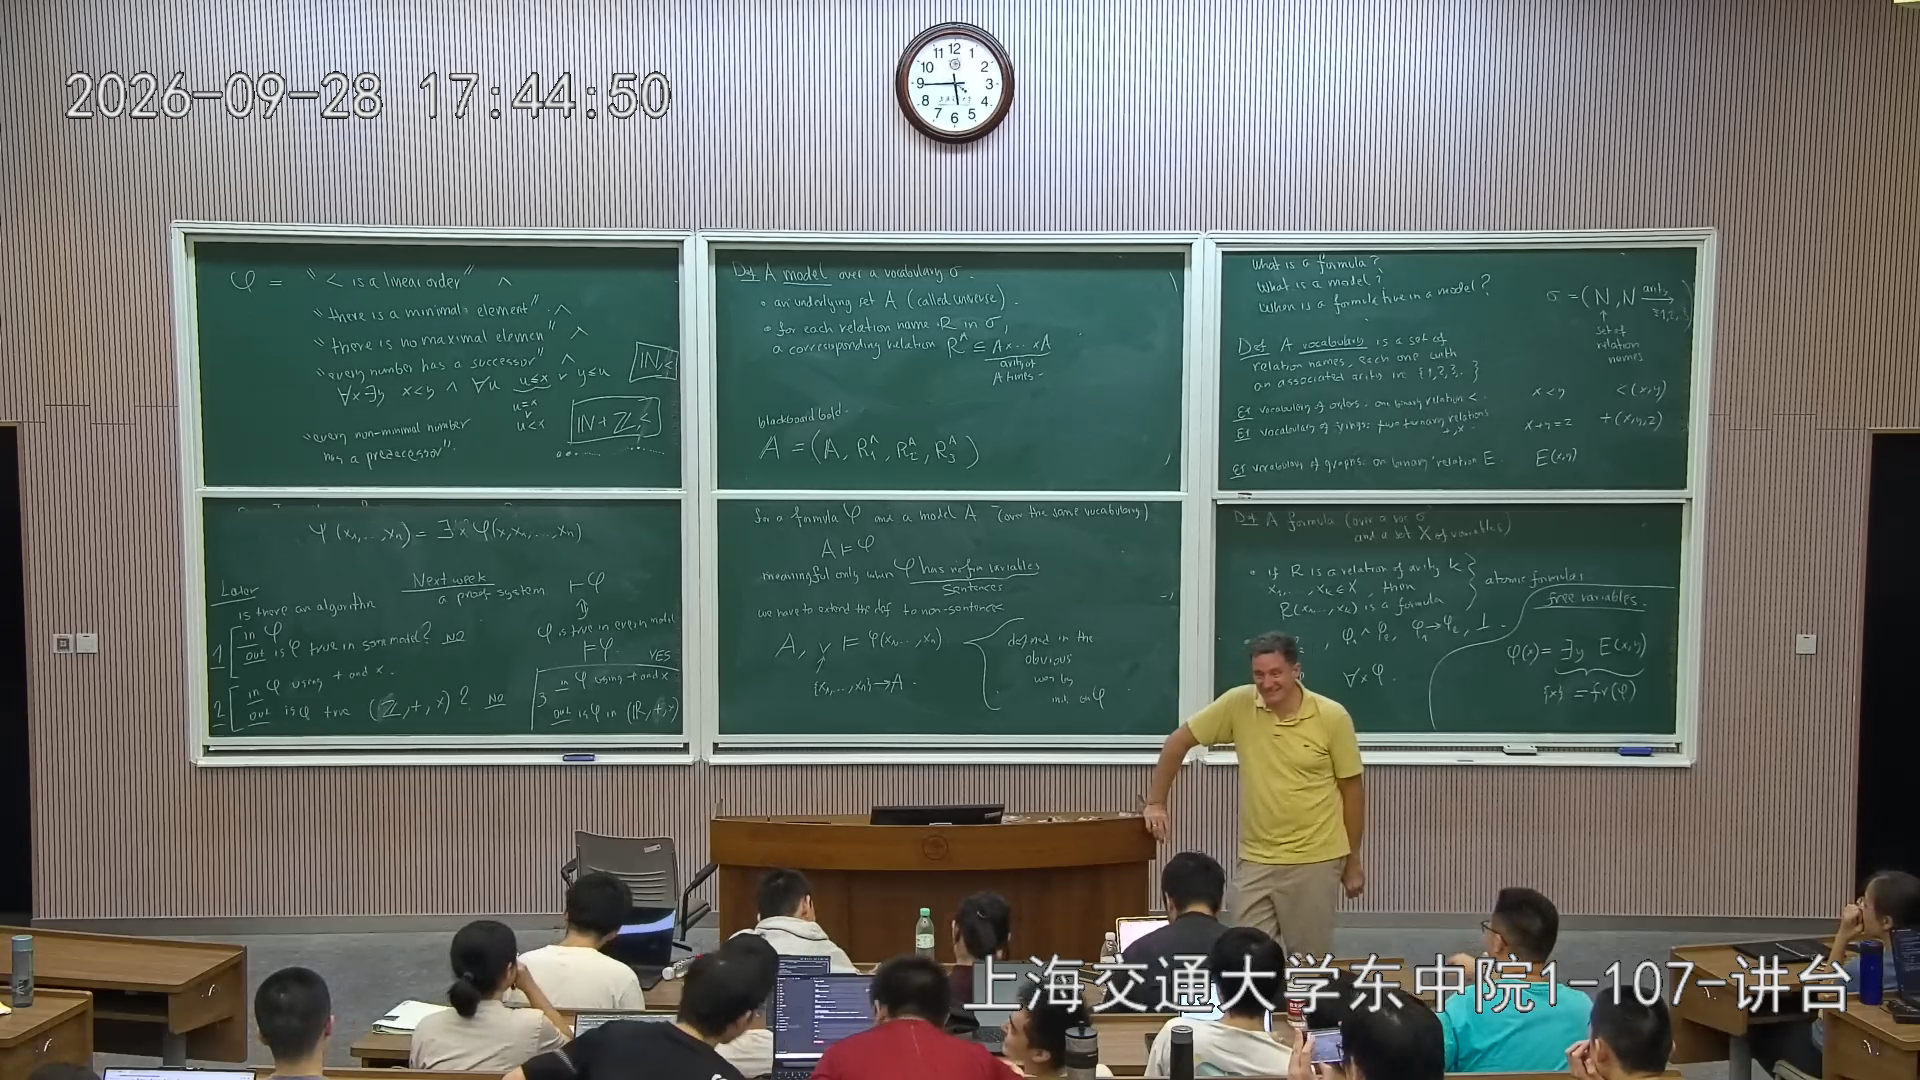
回放 B,54:30。看左下:一般一阶句子是否有模型、整数加乘结构中的真、实数加乘结构中的真,课堂分别标为 NO、NO、YES;当天只陈述结论,没有给出这些判定结果的证明或算法。 学习与考核提示
学习时,我们要能解释定义、重建证明,并面对追问给出例子或反例。课堂说明拟以口试作为主要考核方式,问题列表会事先提供,未成功时可再约时间;作业的主要目的仍是帮助自己学会材料。具体权重、时间和细则在当天还没有完全确定,应以之后的正式通知为准。
来源与补全说明
依据 2026 年 9 月 28 日两段完整转写与既有回放帧整理,时间均为段内时间。关系编码、自由变量递归和避免捕获示例补齐了步骤;逻辑等号与非空域采用整理约定。序的一阶等价、图的不可表达性及末尾判定问题的完整证明留待后课。未取得可确认的配套讲义原件。